

Eksploracyjna analiza czynnikowa – przykład i interpretacja
Ten wpis prowadzi przez eksploracyjną analizę czynnikową (EFA) krok po kroku: od sprawdzenia, czy dane się do niej nadają, przez wybór liczby czynników i rotację, po tabelę ładunków i opis do pracy. Typowe pytanie: czy sześć pytań z mojej ankiety mierzy dwie różne rzeczy – stres przed sesją i motywację do nauki?
W skrócieKMO i test Bartletta → liczba czynników (wykres osypiska, analiza równoległa) → ekstrakcja i rotacja → ładunki → opis w stylu APA. EFA zakłada, że za korelacjami pytań stoją ukryte cechy – czynniki. Analiza głównych składowych (PCA) tylko streszcza dane i nie jest tą samą metodą.
Krok 1. Pytanie badawcze i dane
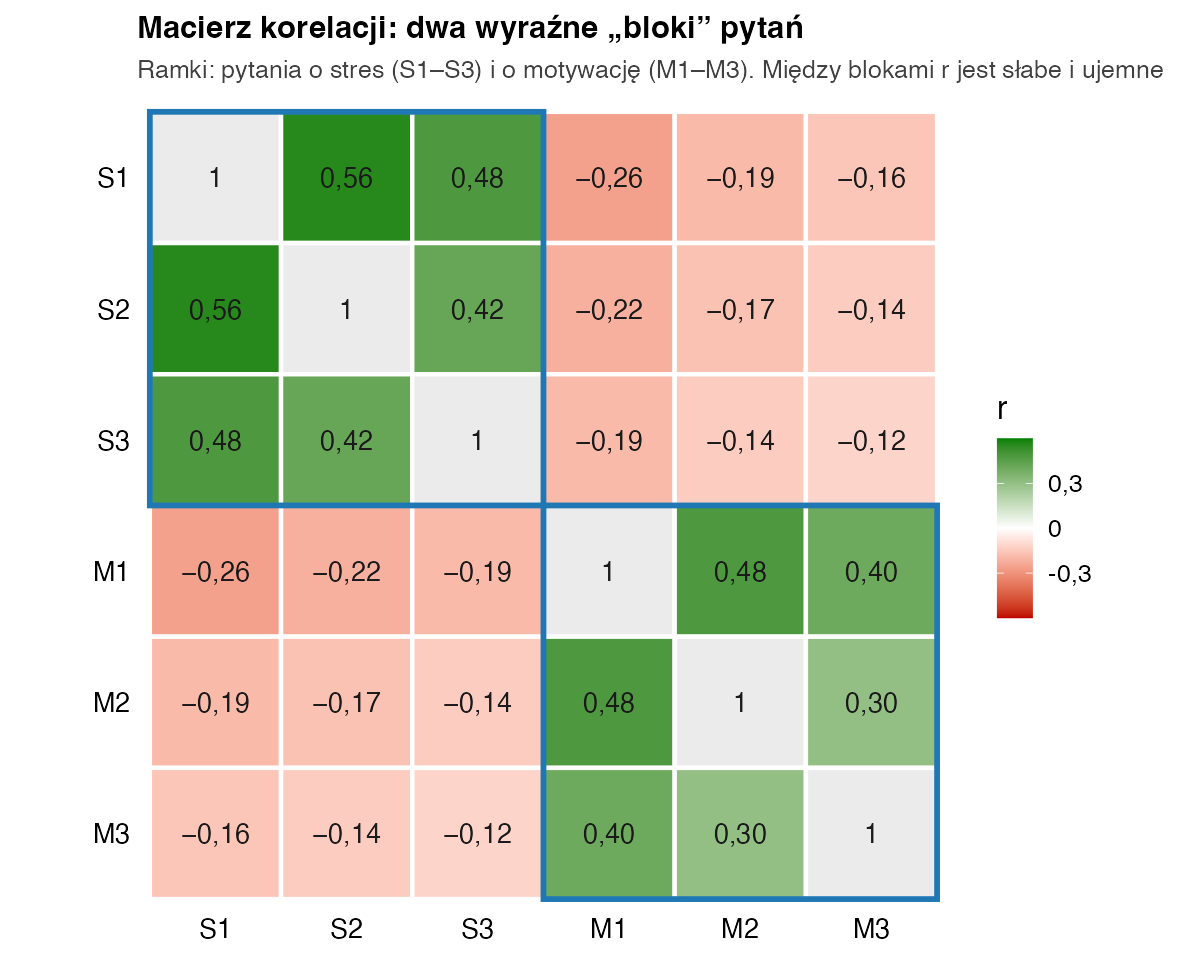
Dwieście osób oceniło sześć zdań na skali 1–5: S1 „Przed sesją źle śpię”, S2 „Myśl o egzaminie mnie paraliżuje”, S3 „Przed kolokwium czuję napięcie”, M1 „Lubię uczyć się do tego przedmiotu”, M2 „Chętnie poświęcam czas na naukę” i M3 „Uczę się także wtedy, gdy nie ma kolokwium”. EFA nie testuje hipotezy o różnicy – szuka struktury. Do obliczeń wystarczy jej wejście: macierz korelacji Pearsona i liczba osób.
| S1 | S2 | S3 | M1 | M2 | M3 | |
|---|---|---|---|---|---|---|
| S1 | 1 | 0,56 | 0,48 | −0,26 | −0,19 | −0,16 |
| S2 | 0,56 | 1 | 0,42 | −0,22 | −0,17 | −0,14 |
| S3 | 0,48 | 0,42 | 1 | −0,19 | −0,14 | −0,12 |
| M1 | −0,26 | −0,22 | −0,19 | 1 | 0,48 | 0,40 |
| M2 | −0,19 | −0,17 | −0,14 | 0,48 | 1 | 0,30 |
| M3 | −0,16 | −0,14 | −0,12 | 0,40 | 0,30 | 1 |
Krok 2. Czy dane nadają się do analizy czynnikowej?
- Miara KMO = 0,72. Kaiser (1974) nazywa wartości 0,70–0,79 „średnimi”, a poniżej 0,50 uznaje za nie do przyjęcia.
- Test sferyczności Bartletta: χ²(15) = 241,40; p < 0,001.
- Liczebność. Według MacCallum i in. (1999) przy zasobach wspólnych około 0,5 i dobrze określonych czynnikach wystarcza 100–200 osób, ale przy niższych zasobach i tylko trzech–czterech pytaniach na czynnik – raczej 300. Nasz przykład (h² od 0,25 do 0,64, trzy pytania na czynnik, 200 osób) jest na granicy.
Krok 3. Ile czynników?
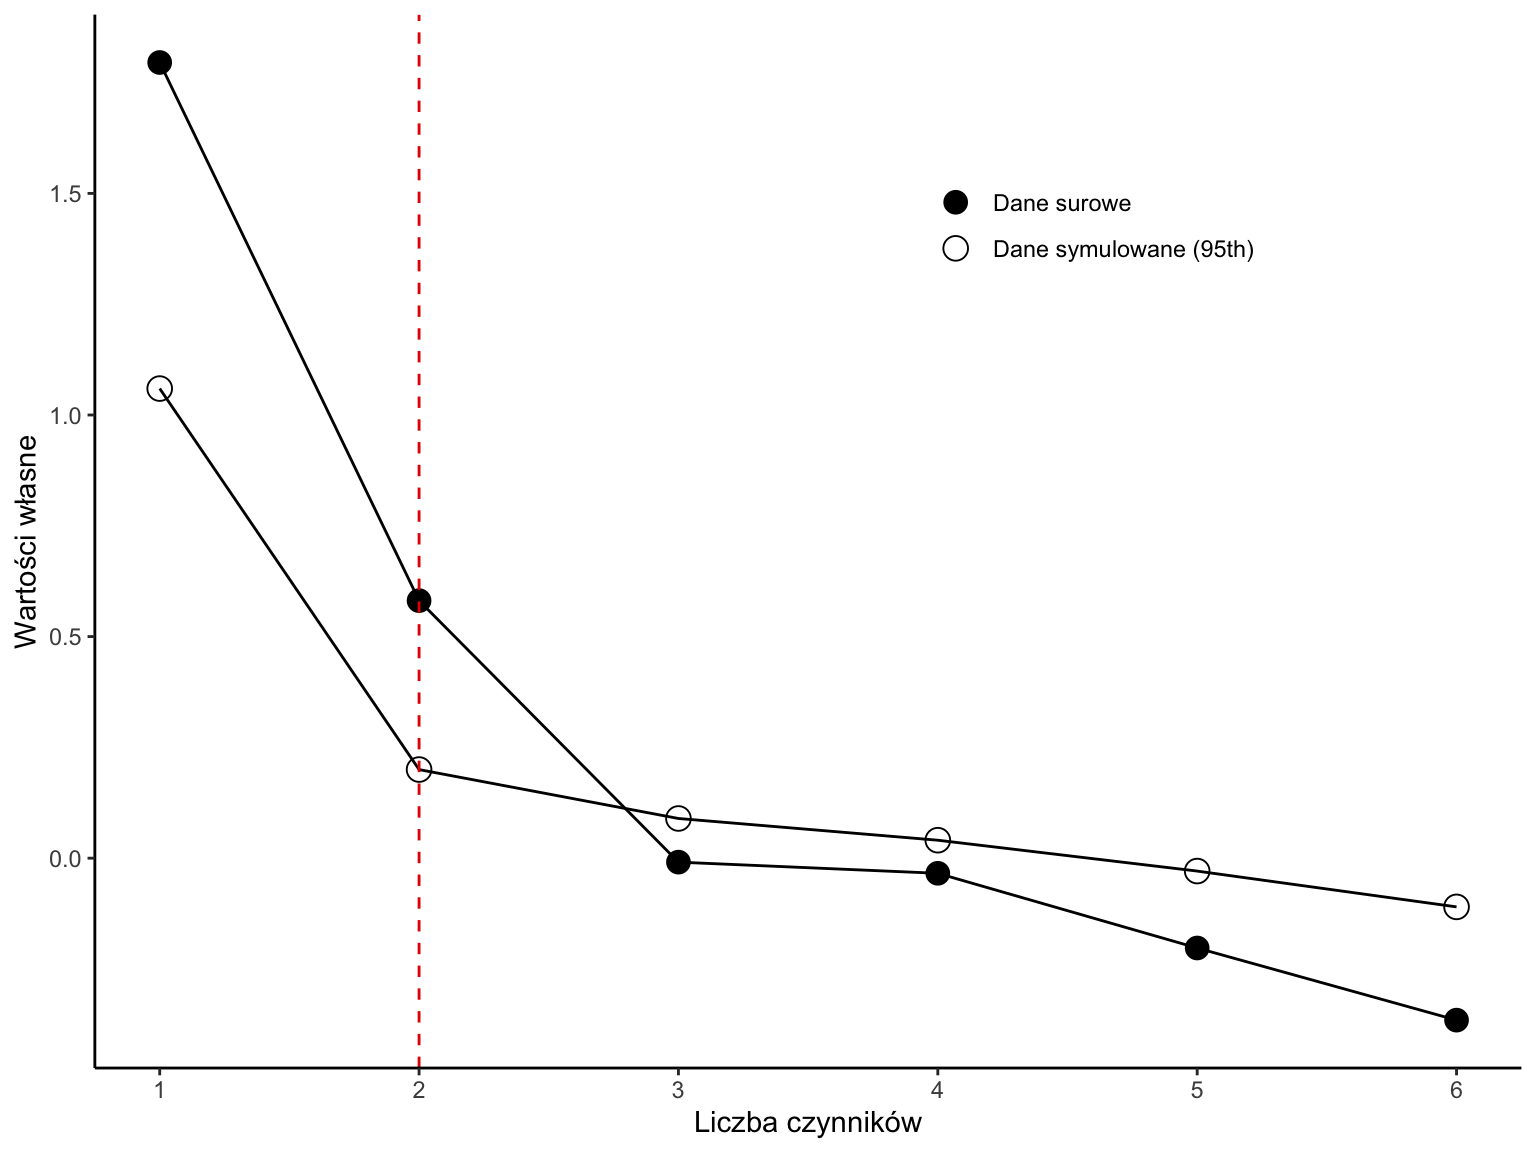
Wartości własne macierzy korelacji wynoszą 2,43; 1,34; 0,71; 0,59; 0,50 i 0,43. Kryterium Kaisera (wartość własna > 1) i „łokieć” na wykresie osypiska wskazują dwa czynniki. Dokładniejsza jest analiza równoległa (Horn, 1965): zostawiamy tyle czynników, ile wartości własnych przewyższa wartości z danych losowych. Tu też dwa.
Krok 4. Ekstrakcja, rotacja i ładunki
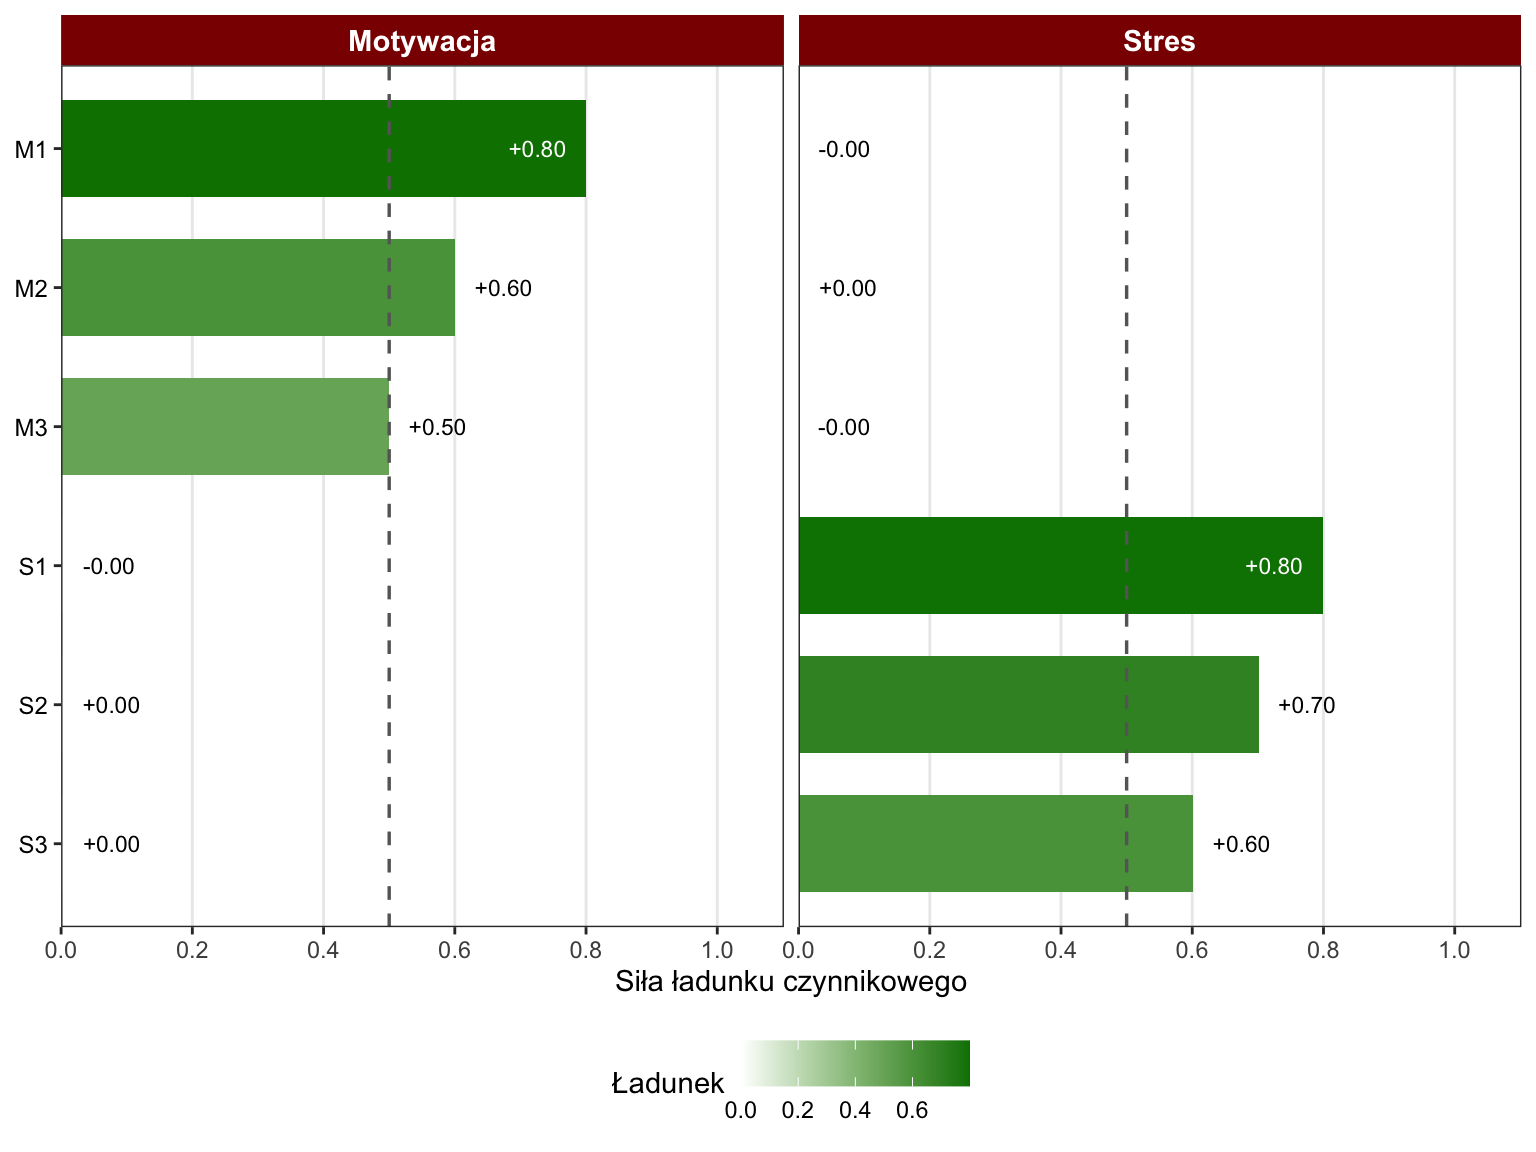
Czynniki wyodrębniamy metodą największej wiarygodności (ML). Przy rozkładach wyraźnie odbiegających od normalnego lepsza jest metoda osi głównych (Fabrigar i in., 1999). Potem obracamy rozwiązanie rotacją oblimin. Dąży ona do prostej struktury, czyli takiej, w której każde pytanie ładuje głównie jeden czynnik. Pozwala też czynnikom korelować. Varimax zakłada czynniki nieskorelowane, a stres i motywacja raczej się wiążą. Tu korelacja czynników wynosi r = −0,40.
| Pytanie | Stres przed sesją | Motywacja do nauki | h² |
|---|---|---|---|
| S1. Przed sesją źle śpię | 0,80 | 0,00 | 0,64 |
| S2. Myśl o egzaminie mnie paraliżuje | 0,70 | 0,00 | 0,49 |
| S3. Przed kolokwium czuję napięcie | 0,60 | 0,00 | 0,36 |
| M1. Lubię uczyć się do tego przedmiotu | 0,00 | 0,80 | 0,64 |
| M2. Chętnie poświęcam czas na naukę | 0,00 | 0,60 | 0,36 |
| M3. Uczę się także wtedy, gdy nie ma kolokwium | 0,00 | 0,50 | 0,25 |
| Wyjaśniona wariancja pytań | łącznie 45,7%; korelacja czynników r = −0,40 | ||
Ładunek to siła związku pytania z czynnikiem, a h² (zasób wspólny) – część wariancji pytania wyjaśniona przez czynniki. Za wyraźny uznaje się zwykle ładunek od 0,32 w górę (Tabachnick i Fidell, 2013). Wszystkie pytania spełniają ten warunek, a ładunki krzyżowe są bliskie zera.
Krok 5. Jak opisać wynik w pracy?
Zapis w stylu APA: Strukturę sześciu pytań zbadano eksploracyjną analizą czynnikową metodą największej wiarygodności z rotacją oblimin (N = 200). Dane nadawały się do analizy: KMO = 0,72; test Bartletta χ²(15) = 241,40; p < 0,001. Wykres osypiska i analiza równoległa wskazały dwa czynniki, które łącznie wyjaśniały 45,7% wariancji pytań. Pytania S1–S3 ładowały czynnik Stres przed sesją (0,60–0,80), a M1–M3 – czynnik Motywacja do nauki (0,50–0,80). Czynniki korelowały ujemnie, r = −0,40.
Pod tabelą dodaj notę o metodzie ekstrakcji i rotacji. W pełnym raporcie podaje się też wykres osypiska – zobacz przykładowy raport analizy czynnikowej.
EFA czy PCA – czym się różnią?
| EFA | PCA | |
|---|---|---|
| Cel | wyjaśnić korelacje pytań ukrytymi cechami | streścić wiele zmiennych w kilku składowych |
| Co analizuje | tylko wariancję wspólną pytań | całą wariancję, razem z błędem pomiaru |
| Ładunki | realistyczne | zawyżone, zwłaszcza dla słabych pytań |
| Kiedy | budowa i sprawdzanie skal kwestionariusza | redukcja liczby zmiennych, np. przed regresją |
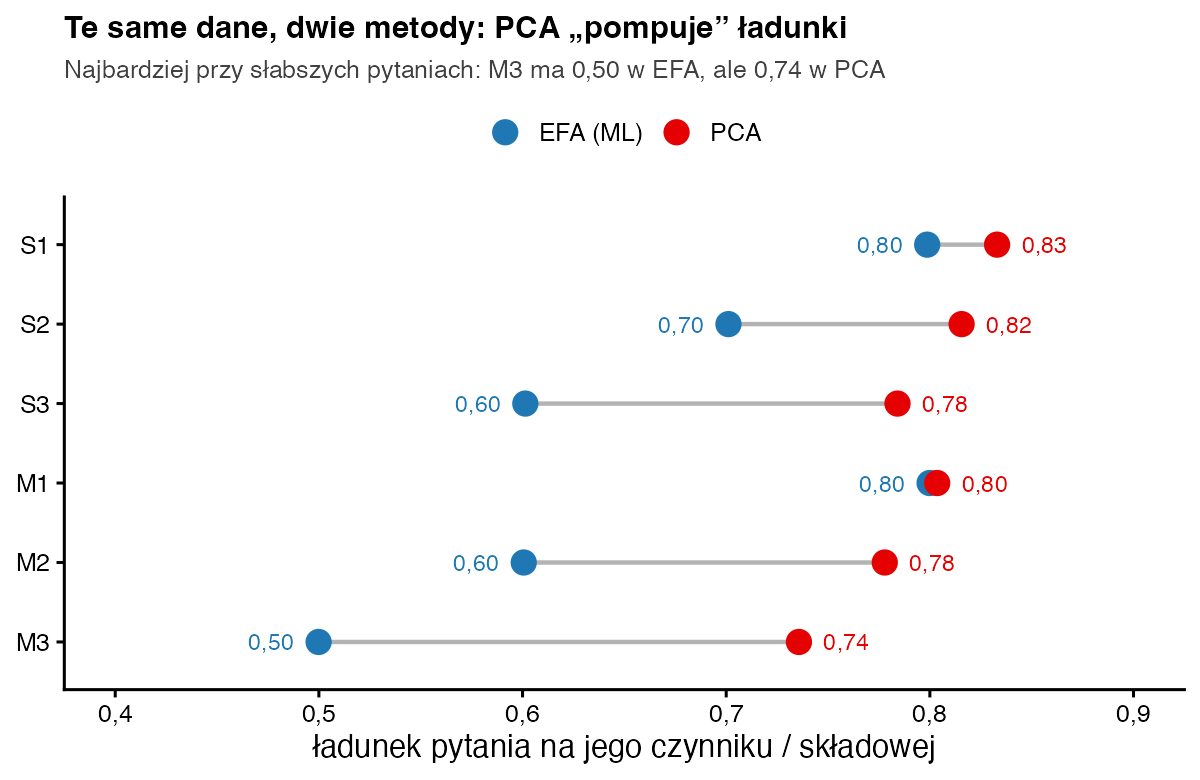
Moduł analizy czynnikowej w SZTOS domyślnie liczy główne składowe. Do EFA przełącz metodę na ML, osie główne lub minres – tak powstały rysunki 2 i 3. Kiedy PCA jest właściwym wyborem, pokazujemy we wpisie analiza PCA – przykład.
Cała analiza w R
library(psych)
# Macierz korelacji 6 pytań (n = 200): S1–S3 stres przed sesją, M1–M3 motywacja do nauki
p <- c("S1", "S2", "S3", "M1", "M2", "M3")
R <- matrix(c( 1.00,  0.56,  0.48, -0.26, -0.19, -0.16,
               0.56,  1.00,  0.42, -0.22, -0.17, -0.14,
               0.48,  0.42,  1.00, -0.19, -0.14, -0.12,
              -0.26, -0.22, -0.19,  1.00,  0.48,  0.40,
              -0.19, -0.17, -0.14,  0.48,  1.00,  0.30,
              -0.16, -0.14, -0.12,  0.40,  0.30,  1.00), 6, dimnames = list(p, p))

# 1) czy dane nadają się do EFA? KMO i test sferyczności Bartletta
round(KMO(R)$MSA, 2)
round(unlist(cortest.bartlett(R, n = 200)), 3)   # chi-kwadrat, p, df

# 2) ile czynników? wartości własne i analiza równoległa
round(eigen(R)$values, 2)
set.seed(2026)
fa.parallel(R, n.obs = 200, fm = "ml", fa = "fa", plot = FALSE)$nfact

# 3) EFA: metoda największej wiarygodności (ML), rotacja oblimin
efa <- fa(R, nfactors = 2, n.obs = 200, fm = "ml", rotate = "oblimin")
L <- unclass(efa$loadings); colnames(L) <- c("Stres", "Motywacja")
round(cbind(L, h2 = efa$communality), 2)    # ładunki i zasoby wspólne
round(efa$Phi[1, 2], 2)                     # korelacja czynników

# 4) dla porównania: PCA na tych samych danych zawyża ładunki
round(unclass(principal(R, nfactors = 2, rotate = "oblimin")$loadings), 2)
Wynik w konsoli R:
[1] 0.72
  chisq p.value      df
  241.4     0.0    15.0
[1] 2.43 1.34 0.71 0.59 0.50 0.43
Parallel analysis suggests that the number of factors =  2  and the number of components =  NA
[1] 2
   Stres Motywacja   h2
S1   0.8       0.0 0.64
S2   0.7       0.0 0.49
S3   0.6       0.0 0.36
M1   0.0       0.8 0.64
M2   0.0       0.6 0.36
M3   0.0       0.5 0.25
[1] -0.4
     PC1   PC2
S1  0.83 -0.04
S2  0.82  0.00
S3  0.78  0.04
M1 -0.06  0.80
M2  0.02  0.78
M3  0.05  0.74
Pytania promotora i recenzenta
Czy usunąć M3, skoro ładunek wynosi tylko 0,50?
Nie musisz. Ładunek 0,50 jest wyraźny, choć czynnik wyjaśnia tylko 25% wariancji tego pytania. Decyzję oprzyj na treści pytania i na rzetelności skali, a nie na samym progu.
Czy EFA potwierdza trafność kwestionariusza?
Nie. EFA jest eksploracyjna. Strukturę potwierdza się konfirmacyjną analizą czynnikową (CFA) na nowej próbie. Gdy skale wchodzą potem do modelu ścieżek, model pomiarowy ocenia się też w PLS-SEM.
Co zrobić z czynnikami dalej?
Dla każdej skali policz rzetelność osobno – alfę Cronbacha albo omegę McDonalda – a wynik skali jako średnią jej pytań.
Najczęstsze błędy
- Nazywanie PCA analizą czynnikową i interpretowanie składowych jak ukrytych cech.
- Wybór liczby czynników tylko według kryterium Kaisera.
- Rotacja varimax „z przyzwyczajenia”, gdy czynniki mogą być skorelowane.
- Analiza na kilkudziesięciu osobach i słabych pytaniach.
- Brak informacji o metodzie ekstrakcji, rotacji i liczbie osób.
Bibliografia
- Fabrigar, L. R., Wegener, D. T., MacCallum, R. C., & Strahan, E. J. (1999). Evaluating the use of exploratory factor analysis in psychological research. Psychological Methods, 4(3), 272–299. https://doi.org/10.1037/1082-989X.4.3.272
- Horn, J. L. (1965). A rationale and test for the number of factors in factor analysis. Psychometrika, 30(2), 179–185. https://doi.org/10.1007/BF02289447
- Kaiser, H. F. (1974). An index of factorial simplicity. Psychometrika, 39(1), 31–36. https://doi.org/10.1007/BF02291575
- MacCallum, R. C., Widaman, K. F., Zhang, S., & Hong, S. (1999). Sample size in factor analysis. Psychological Methods, 4(1), 84–99. https://doi.org/10.1037/1082-989X.4.1.84
- Tabachnick, B. G., & Fidell, L. S. (2013). Using multivariate statistics (6th ed.). Pearson.
- Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikAnaliza PCA – przykład
- Słownik wzorówAlfa Cronbacha
- Słownik wzorówOmega McDonalda
- PoradnikModelowanie PLS-SEM
- PoradnikAlfa Cronbacha – przykład
- Przykładowy raportAnaliza czynnikowa
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.