

Analiza głównych składowych (PCA) – przykład i interpretacja
Analiza głównych składowych (ang. principal component analysis, PCA) zastępuje kilka skorelowanych zmiennych jedną lub kilkoma nowymi zmiennymi – składowymi – tracąc jak najmniej informacji. Typowe pytanie z pracy dyplomowej: czy godziny nauki, obecności, punkty i czas w telefonie mogę zamienić na jeden wskaźnik zaangażowania?
W skróciePCA służy do redukcji wymiaru, a nie do odkrywania ukrytych cech. Kroki: standaryzacja → wartości własne i procent wariancji → liczba składowych → ładunki → wynik składowej dla każdej osoby. Jeśli chcesz sprawdzić, jakie cechy mierzy kwestionariusz, potrzebujesz analizy czynnikowej (EFA).
Krok 1. Cel i dane
Dziesięcioro studentów podało cztery informacje. Chcesz użyć ich jako jednego predyktora w regresji, np. wyniku egzaminu końcowego (nie kolokwium, które jest już w indeksie), bo cztery silnie skorelowane zmienne grożą współliniowością (tu VIF sięga 3,08). PCA nie testuje hipotezy – to metoda opisowa, która przekształca dane.
| Osoba | Nauka (godz./tydz.) | Obecności (na 10) | Kolokwium (0–20) | Telefon (min/dzień) | Wynik PC1 |
|---|---|---|---|---|---|
| 1 | 3 | 4 | 3 | 240 | −3,30 |
| 2 | 9 | 10 | 18 | 130 | 2,35 |
| 3 | 4 | 9 | 10 | 230 | −0,79 |
| 4 | 11 | 9 | 13 | 180 | 1,43 |
| 5 | 5 | 7 | 9 | 250 | −1,42 |
| 6 | 8 | 7 | 14 | 160 | 0,58 |
| 7 | 6 | 6 | 12 | 160 | −0,34 |
| 8 | 7 | 8 | 15 | 80 | 1,47 |
| 9 | 4 | 6 | 14 | 230 | −1,10 |
| 10 | 8 | 8 | 16 | 160 | 1,10 |
| M (SD) | 6,50 (2,55) | 7,40 (1,78) | 12,40 (4,25) | 182,00 (54,93) | 0,00 (1,70) |
Krok 2. Standaryzacja
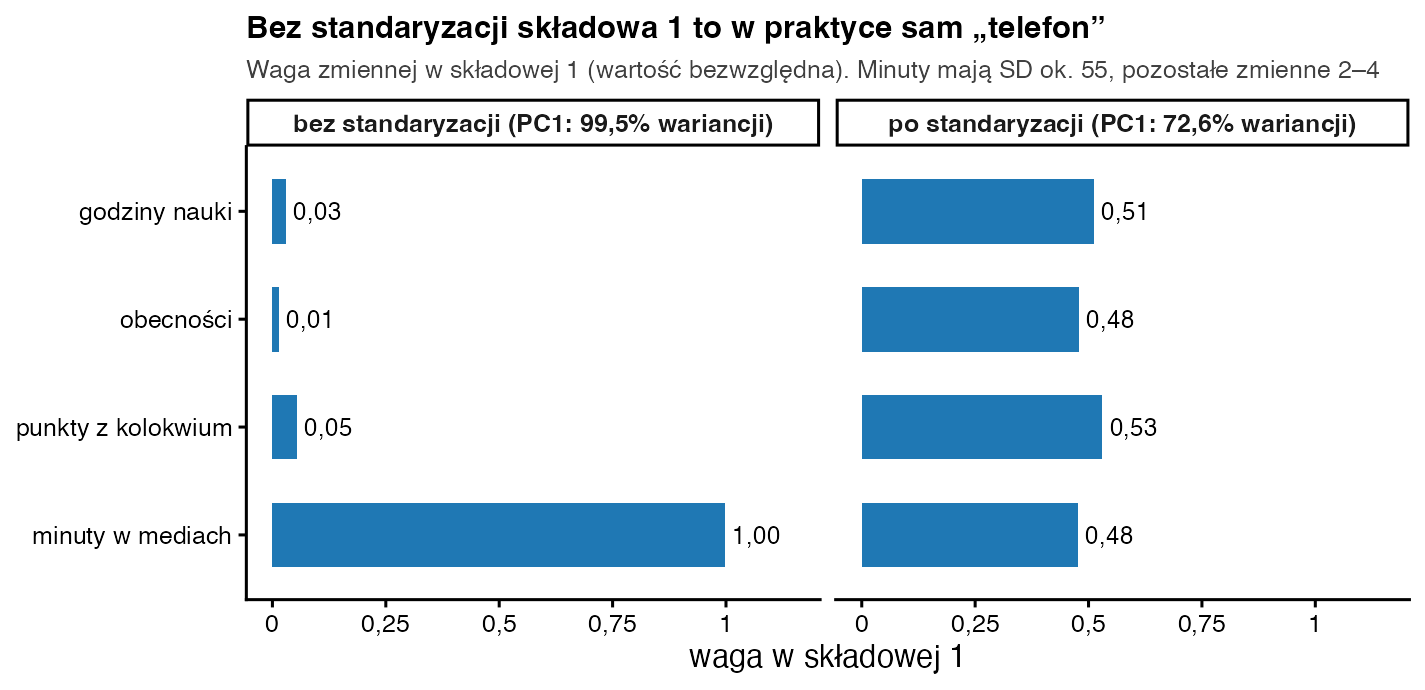
PCA szuka kierunku, w którym dane najbardziej się rozrzucają. Telefon mierzony w minutach ma odchylenie standardowe około 55, a pozostałe zmienne – od 2 do 4. Bez standaryzacji pierwsza składowa wyjaśnia 99,5% wariancji, ale to po prostu „telefon”. Dlatego zmienne w różnych jednostkach zamieniamy na wyniki z (średnia 0, SD 1). To samo daje PCA liczona na macierzy korelacji.
Krok 3. Wartości własne i liczba składowych
Wartość własna to wariancja składowej. Przy czterech standaryzowanych zmiennych suma wariancji wynosi 4, więc procent to wartość własna podzielona przez 4.
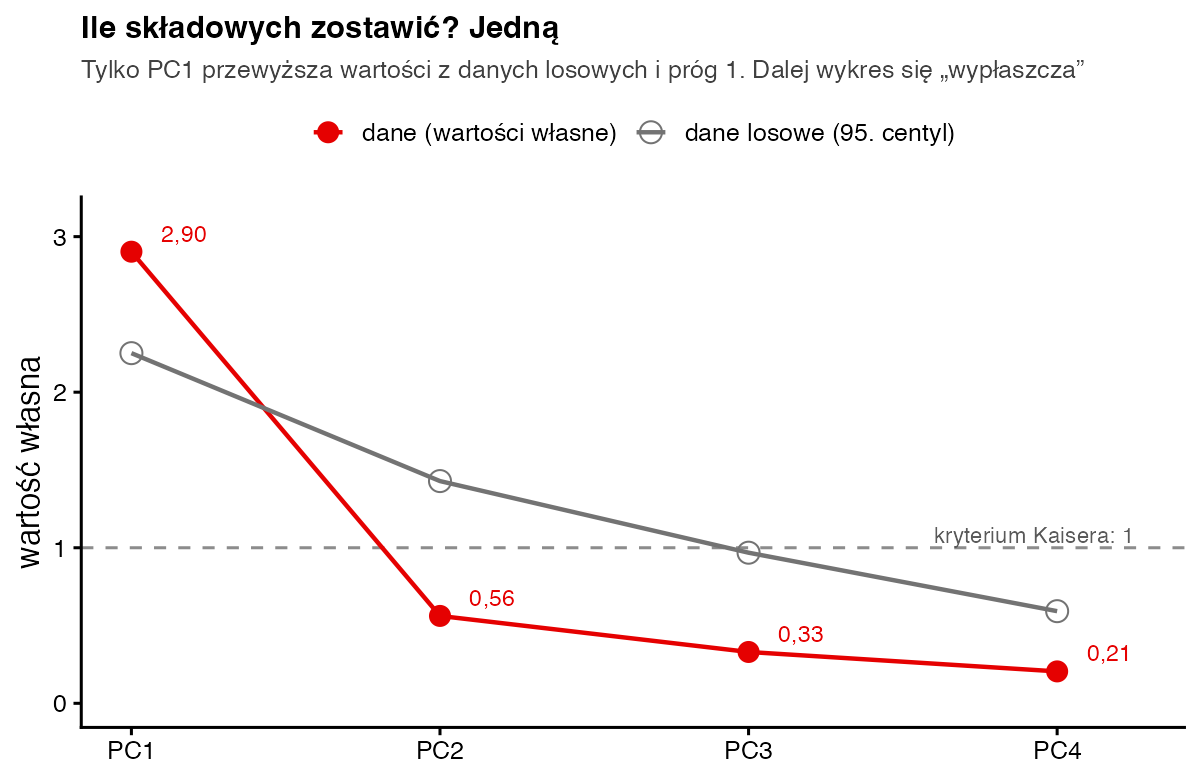
- Wartości własne: 2,90; 0,56; 0,33; 0,21, czyli 72,6%, 14,0%, 8,2% i 5,1% wariancji.
- Kryterium Kaisera (wartość własna > 1): jedna składowa. Ta reguła bywa zawodna, więc sprawdź też inne kryteria.
- Wykres osypiska: po PC1 linia się wypłaszcza.
- Analiza równoległa (Horn, 1965): tylko PC1 przewyższa 95. centyl wartości z danych losowych (2,90 wobec 2,25).
Wiele programów, także SZTOS, podaje przy PCA miarę KMO i test Bartletta. Tu KMO = 0,75, a test Bartletta jest istotny, χ²(6) = 15,06; p = 0,020 – zmienne są skorelowane, więc jest co streszczać.
Krok 4. Ładunki i nazwa składowej
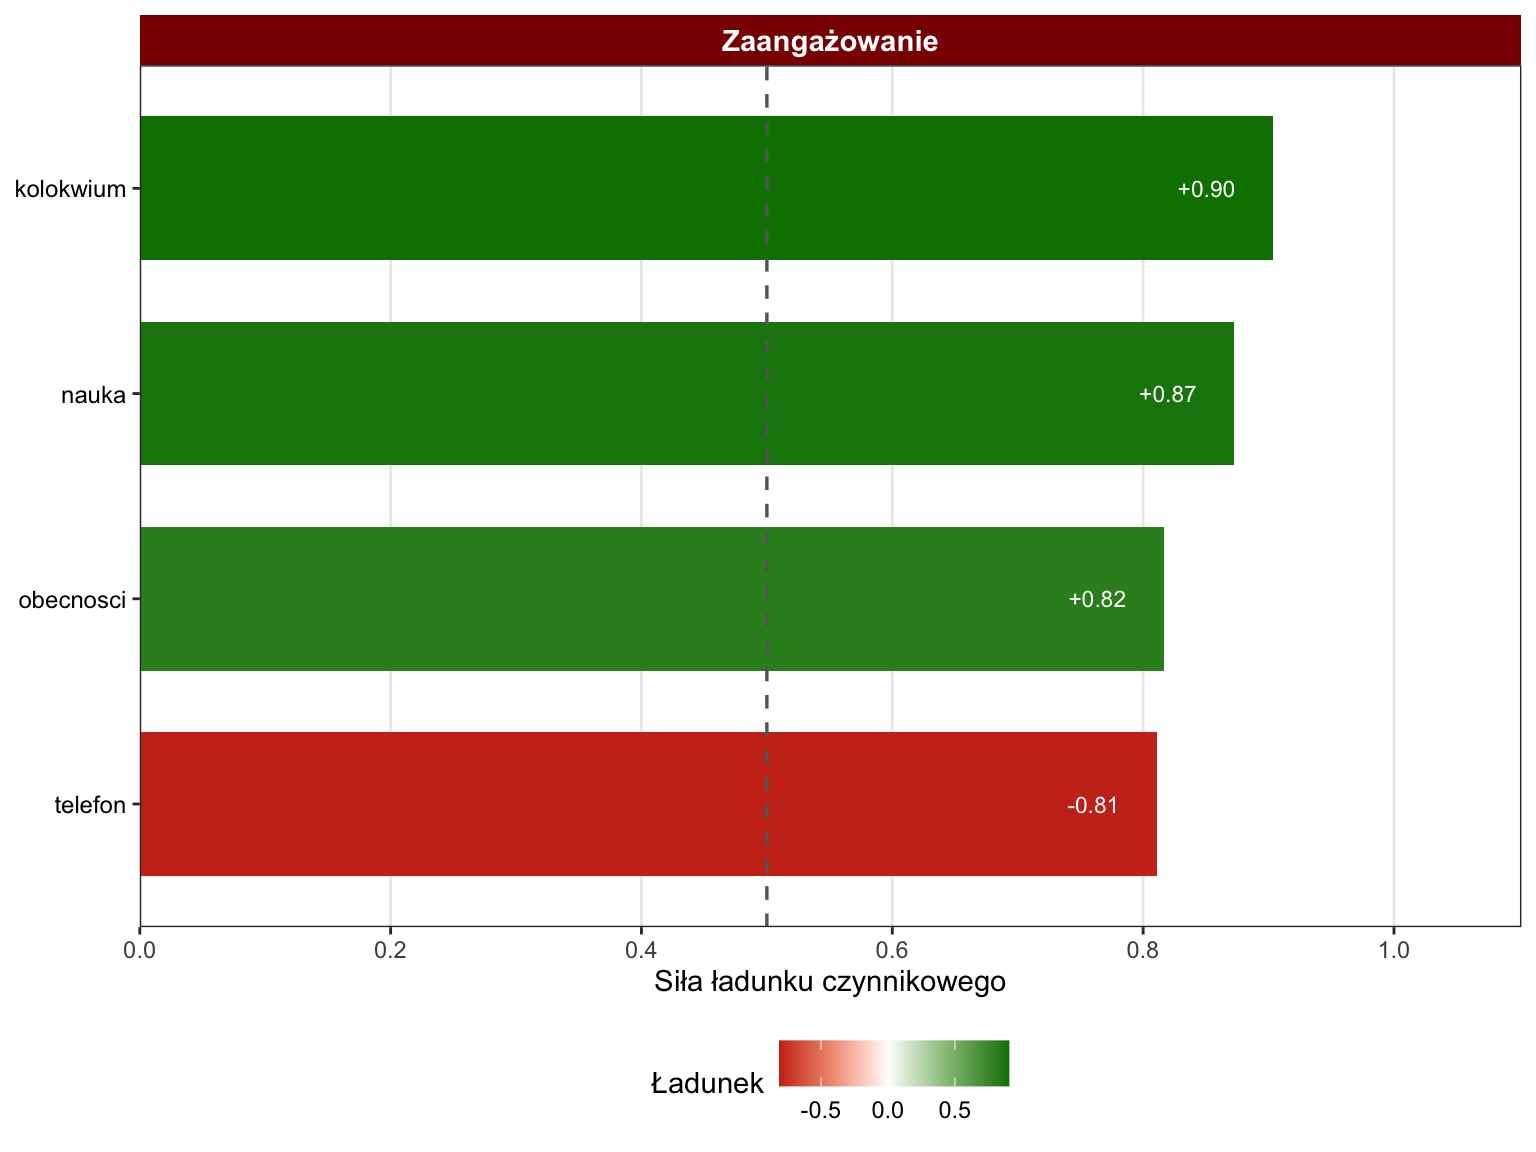
Ładunek to korelacja zmiennej ze składową: nauka 0,87, obecności 0,82, kolokwium 0,90, telefon −0,81. Wysokie wyniki PC1 mają osoby, które dużo się uczą, chodzą na zajęcia i dobrze piszą kolokwium, a mało czasu spędzają w mediach. Składową nazywamy więc „zaangażowanie w naukę”. Znak składowej jest umowny: inny program może odwrócić wszystkie znaki naraz i nie jest to błąd.
Krok 5. Wynik składowej i opis w pracy
Wynik PC1 (ostatnia kolumna tabeli 1) to ważona suma wyników z. Najniższy ma osoba 1 (−3,30), najwyższy – osoba 2 (2,35). Ten wskaźnik możesz wstawić do regresji zamiast czterech zmiennych – zobacz regresja liniowa – przykład.
Zapis w stylu APA: Cztery wskaźniki zaangażowania w naukę (N = 10) poddano analizie głównych składowych na zmiennych standaryzowanych. Pierwsza składowa miała wartość własną 2,90 i wyjaśniała 72,6% wariancji. Kolejne wartości własne były mniejsze od 1 (0,56; 0,33; 0,21), a analiza równoległa również wskazała jedną składową. Ładunki wynosiły: godziny nauki 0,87, obecności 0,82, punkty z kolokwium 0,90, czas w mediach społecznościowych −0,81.
PCA czy analiza czynnikowa?
PCA wybierz, gdy chcesz streścić dane: zbudować indeks, ograniczyć liczbę predyktorów albo narysować dane w dwóch wymiarach. Składowa to tylko ważona suma zmiennych i zawiera także ich błąd pomiaru. Gdy pytasz, jakie ukryte cechy mierzy kwestionariusz, użyj eksploracyjnej analizy czynnikowej. Analizuje ona tylko wariancję wspólną pytań (Fabrigar i in., 1999). Policzone na jednym zbiorze, PCA daje wyższe ładunki niż EFA – porównanie na innych danych (sześć pytań ankiety) znajdziesz we wpisie analiza czynnikowa – przykład.
Jak zrobić PCA w R?
# 10 studentów, 4 zmienne w różnych jednostkach
dane <- data.frame(nauka     = c(3, 9, 4, 11, 5, 8, 6, 7, 4, 8),              # godziny nauki w tygodniu
                   obecnosci = c(4, 10, 9, 9, 7, 7, 6, 8, 6, 8),              # obecności na 10 zajęciach
                   kolokwium = c(3, 18, 10, 13, 9, 14, 12, 15, 14, 16),       # punkty (0–20)
                   telefon   = c(240, 130, 230, 180, 250, 160, 160, 80, 230, 160))  # minuty dziennie w mediach

# 1) bez standaryzacji składowa 1 to prawie sam „telefon” (największa wariancja)
round(prcomp(dane)$rotation[, 1], 3)

# 2) PCA na danych standaryzowanych (= na macierzy korelacji)
pca <- prcomp(dane, scale. = TRUE)
round(pca$sdev^2, 2)                                   # wartości własne
round(100 * pca$sdev^2 / sum(pca$sdev^2), 1)           # % wyjaśnionej wariancji

# 3) ładunki = korelacje zmiennych ze składową 1
round(pca$rotation[, 1] * pca$sdev[1], 2)

# 4) wynik składowej dla każdej osoby (indeks „zaangażowania”)
round(pca$x[, 1], 2)

# 5) to samo w pakiecie psych (ładunki identyczne, wyniki w skali z)
psych::principal(dane, nfactors = 1, rotate = "none")$loadings
Wynik w konsoli R:
    nauka obecnosci kolokwium   telefon
    0.029     0.014     0.055    -0.998
[1] 2.90 0.56 0.33 0.21
[1] 72.6 14.0  8.2  5.1
    nauka obecnosci kolokwium   telefon
     0.87      0.82      0.90     -0.81
 [1] -3.30  2.35 -0.79  1.43 -1.42  0.58 -0.34  1.47 -1.10  1.10

Loadings:
          PC1
nauka      0.873
obecnosci  0.817
kolokwium  0.904
telefon   -0.811

                 PC1
SS loadings    2.903
Proportion Var 0.726
Pytania promotora i recenzenta
Czy 10 osób wystarczy?
Do ilustracji tak, do badania nie. Przy małej próbie wartości własne z danych losowych są wysokie (tu 2,25), a wynik bywa niestabilny. W pracy podaj liczebność i wynik analizy równoległej.
Czy po PCA robi się rotację?
Przy jednej składowej nie ma czego obracać. Przy kilku rotacja ułatwia opis, ale składowe po rotacji nie wyjaśniają już kolejno największej części wariancji (Jolliffe i Cadima, 2016).
Najczęstsze błędy
- PCA na surowych danych w różnych jednostkach.
- Nazywanie składowych „czynnikami” i interpretowanie ich jak ukrytych cech.
- Wybór liczby składowych tylko według kryterium Kaisera.
- Interpretowanie znaku składowej bez spojrzenia na ładunki.
- Brak informacji, ile procent wariancji wyjaśniają zachowane składowe.
Bibliografia
- Pearson, K. (1901). On lines and planes of closest fit to systems of points in space. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 2(11), 559–572. https://doi.org/10.1080/14786440109462720
- Hotelling, H. (1933). Analysis of a complex of statistical variables into principal components. Journal of Educational Psychology, 24(6), 417–441. https://doi.org/10.1037/h0071325
- Jolliffe, I. T., & Cadima, J. (2016). Principal component analysis: A review and recent developments. Philosophical Transactions of the Royal Society A, 374(2065), Article 20150202. https://doi.org/10.1098/rsta.2015.0202
- Horn, J. L. (1965). A rationale and test for the number of factors in factor analysis. Psychometrika, 30(2), 179–185. https://doi.org/10.1007/BF02289447
- Fabrigar, L. R., Wegener, D. T., MacCallum, R. C., & Strahan, E. J. (1999). Evaluating the use of exploratory factor analysis in psychological research. Psychological Methods, 4(3), 272–299. https://doi.org/10.1037/1082-989X.4.3.272
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikAnaliza czynnikowa – przykład
- Słownik wzorówKorelacja Pearsona
- Słownik wzorówAlfa Cronbacha
- PoradnikAlfa Cronbacha – przykład
- Przykładowy raportAnaliza czynnikowa
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.