

Dyskusja wyników w pracy magisterskiej – jak ją napisać krok po kroku
Dyskusja wyników to rozdział, w którym interpretujesz swoje wyniki: porównujesz je z literaturą, wyjaśniasz, co mogą znaczyć, i uczciwie opisujesz ograniczenia badania. Typowe pytanie z pracy dyplomowej: od czego zacząć dyskusję i co w niej napisać, gdy część hipotez się nie potwierdziła?
W prostych słowachRozdział wyników mówi, co wyszło. Dyskusja mówi, co to znaczy i na ile można temu ufać. Odpowiadasz w niej na trzy pytania: czy wynik zgadza się z innymi badaniami, dlaczego wyszedł właśnie tak i co z niego wynika.
Struktura dyskusji wyników w 5 krokach
- Główne wyniki w 2–3 zdaniach, bez liczb z tabel: „Dłuższy sen wiązał się z niższym stresem, a różnica w stresie między kierunkami była nieistotna statystycznie”.
- Odniesienie do literatury. Przy każdym wyniku napisz, czy jest zgodny z wcześniejszymi badaniami, i porównaj siłę efektów, a nie tylko etykiety „istotny – nieistotny”.
- Wyjaśnienie. Możliwe mechanizmy, ale też wyjaśnienia alternatywne: odwrotny kierunek zależności (stres może skracać sen) i zmienne zakłócające (np. liczbę egzaminów w sesji).
- Ograniczenia. Próba, sposób doboru, schemat badania i narzędzia – oraz to, jak mogły wpłynąć na wyniki.
- Implikacje i dalsze badania. Co wynika dla teorii i praktyki, czego nadal nie wiemy i jak to sprawdzić.
Wnioski i podsumowanie to osobne, krótsze części. Wnioski odpowiadają na pytania badawcze, a podsumowanie streszcza całą pracę.
Jak odnosić wyniki do literatury?
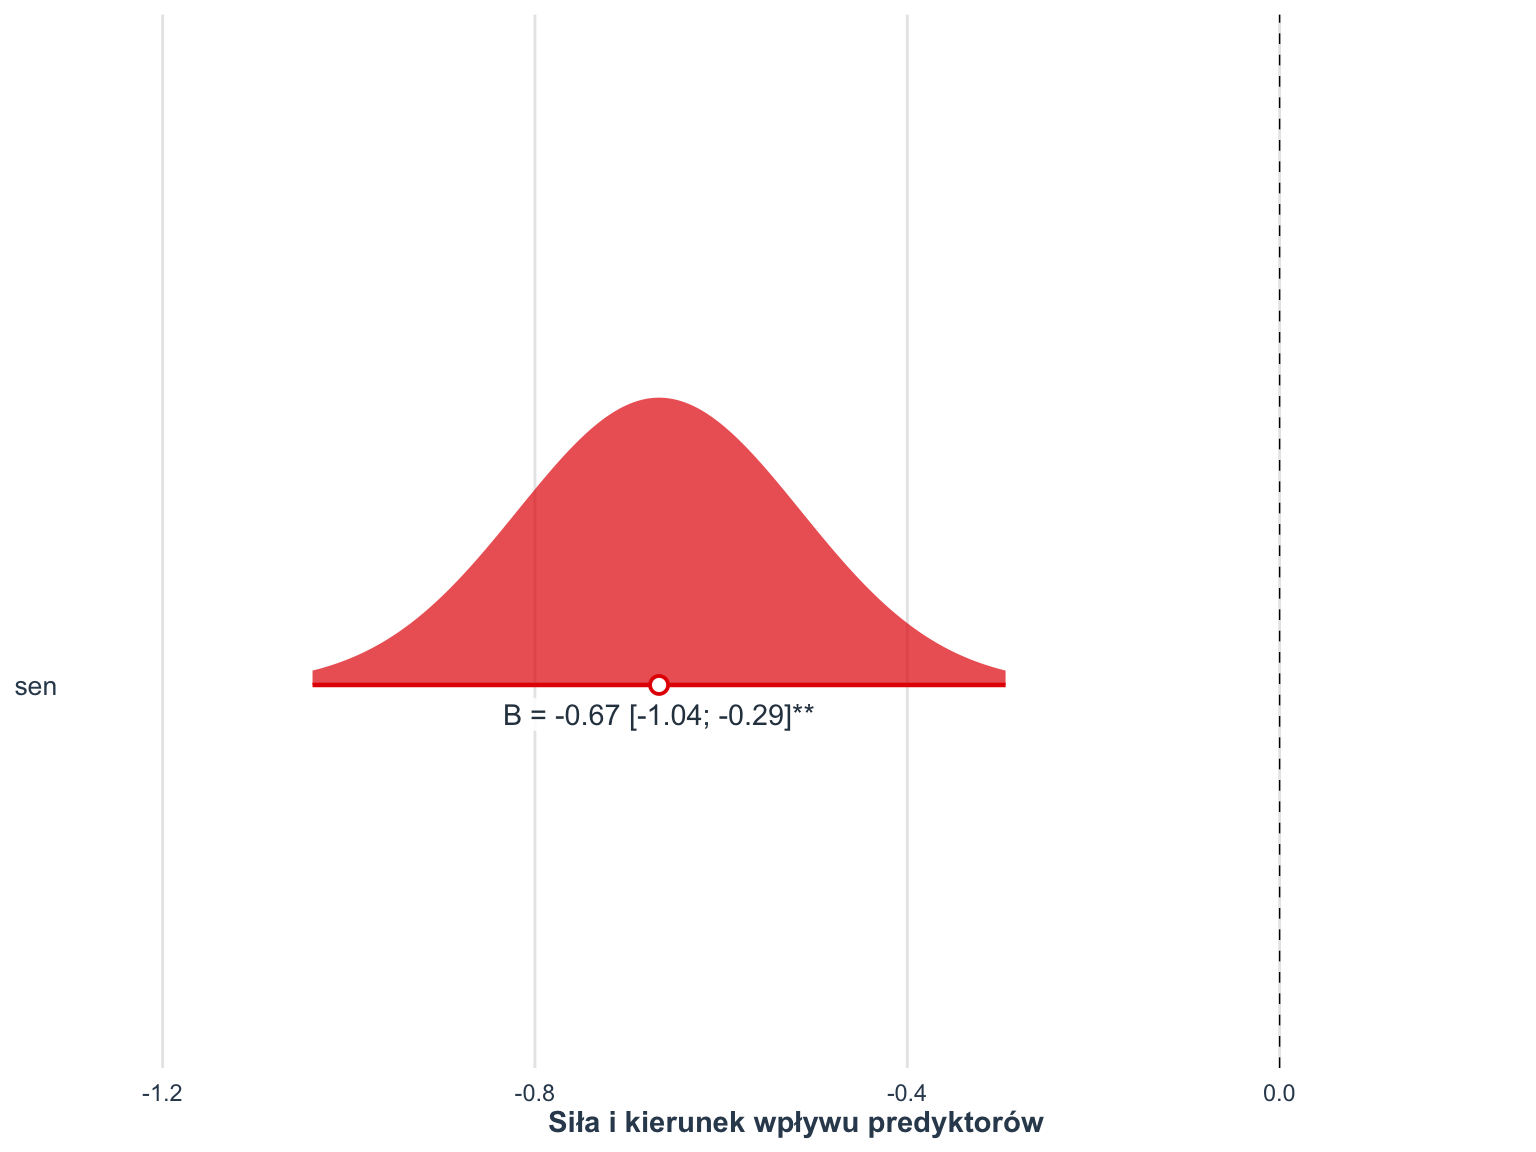
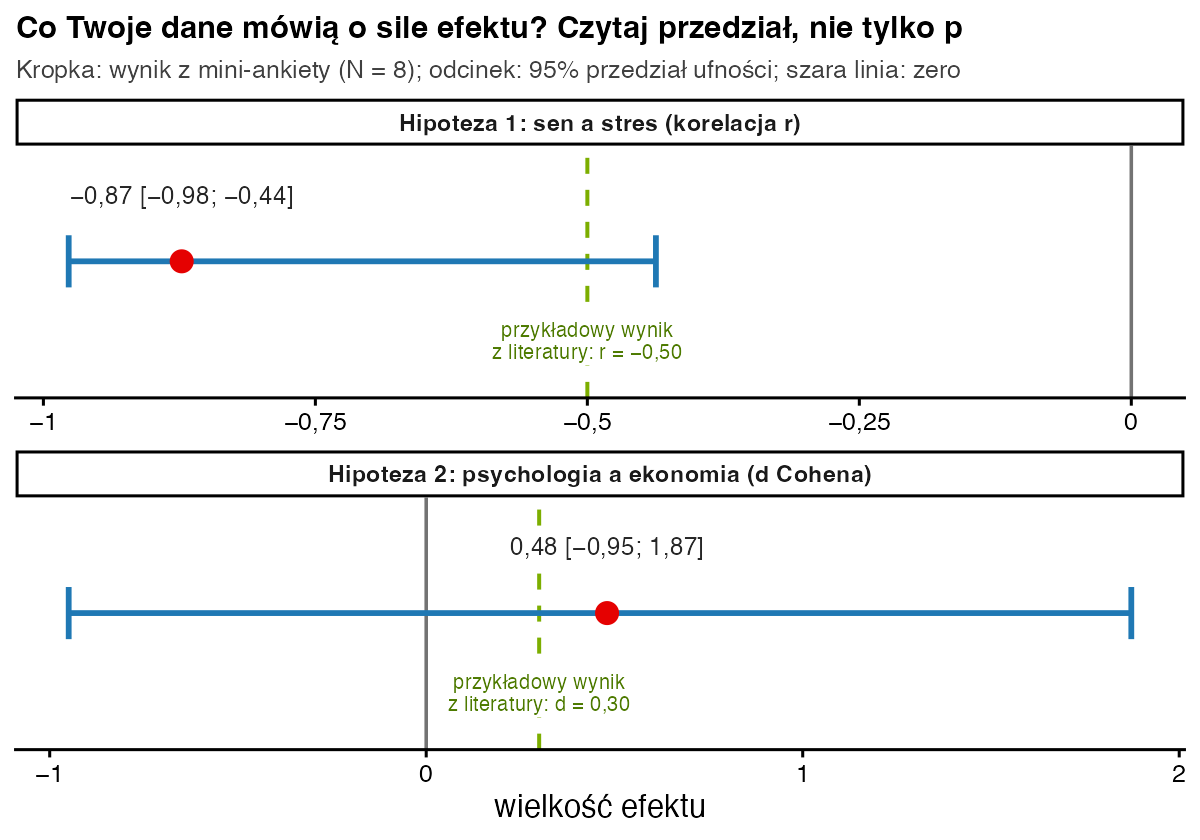
Porównuj wielkości efektów i ich przedziały ufności. Przedział pokazuje, jakie wartości efektu są zgodne z Twoimi danymi (Cumming, 2014). W mini-ankiecie „Stres przed sesją” (8 studentów) każda dodatkowa godzina snu wiązała się ze stresem niższym średnio o 0,67 punktu, ale przedział ufności sięga od 0,29 do 1,04 punktu (Rys. 1). Korelacja wyniosła r = −0,87, a jej przedział – od −0,98 do −0,44.
Załóżmy, że w artykule, z którym się porównujesz, r = −0,50. Ta wartość mieści się w Twoim przedziale (Rys. 2), więc nie piszesz „nasz związek był znacznie silniejszy”, tylko „wynik jest zgodny z literaturą co do kierunku, ale jego siły nie da się precyzyjnie oszacować”. Przy hipotezie 2 przedział dla d Cohena obejmuje i zero, i duże efekty, więc wynik nie przeczy ani badaniom, które różnicę znalazły, ani tym, które jej nie znalazły.
Jak opisać ograniczenia badania?
- Liczebność: 8 osób to mała moc i szerokie przedziały ufności.
- Dobór próby: dobór wygodny z dwóch kierunków nie pozwala uogólniać wyników na wszystkich studentów.
- Schemat badania: jeden pomiar pokazuje związek, a nie przyczynę.
- Pomiar: samoopis i własna skala czterech pytań; rzetelność była wysoka (α = 0,88), ale trafności skali nie sprawdzano.
Do każdego ograniczenia dopisz, jak mogło wpłynąć na wynik i jak je ominąć w kolejnym badaniu. To informacja dla czytelnika, a nie przeprosiny.
Przykładowy akapit dyskusji
Przykład: Zgodnie z hipotezą 1 dłuższy sen w czasie sesji wiązał się z niższym poziomem stresu. Kierunek tej zależności jest zgodny z wynikami [Autor, rok], choć ze względu na małą próbę jej siły nie można oszacować precyzyjnie (95% CI dla r od −0,98 do −0,44). Badanie miało charakter przekrojowy, dlatego nie można rozstrzygnąć, czy krótszy sen nasila stres, czy stres utrudnia zasypianie. Hipoteza 2 nie uzyskała wsparcia, ale przedział ufności dla różnicy między kierunkami był szeroki (d od −0,95 do 1,87), więc wynik należy traktować jako nierozstrzygający. W kolejnych badaniach warto zastosować pomiar powtarzany w trakcie sesji i większą próbę.
„[Autor, rok]” to miejsce na Twoje źródło. Jak je znaleźć, pokazujemy w poradniku jak szukać literatury do pracy magisterskiej.
Jak policzyć przedziały ufności do dyskusji w R?
# Mini-ankieta „Stres przed sesją” (N = 8): kierunek, wynik skali stresu (1–5) i godziny snu
ankieta <- data.frame(
  kierunek = factor(rep(c("Psychologia", "Ekonomia"), 4), levels = c("Psychologia", "Ekonomia")),
  stres = c(4.5, 1.5, 3.5, 2.5, 3.0, 4.0, 2.0, 3.0),
  sen = c(4, 8, 5, 7, 6, 6, 7, 5))

# 95% CI dla r „ręcznie” (transformacja z Fishera) i funkcją cor.test()
r <- cor(ankieta$sen, ankieta$stres); se_z <- 1 / sqrt(nrow(ankieta) - 3)
round(tanh(atanh(r) + c(-1, 1) * qnorm(0.975) * se_z), 2)
ci_r <- as.vector(cor.test(ankieta$sen, ankieta$stres)$conf.int); round(ci_r, 2)

# O ile punktów niższy stres na każdą godzinę snu? Współczynnik regresji B z 95% CI
model <- lm(stres ~ sen, data = ankieta)
round(c(B = unname(coef(model)["sen"]), confint(model)["sen", ]), 2)

# Czy wynik z literatury mieści się w Twoim przedziale? (tu przykładowo r = -0,50)
r_lit <- -0.50
r_lit >= ci_r[1] & r_lit <= ci_r[2]

# Hipoteza 2: d Cohena z 95% CI – przedział obejmuje zero i duże efekty
effectsize::cohens_d(stres ~ kierunek, data = ankieta)
Wynik w konsoli R:
[1] -0.98 -0.44
[1] -0.98 -0.44
     B  2.5 % 97.5 %
 -0.67  -1.04  -0.29
[1] TRUE
Cohen's d |        95% CI
-------------------------
0.48      | [-0.95, 1.87]

- Estimated using pooled SD.
Co napisać w dyskusji, gdy hipotezy się nie potwierdziły?
Podaj wielkość efektu z przedziałem ufności, oceń moc testu i rozważ przyczyny: małą próbę, narzędzie pomiaru, specyfikę grupy albo to, że teoria w tych warunkach się nie sprawdza. Nie pisz, że „różnic nie ma” – zobacz, jak opisaliśmy to we wpisie o weryfikacji hipotez. Jeśli chcesz omówić interpretację wyników ze statystykiem, zobacz, jak wyglądają konsultacje statystyczne: pomagamy zrozumieć liczby i dopracować język opisu, a dyskusję jako autor piszesz Ty.
Najczęstsze błędy
- Powtarzanie liczb i tabel z rozdziału wyników zamiast ich interpretacji.
- Język przyczynowy („sen zmniejsza stres”) w badaniu korelacyjnym.
- Wnioski, których dane nie sprawdzały, np. „optymalna liczba godzin snu” na podstawie korelacji liniowej.
- Cytowanie tylko badań zgodnych z własnym wynikiem.
- Nowe analizy i wyniki, których nie było w rozdziale wyników.
Bibliografia
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Hess, D. R. (2004). How to write an effective discussion. Respiratory Care, 49(10), 1238–1241.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikInterpretacja wyników statystycznych
- PoradnikJak opisać wyniki ankiety w pracy magisterskiej
- PoradnikJak szukać literatury do pracy magisterskiej
- Słownik wzorówd Cohena – wielkość efektu
- PoradnikAnaliza statystyczna w pracy magisterskiej krok po kroku
- Przykładowy raportCase study: praca magisterska z psychologii w SZTOS
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.