

Jak opisać wyniki ankiety w pracy magisterskiej – wzory zdań i tabele
Rozdział wyników to raport z tego, co policzyłeś: liczby, kierunek i siła zależności, bez dyskusji z literaturą. Typowe pytanie z pracy dyplomowej: w jakiej kolejności opisać ankietę i jak zapisać wynik testu, żeby promotor nie miał uwag?
W prostych słowachOpisujesz od ogółu do szczegółu: kim byli badani, jakie wyniki uzyskali, czy skale są rzetelne, a na końcu – co wyszło w każdej hipotezie. Każde zdanie łączy słowa z liczbami. Tabela pokazuje szczegóły, a tekst wskazuje to, co w tabeli najważniejsze.
W jakiej kolejności opisać wyniki ankiety?
- Opis próby. Liczba osób, płeć, kierunek oraz to, ile ankiet odrzucono i dlaczego.
- Statystyki opisowe. Dla pojedynczych pytań Likerta – rozkład odpowiedzi i mediana, dla wyników skal – średnia (M) i odchylenie standardowe (SD).
- Rzetelność skal. Alfa Cronbacha lub omega dla każdej skali, z informacją o pytaniach odwróconych.
- Weryfikacja hipotez. W kolejności hipotez: nazwa testu, statystyka, stopnie swobody, p, wielkość efektu i jedno zdanie o tym, co to znaczy.
- Analizy dodatkowe. To, czego nie planowałeś, opisz osobno i nazwij eksploracyjnym.
Wzory zdań do pracy
Liczby pochodzą z mini-ankiety „Stres przed sesją”: 8 studentów, 4 pytania na skali 1–5 (w tym jedno odwrócone) i liczba godzin snu. Krok po kroku opracowaliśmy ją w poradniku jak opracować wyniki ankiety.
Opis próby: W badaniu wzięło udział 8 studentów: 5 kobiet (62,5%) i 3 mężczyzn (37,5%), po 4 osoby z psychologii i ekonomii. Jedną ankietę odrzucono, ponieważ nie zawierała odpowiedzi na pytania o stres i sen.
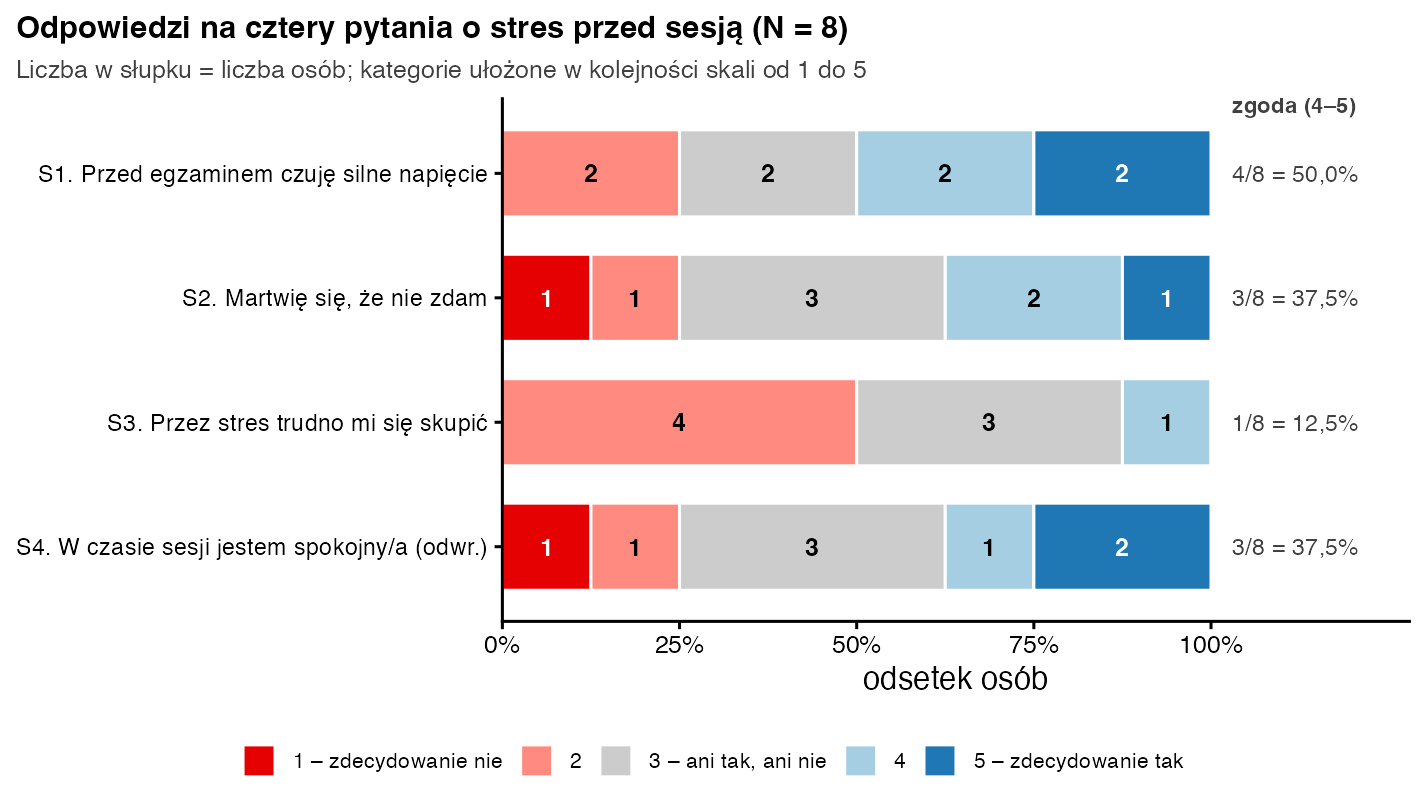
Pytanie Likerta: Połowa badanych (n = 4; 50%) zgodziła się ze stwierdzeniem „Przed egzaminem czuję silne napięcie” (Me = 3,5), a tylko jedna osoba (12,5%) – ze stwierdzeniem, że stres utrudnia jej skupienie na nauce.
Skala i rzetelność: Wynik skali stresu obliczono jako średnią czterech pozycji po odwróceniu pozycji S4. Skala miała wysoką rzetelność, α = 0,88. Średni poziom stresu wyniósł M = 3,00 (SD = 1,00), a badani spali średnio 6,00 godziny na dobę (SD = 1,31).
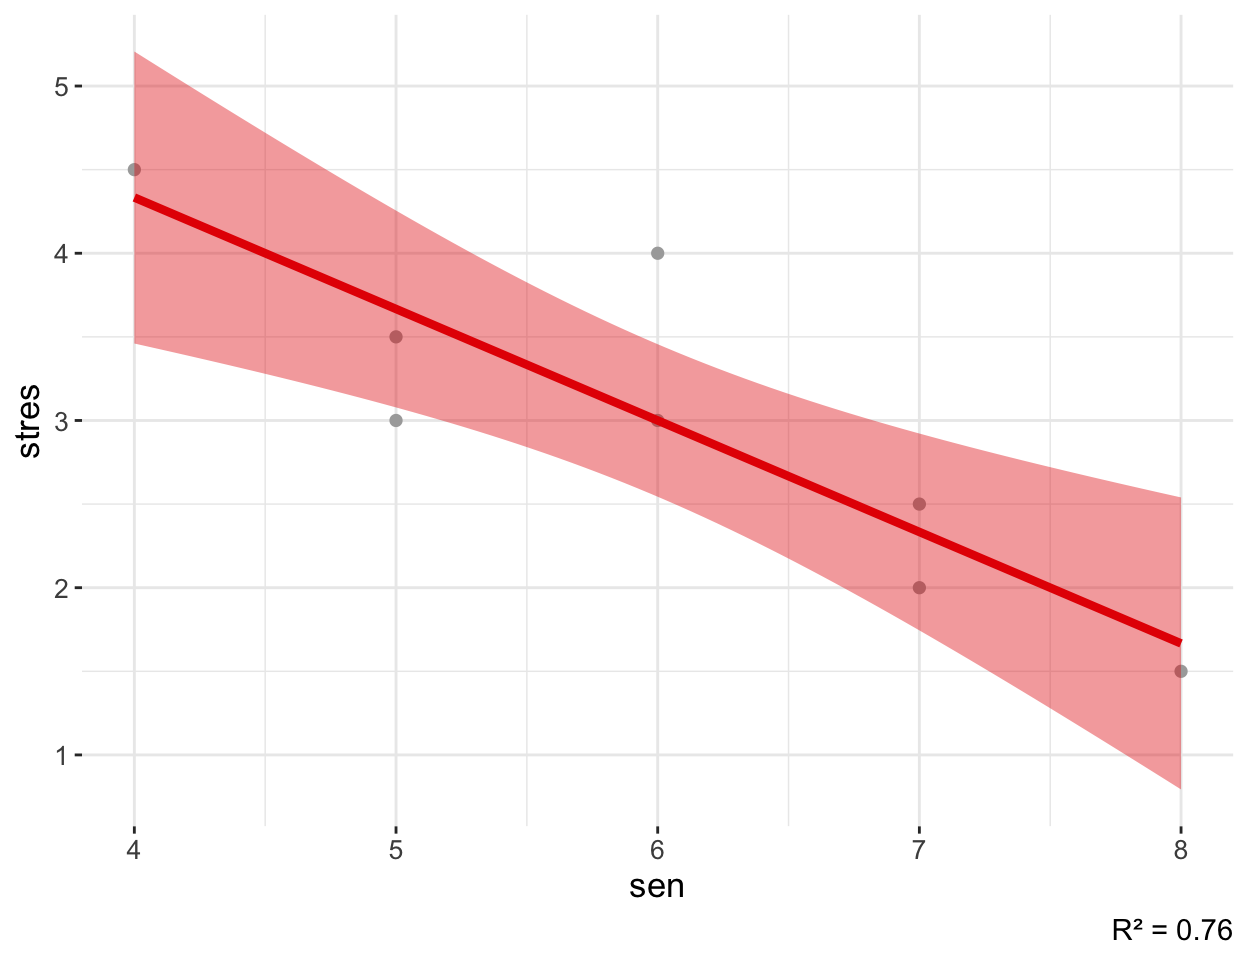
Hipoteza 1: Zgodnie z hipotezą dłuższy sen wiązał się z niższym poziomem stresu przed sesją, r(6) = −0,87; 95% CI [−0,98; −0,44]; p = 0,005.
Hipoteza 2: Studenci psychologii (M = 3,25; SD = 1,04) i ekonomii (M = 2,75; SD = 1,04) nie różnili się istotnie poziomem stresu, t(6) = 0,68; p = 0,522; d = 0,48. Brak więc podstaw do odrzucenia hipotezy zerowej, ale przy 4 osobach w grupie test mógł nie wykryć nawet średniej różnicy.
Gotowe tabele do rozdziału wyników
Tabela w stylu APA 7 ma numer, tytuł nad tabelą, tylko poziome linie i notę pod spodem (American Psychological Association, 2020). W tekście nie przepisuj jej zdanie po zdaniu. Wskaż najważniejszy wynik i odeślij czytelnika: „(zob. Tabela 2)”. Tak wygląda pełny przykładowy raport z opisem próby.
| Zmienna | Kategoria | n | % |
|---|---|---|---|
| Płeć | kobieta | 5 | 62,5 |
| mężczyzna | 3 | 37,5 | |
| Kierunek studiów | psychologia | 4 | 50,0 |
| ekonomia | 4 | 50,0 |
| Zmienna | Liczba pozycji | M | SD | Me | Min–maks | α |
|---|---|---|---|---|---|---|
| Stres przed sesją (1–5) | 4 | 3,00 | 1,00 | 3,00 | 1,5–4,5 | 0,88 |
| Sen (godziny na dobę) | 1 | 6,00 | 1,31 | 6,00 | 4–8 | – |
Nota pod Tabelą 2 może brzmieć: „Wynik skali stresu to średnia czterech pozycji; pozycję S4 odwrócono przed obliczeniami. α – alfa Cronbacha”.
Jak podpisać rysunek w pracy?
W stylu APA 7 nad rysunkiem piszesz pogrubiony numer („Rysunek 1”), pod nim tytuł kursywą, a pod rysunkiem notę: co oznaczają osie, linie i skróty oraz ile było osób. Sprawdź jednak zasady swojej uczelni, bo część z nich wymaga podpisu pod rysunkiem. Rysunek ma pokazywać wynik, który opisujesz, a nie powtarzać tabelę.
Jak przygotować zapis APA w R?
# Wyniki mini-ankiety po opracowaniu: płeć, kierunek, wynik skali stresu (1–5) i godziny snu
ankieta <- data.frame(
  płeć = c("K", "M", "K", "K", "M", "K", "K", "M"),
  kierunek = factor(rep(c("Psychologia", "Ekonomia"), 4), levels = c("Psychologia", "Ekonomia")),
  stres = c(4.5, 1.5, 3.5, 2.5, 3.0, 4.0, 2.0, 3.0),
  sen = c(4, 8, 5, 7, 6, 6, 7, 5))
f <- function(x, k = 2) formatC(x, format = "f", digits = k, decimal.mark = ",")  # przecinek dziesiętny
p_apa <- function(p) if (p < 0.001) "p < 0,001" else paste("p =", f(p, 3))

# Opis próby: liczebności i procenty
tab <- table(ankieta$płeć); paste0(names(tab), ": n = ", tab, " (", f(100 * prop.table(tab), 1), "%)")
# Statystyki opisowe skali
paste0("M = ", f(mean(ankieta$stres)), "; SD = ", f(sd(ankieta$stres)))
# H1: korelacja Pearsona stresu i snu
h1 <- cor.test(ankieta$stres, ankieta$sen)
paste0("r(", h1$parameter, ") = ", f(h1$estimate), "; 95% CI [", f(h1$conf.int[1]), "; ",
       f(h1$conf.int[2]), "]; ", p_apa(h1$p.value))
# H2: test t Studenta i d Cohena
h2 <- t.test(stres ~ kierunek, data = ankieta, var.equal = TRUE)
d <- effectsize::cohens_d(stres ~ kierunek, data = ankieta)$Cohens_d
paste0("t(", h2$parameter, ") = ", f(h2$statistic), "; ", p_apa(h2$p.value), "; d = ", f(d))
Wynik w konsoli R:
[1] "K: n = 5 (62,5%)" "M: n = 3 (37,5%)"
[1] "M = 3,00; SD = 1,00"
[1] "r(6) = -0,87; 95% CI [-0,98; -0,44]; p = 0,005"
[1] "t(6) = 0,68; p = 0,522; d = 0,48"
R zapisuje minus zwykłym łącznikiem. W pracy wstaw znak minus (−) i zapisz symbole statystyk kursywą.
Interpretacja wyników ankiety – czym różni się od opisu?
Opis mówi, co wyszło: „dłuższy sen wiązał się z niższym stresem”. Interpretacja mówi, co to znaczy: jak duży jest efekt, czy ma znaczenie praktyczne i jakie są ograniczenia badania (8 osób, dobór wygodny, jeden pomiar). Krótką ocenę siły efektu możesz dać już w wynikach – według umownych progów Cohena (1988) |r| ≥ 0,5 to związek silny. Porównania z innymi badaniami i wyjaśnienia przyczyn przenieś do dyskusji wyników. Więcej o czytaniu p, wielkości efektu i przedziału ufności znajdziesz we wpisie o interpretacji danych statystycznych.
Najczęstsze błędy: czego nie pisać w rozdziale wyników
- „p = 0,000” – program tylko zaokrąglił wynik. Pisz „p < 0,001”.
- „Przyjęto H0” albo „hipoteza została obalona”. Przy p > 0,05 piszesz „brak podstaw do odrzucenia H0” – brak istotności nie dowodzi braku różnicy.
- „Udowodniono” i „sen wpływa na stres”. Ankieta zebrana w jednym momencie pokazuje związek, a nie przyczynę.
- „Istotność danych”. Istotny może być wynik testu, a nie dane.
- Samo p bez statystyki testu, stopni swobody i wielkości efektu.
Bibliografia
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Heiberger, R. M., & Robbins, N. B. (2014). Design of diverging stacked bar charts for Likert scales and other applications. Journal of Statistical Software, 57(5), 1–32. https://doi.org/10.18637/jss.v057.i05
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikOpracowanie wyników ankiety
- PoradnikJak opracować wyniki ankiety krok po kroku
- PoradnikJak przygotować ankietę do pracy magisterskiej
- Słownik wzorówCzęstości i procenty
- Słownik wzorówAlfa Cronbacha
- Słownik wzorówTest chi-kwadrat
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.