

Interpretacja danych statystycznych – p, efekt i przedział ufności
Interpretacja wyników statystycznych to odpowiedź na trzy pytania: czy wynik mógł wyjść przypadkiem, jak duży jest efekt i jak dokładnie go oszacowano. Typowe pytanie z pracy dyplomowej: wyszło p = 0,08 – czy to znaczy, że nie ma żadnej różnicy?
W prostych słowachWartość p mówi tylko, czy dane dobrze pasują do świata „bez efektu”. Wielkość efektu mówi, jak duża jest różnica albo związek. Przedział ufności pokazuje, jak bardzo możesz się mylić. Dopiero te trzy liczby razem dają uczciwy obraz wyniku.
Trzy liczby w każdym wyniku
| Liczba | Na jakie pytanie odpowiada | Czego nie mówi | W przykładzie |
|---|---|---|---|
| wartość p | czy dane są zgodne z H0 | jak duży jest efekt; jak prawdopodobna jest H0 | p = 0,017 |
| wielkość efektu, np. d Cohena | jak duża jest różnica, niezależnie od liczby osób | czy wynik jest ważny w praktyce – to oceniasz sam | d = 1,90 |
| 95% przedział ufności | jakie wartości efektu dobrze pasują do danych | że prawdziwa wartość leży w nim „na 95%” | różnica 3 pkt, CI [0,69; 5,31] |
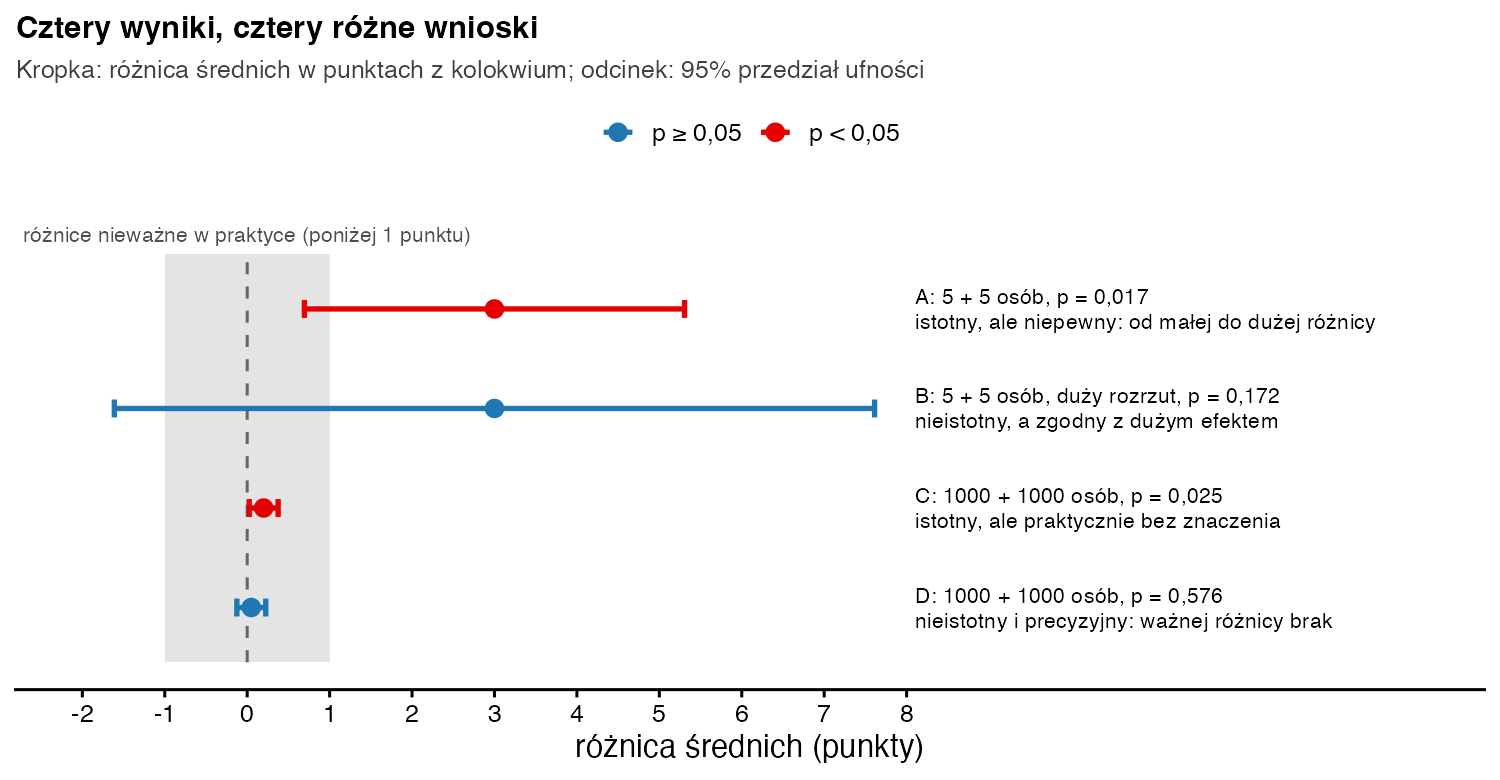
Przykład z hasła test t Studenta (pełny przebieg analizy na większej próbie pokazuje wpis test t – przykład): studenci uczący się z quizów zdobyli średnio o 3 punkty więcej niż ci, którzy uczyli się z notatek. Różnica jest istotna, a jej oszacowanie duże, ale przedział od 0,69 do 5,31 punktu jest szeroki – przy pięciu osobach w grupie prawdziwa różnica może być ledwo zauważalna albo ogromna. „95%” to cecha metody: w 95% powtórzonych badań tak liczony przedział obejmie prawdziwą wartość (Cumming, 2014). Skąd bierze się sama wartość p, wyjaśnia wpis test statystyczny – na czym polega.
Istotność statystyczna a praktyczna
Istotność zależy od liczby osób. Ten sam mały efekt daje zupełnie różne p:
| Osób w grupie | 5 | 50 | 500 |
|---|---|---|---|
| wartość p (test t) | 0,648 | 0,137 | < 0,001 |
Przy dużych próbach nawet drobna różnica bywa istotna. O znaczeniu wyniku decyduje więc wielkość efektu odniesiona do praktyki: czy 0,2 punktu na kolokwium kogokolwiek obchodzi? Progi Cohena (1988) – d = 0,2 to efekt mały, 0,5 – średni, 0,8 – duży – stosuj tylko wtedy, gdy nie masz lepszego punktu odniesienia.
Brak istotności to nie brak efektu
Godziny nauki i punkty pięciu studentów korelują silnie, r = 0,80, a mimo to p = 0,104. Przedział ufności [−0,28; 0,99] obejmuje i brak związku, i związek bardzo silny. Poprawny wniosek brzmi: „brak podstaw do odrzucenia H0; próba była za mała, by to rozstrzygnąć”, a nie „brak związku”. Takiej sytuacji zapobiegasz, licząc przed badaniem, ilu osób potrzebujesz (błąd II rodzaju i moc testu). Żeby z kolei wykazać, że efektu praktycznie nie ma, potrzebujesz wąskiego przedziału ufności w całości bliskiego zera, jak w scenariuszu D (Lakens i in., 2018).
Korelacja to nie przyczynowość
Związek godzin nauki z punktami nie dowodzi, że to nauka podnosi wynik. Być może bardziej zmotywowane osoby i uczą się dłużej, i lepiej piszą kolokwium. W symulacji z kodu poniżej korelacja wynosi 0,78, choć punkty zależą wyłącznie od motywacji – po jej uwzględnieniu „wpływ” godzin spada do −0,04. O przyczynie możesz mówić po eksperymencie z losowym przydziałem do grup albo przy mocnym uzasadnieniu i kontroli zmiennych zakłócających (Rohrer, 2018). W pracy pisz „wiązało się z”, a nie „wpływało na”.

Zapis w stylu APA: Studenci uczący się z quizów uzyskali średnio o 3,00 punktu więcej niż studenci uczący się z notatek, 95% CI [0,69; 5,31]; t(8) = 3,00; p = 0,017; d = 1,90; 95% CI [0,32; 3,40]. Ze względu na małą próbę oszacowanie wielkości efektu jest mało precyzyjne.
Jak policzyć p, efekt i przedział ufności w R?
notatki <- c(1, 2, 3, 4, 5); quizy <- c(4, 5, 6, 7, 8)       # punkty z kolokwium

# 1) trzy liczby przy każdym wyniku: p, wielkość efektu i przedział ufności
wynik <- t.test(quizy, notatki, var.equal = TRUE)
round(c(p = wynik$p.value, roznica = mean(quizy) - mean(notatki),
        CI_od = wynik$conf.int[1], CI_do = wynik$conf.int[2]), 3)
d <- effectsize::cohens_d(quizy, notatki)                    # d Cohena z 95% CI
round(c(d = d$Cohens_d, CI_od = d$CI_low, CI_do = d$CI_high), 2)

# 2) ten sam mały efekt (d = 0,3), różna liczba osób w grupie
n <- c(5, 50, 500)
round(2 * pt(-0.3 * sqrt(n / 2), df = 2 * n - 2), 6)         # p dla testu t

# 3) duży efekt bez istotności: godziny nauki i punkty 5 studentów
k <- cor.test(1:5, c(4, 2, 8, 6, 10))
round(c(r = unname(k$estimate), p = k$p.value, CI_od = k$conf.int[1], CI_do = k$conf.int[2]), 3)

# 4) korelacja bez przyczynowości: godziny i punkty zależą od trzeciej zmiennej
set.seed(2026)
motywacja <- rnorm(200)
godz <- 3 + motywacja + rnorm(200, sd = 0.5)
pkt  <- 6 + 2 * motywacja + rnorm(200)            # godziny NIE wpływają tu na punkty
round(c(r = cor(godz, pkt),
        b_godzin_przy_stalej_motywacji = unname(coef(lm(pkt ~ godz + motywacja))["godz"])), 2)
Wynik w konsoli R:
      p roznica   CI_od   CI_do
  0.017   3.000   0.694   5.306
    d CI_od CI_do
 1.90  0.32  3.40
[1] 0.647934 0.136829 0.000002
     r      p  CI_od  CI_do
 0.800  0.104 -0.280  0.986
                             r b_godzin_przy_stalej_motywacji
                          0.78                          -0.04
Wyszło p = 0,06 – czy to „trend”?
Nie. Jeśli przyjąłeś α = 0,05, napisz, że różnica nie była istotna statystycznie, podaj dokładne p, wielkość efektu z przedziałem ufności i zaznacz, że badanie mogło mieć za małą moc. Nie zmieniaj α po fakcie. Jak omówić taki wynik w rozdziale końcowym, opisujemy we wpisie dyskusja wyników w pracy magisterskiej. Gotowe zdania do rozdziału wyników znajdziesz we wpisie jak opisać wyniki ankiety.
Najczęstsze błędy
- „p = 0,017, więc H0 jest prawdziwa z prawdopodobieństwem 1,7%”. Tymczasem p liczymy przy założeniu, że H0 jest prawdziwa (Wasserstein i Lazar, 2016; Greenland i in., 2016).
- „Wynik nieistotny, więc grupy są takie same”.
- Ocenianie ważności wyniku po samym p, bez wielkości efektu.
- „Istotny wynik potwierdził hipotezę” – dane mogą ją wspierać, ale jej nie dowodzą.
- Opisywanie korelacji słowami „wpływ” albo „powoduje”.
Bibliografia
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. https://doi.org/10.1007/s10654-016-0149-3
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Lakens, D., Scheel, A. M., & Isager, P. M. (2018). Equivalence testing for psychological research: A tutorial. Advances in Methods and Practices in Psychological Science, 1(2), 259–269. https://doi.org/10.1177/2515245918770963
- Rohrer, J. M. (2018). Thinking clearly about correlations and causation: Graphical causal models for observational data. Advances in Methods and Practices in Psychological Science, 1(1), 27–42. https://doi.org/10.1177/2515245917745629
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówIstotność statystyczna i wartość p
- Słownik wzorówPrzedział ufności dla średniej
- Słownik wzorówd Cohena – wielkość efektu
- PoradnikDyskusja wyników w pracy magisterskiej
- PoradnikAnaliza statystyczna – co to jest
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.