

Jak postawić hipotezę badawczą (naukową)? Od teorii do H0 i H1
Hipoteza badawcza to sprawdzalne przypuszczenie o związku albo różnicy między zmiennymi, wyprowadzone z teorii i wcześniejszych badań. Typowe pytanie z pracy dyplomowej: jak przejść od tematu pracy do hipotezy, którą da się sprawdzić konkretnym testem statystycznym?
W prostych słowachDobra hipoteza mówi, co z czym się wiąże (albo czym się różni), u kogo i w którą stronę. Każde pojęcie z hipotezy musisz umieć zmierzyć. Jeśli nie wiesz, jakim testem ją sprawdzisz, hipoteza jest jeszcze za ogólna.
Hipoteza badawcza a hipoteza statystyczna
Hipoteza badawcza to zdanie o świecie, np. „Studenci, którzy w czasie sesji śpią dłużej, odczuwają mniejszy stres”. Hipotezy statystyczne to jej przekład na język testu. Hipoteza zerowa H0 mówi, że w populacji związku (różnicy) nie ma, a hipoteza alternatywna H1 – że jest. Test sprawdza H0, a nie Twoją hipotezę badawczą wprost. Żeby się nie pogubić, hipotezy badawcze numeruj słownie („Hipoteza 1”, „Hipoteza 2”), a symbole H0 i H1 zostaw dla zapisu statystycznego.
Jak postawić hipotezę krok po kroku
- Pytanie badawcze. „Czy długość snu w czasie sesji wiąże się z poziomem stresu?”
- Teoria i wcześniejsze badania. To one podpowiadają, czy i w którą stronę zależność powinna wystąpić. Jak je znaleźć, pokazujemy w poradniku jak szukać literatury do pracy magisterskiej.
- Operacjonalizacja. Każde pojęcie zamień na zmienną: stres to średnia czterech pytań na skali 1–5 (jedno odwrócone), sen to liczba godzin snu na dobę, a kierunek to psychologia albo ekonomia. Jak ułożyć takie pytania, przeczytasz w poradniku jak opracować ankietę do pracy magisterskiej.
- Kierunek. Jeśli teoria przewiduje znak zależności, postaw hipotezę kierunkową; jeśli tylko jej istnienie – niekierunkową.
- H0, H1 i test. Typ zmiennych i schemat badania wskazują test (Tabela 2).
- Lista kontrolna. Hipotezę da się obalić, jest jednoznaczna, wskazuje populację i w ankiecie z jednego pomiaru mówi o związku, a nie o przyczynie.
| Źle | Co jest nie tak | Lepiej |
|---|---|---|
| „Stres wpływa na studentów.” | nie wiadomo, na co wpływa ani jak to zmierzyć | „Wyższy wynik skali stresu wiąże się z krótszym snem w czasie sesji.” |
| „Sen powoduje spadek stresu.” | ankieta z jednego pomiaru nie pokaże przyczyny | „Dłuższy sen wiąże się z niższym poziomem stresu.” |
| „Studenci psychologii są bardziej zestresowani i gorzej śpią.” | dwie hipotezy w jednym zdaniu | dwie osobne hipotezy, każda z własnym testem |
| „Istnieją pewne zależności między stresem a studiami.” | pasuje do każdego wyniku, więc nie da się jej obalić | „Studenci psychologii i ekonomii różnią się poziomem stresu przed sesją.” |
| „Kierunki nie różnią się poziomem stresu.” | to hipoteza zerowa; nieistotny wynik jej nie dowiedzie | hipoteza o różnicy albo zaplanowany test równoważności (Lakens, 2017) |
Hipoteza kierunkowa czy niekierunkowa?
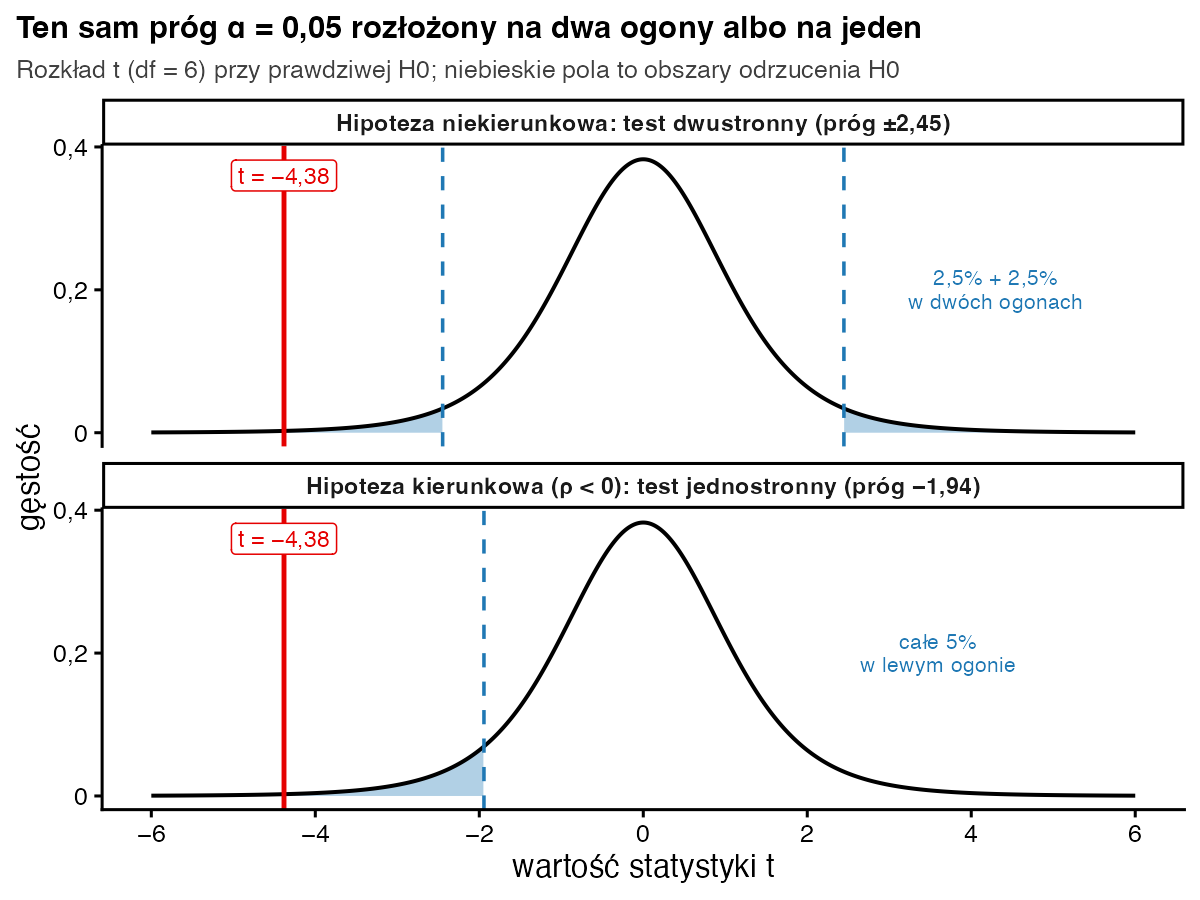
Hipoteza kierunkowa przewiduje znak zależności: „im dłuższy sen, tym niższy stres”, czyli H0: ρ ≥ 0 i H1: ρ < 0. Pozwala użyć testu jednostronnego, który – jeśli kierunek przewidziano trafnie – ma większą moc, bo cały próg α leży po jednej stronie rozkładu (Rys. 2). Warunek: kierunek zapisujesz przed zebraniem danych. W mini-ankiecie r = −0,87 daje p = 0,002 jednostronnie i p = 0,005 dwustronnie. Gdybyś jednak przewidział zły kierunek, test jednostronny dałby p = 0,998, więc nie możesz „przełączyć” kierunku po fakcie. Hipoteza niekierunkowa, np. „studenci psychologii i ekonomii różnią się poziomem stresu”, wymaga testu dwustronnego: t(6) = 0,68; p = 0,522. W razie wątpliwości wybierz test dwustronny – tego zwykle oczekują recenzenci.
Jak dobrać test do hipotezy?
| Hipoteza mówi o… | Przykład | Test (gdy założenia nie są spełnione) |
|---|---|---|
| związku dwóch zmiennych ilościowych | sen a stres | korelacja Pearsona (Spearmana) |
| różnicy między dwiema grupami | psychologia a ekonomia | test t dla prób niezależnych (U Manna-Whitneya) |
| zmianie u tych samych osób | stres przed sesją i po niej | test t dla prób zależnych (Wilcoxona) |
| związku dwóch zmiennych kategorialnych | płeć a wybór sportu jako sposobu na stres | chi-kwadrat (dokładny test Fishera) |
Więcej sytuacji i pełny plan analiz znajdziesz w poradniku analiza statystyczna w pracy magisterskiej, a całą procedurę od H0 do decyzji – we wpisie weryfikacja hipotez w pracy magisterskiej.
Jak przejść od hipotezy do testu w R?
# Mini-ankieta „Stres przed sesją” (N = 8): wynik skali stresu (1–5), godziny snu i kierunek
ankieta <- data.frame(
  kierunek = factor(rep(c("Psychologia", "Ekonomia"), 4), levels = c("Psychologia", "Ekonomia")),
  stres = c(4.5, 1.5, 3.5, 2.5, 3.0, 4.0, 2.0, 3.0),
  sen = c(4, 8, 5, 7, 6, 6, 7, 5))

# Hipoteza 1 (kierunkowa): im dłuższy sen, tym niższy stres  ->  H0: rho >= 0,  H1: rho < 0
h1 <- cor.test(ankieta$sen, ankieta$stres, alternative = "less")
round(c(r = unname(h1$estimate), t = unname(h1$statistic), p_jednostronne = h1$p.value), 3)
# Ten sam wynik testem dwustronnym (H1: rho ≠ 0) i jednostronnym w złą stronę (H1: rho > 0)
round(c(dwustronne = cor.test(ankieta$sen, ankieta$stres)$p.value,
        zly_kierunek = cor.test(ankieta$sen, ankieta$stres, alternative = "greater")$p.value), 3)

# Hipoteza 2 (niekierunkowa): psychologia i ekonomia różnią się stresem  ->  test dwustronny
h2 <- t.test(stres ~ kierunek, data = ankieta, var.equal = TRUE)
round(c(t = unname(h2$statistic), df = unname(h2$parameter), p = h2$p.value), 3)

# Wartości krytyczne t dla df = 6 i alfa = 0,05: test dwustronny i jednostronny
round(c(dwustronny = qt(0.975, 6), jednostronny = qt(0.05, 6)), 2)
Wynik w konsoli R:
             r              t p_jednostronne
        -0.873         -4.382          0.002
  dwustronne zly_kierunek
       0.005        0.998
    t    df     p
0.679 6.000 0.522
  dwustronny jednostronny
        2.45        -1.94
Ile hipotez w pracy magisterskiej?
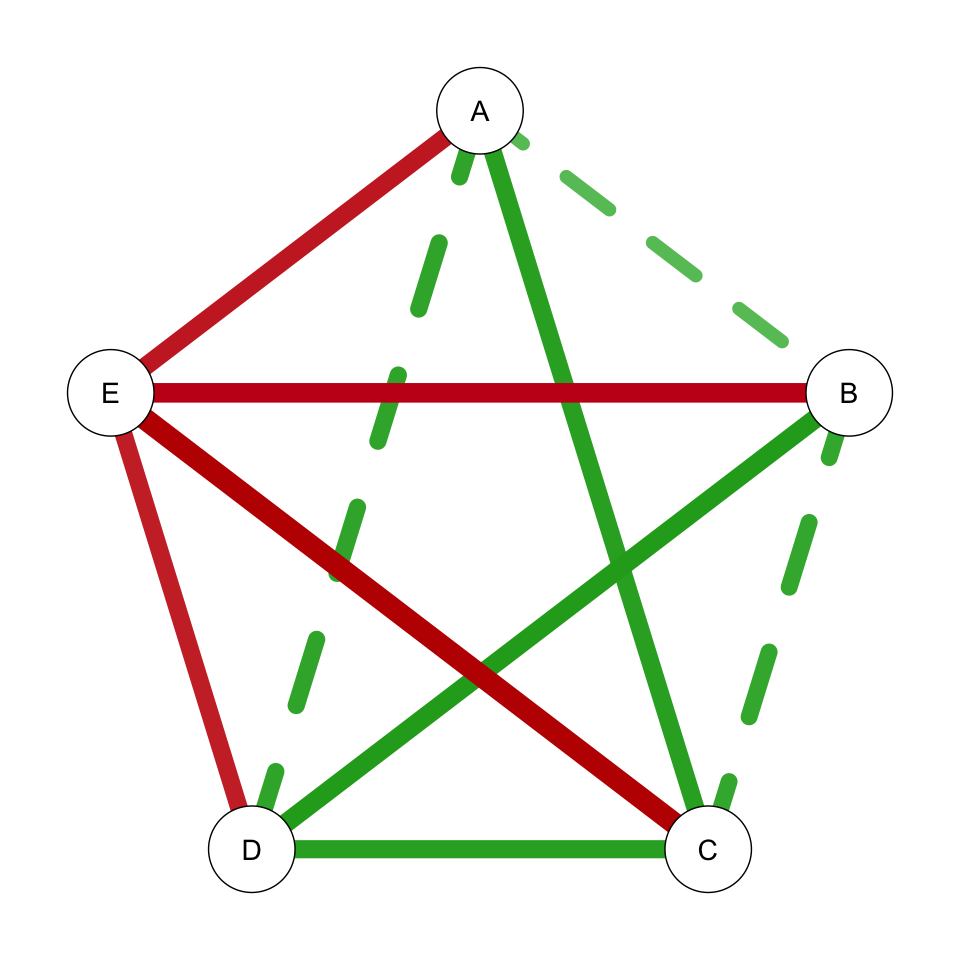
Nie ma jednej liczby. Zwykle wystarczą 2–4 hipotezy, każda wynikająca z pytania badawczego i sprawdzana jednym, wcześniej wybranym testem. Więcej hipotez to więcej testów (Rys. 1), a więc większa szansa na przypadkowo istotny wynik i potrzeba korekty poziomu istotności, np. poprawką Bonferroniego. Lepiej mieć dwie przemyślane hipotezy niż dziesięć pisanych „na wszelki wypadek”. Hipotezy szczegółowe (np. 1a i 1b) stosuj wtedy, gdy rozbijasz jedno przypuszczenie na kilka konkretnych zależności.
Najczęstsze błędy
- Język przyczynowy („wpływa”, „powoduje”) w badaniu ankietowym z jednego pomiaru.
- Hipoteza tak ogólna, że pasuje do każdego wyniku.
- Dopisywanie hipotez po obejrzeniu wyników i przedstawianie ich jako zaplanowanych (Kerr, 1998).
- Test jednostronny wybrany dopiero wtedy, gdy dwustronny „nie wyszedł”.
- Oznaczanie hipotez badawczych symbolami H1, H2, które mylą się z hipotezą alternatywną H1.
Bibliografia
- Kerr, N. L. (1998). HARKing: Hypothesizing after the results are known. Personality and Social Psychology Review, 2(3), 196–217. https://doi.org/10.1207/s15327957pspr0203_4
- Lakens, D. (2017). Equivalence tests: A practical primer for t tests, correlations, and meta-analyses. Social Psychological and Personality Science, 8(4), 355–362. https://doi.org/10.1177/1948550617697177
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikWeryfikacja hipotez w pracy magisterskiej
- PoradnikAnaliza statystyczna w pracy magisterskiej krok po kroku
- Słownik wzorówIstotność statystyczna i wartość p
- PoradnikDyskusja wyników w pracy magisterskiej
- Przykładowy raportCase study: praca magisterska z psychologii w SZTOS
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.