

Jak opracować ankietę do pracy magisterskiej i licencjackiej – krok po kroku
Opracowanie ankiety to zaprojektowanie kwestionariusza tak, żeby każde pytanie mierzyło coś potrzebnego do hipotez, a odpowiedzi dało się policzyć. Typowe pytanie z pracy dyplomowej: jak zrobić ankietę do pracy magisterskiej (albo licencjackiej), jakie pytania zadać i ile osób zbadać?
W prostych słowachAnkietę projektujesz od końca: najpierw hipotezy, potem lista zmiennych, a dopiero na końcu pytania. Postawy i odczucia mierzysz kilkoma pytaniami na tej samej skali, a nie jednym. Przed startem sprawdzasz ankietę na kilku osobach i liczysz, ilu respondentów potrzebujesz.
Jak opracować ankietę krok po kroku
- Cel i hipotezy. Każde pytanie musi służyć jakiejś hipotezie albo opisowi próby. Jak sformułować hipotezy, pokazujemy w poradniku jak postawić hipotezę badawczą.
- Operacjonalizacja, czyli droga od pojęcia do pytań (Tabela 1). Jeśli istnieje sprawdzone narzędzie z polską adaptacją, użyj go zamiast pisać własne i sprawdź zasady korzystania z niego.
- Rodzaje pytań. Zamknięte i skale łatwo policzyć, otwarte przydają się do eksploracji i opcji „inne – jakie?”. Metryczkę (płeć, wiek, kierunek) daj na koniec.
- Formułowanie. Jedno pytanie dotyczy jednej sprawy, nie sugeruje odpowiedzi i nie zawiera podwójnych przeczeń ani żargonu.
- Pilotaż na kilku osobach z Twojej populacji.
- Liczebność próby – policzona, a nie zgadnięta.
- Etyka i RODO – informacja dla badanych i minimum danych osobowych.
| Zmienna | Pytanie | Odpowiedzi | Jak policzysz |
|---|---|---|---|
| stres przed sesją | S1 „Przed egzaminem czuję silne napięcie”, S2 „Martwię się, że nie zdam”, S3 „Przez stres trudno mi się skupić na nauce”, S4 „W czasie sesji jestem spokojny/spokojna” (odwrócone) | skala 1–5 od „zdecydowanie się nie zgadzam” do „zdecydowanie się zgadzam” | średnia S1–S4 po odwróceniu S4; alfa Cronbacha |
| sen | „Ile godzin średnio śpisz na dobę w czasie sesji?” | liczba godzin | średnia i SD; korelacja ze stresem |
| kierunek studiów | „Jaki kierunek studiujesz?” | jednokrotny wybór | liczebności; porównanie grup |
| sposoby radzenia sobie | „Co pomaga Ci w stresie?” | wielokrotny wybór + „inne” | każda opcja jako osobna kolumna tak/nie |
Skala Likerta i pytania odwrócone
Skala Likerta to zestaw stwierdzeń, które badany ocenia na tej samej skali zgody, zwykle 5- albo 7-punktowej (Likert, 1932). Opisz słownie każdy punkt albo przynajmniej oba końce skali. Pojedyncze pytanie daje dane porządkowe, więc opisujesz je medianą i rozkładem odpowiedzi. Średnią lub sumę kilku pytań zwykle traktuje się jak zmienną ilościową (Norman, 2010). Pytanie odwrócone, jak S4, chroni przed zaznaczaniem „zgadzam się” przy wszystkim. Przed policzeniem wyniku skali i alfy Cronbacha przekoduj je wzorem (min + max) − odpowiedź, czyli na skali 1–5: 6 − odpowiedź. Zamiast przeczeń („nie jestem spokojny”) używaj stwierdzeń o przeciwnym sensie.
Pilotaż – co sprawdzić?
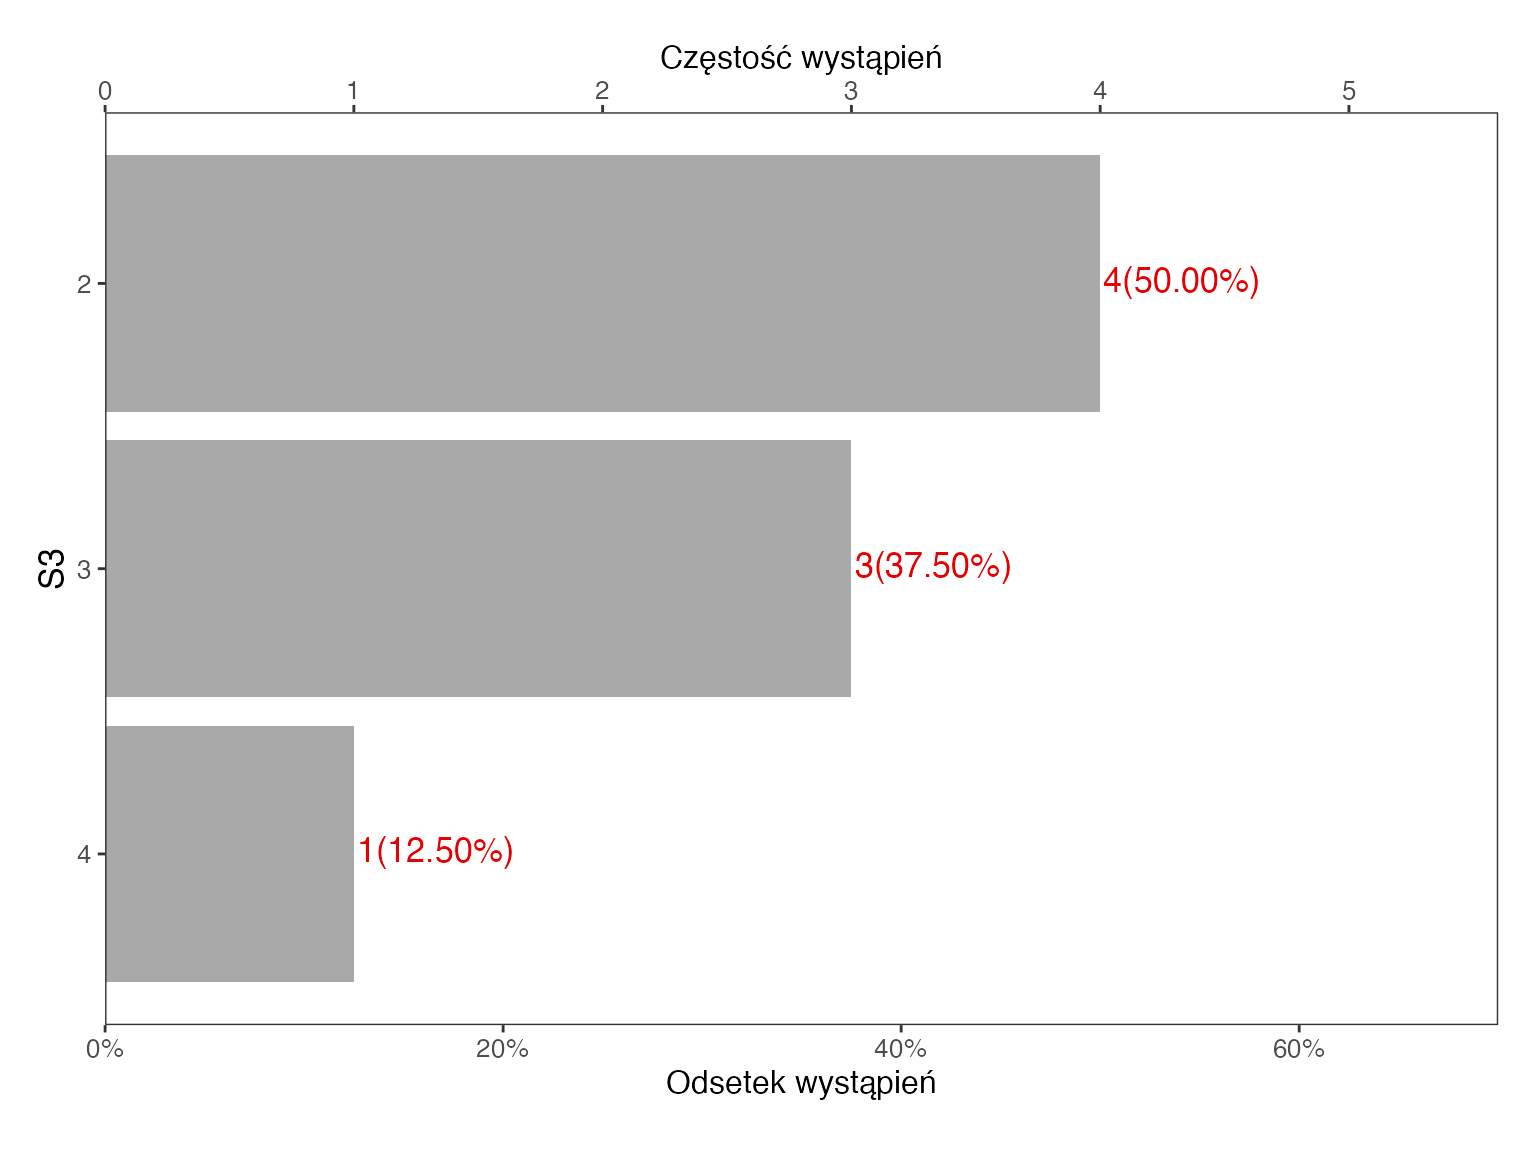
Daj ankietę 5–10 osobom z Twojej populacji i zapytaj, które pytania były niejasne. Zmierz czas wypełniania. Sprawdź rozkład odpowiedzi (Rys. 1): pytanie, na które prawie wszyscy odpowiadają tak samo, nie różnicuje badanych. W naszej mini-ankiecie (8 osób) pytanie S4 przed odwróceniem korelowało ujemnie z pozostałymi – tak jak powinno – a po odwróceniu skala miała α = 0,88. Jeśli po pilotażu zmieniasz pytania, jego odpowiedzi nie wchodzą do właściwej analizy. Co dalej z danymi, opisujemy w poradniku jak opracować wyniki ankiety.
Ile osób do ankiety?
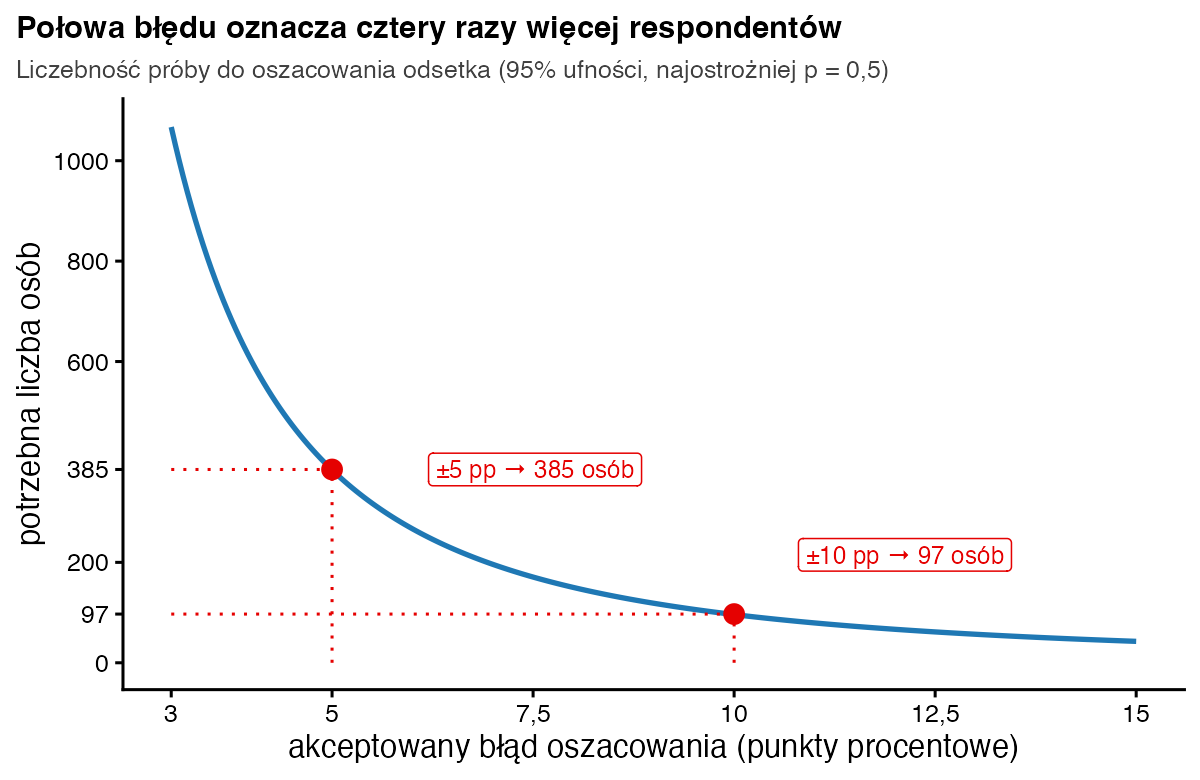
To zależy od celu. Jeśli chcesz oszacować odsetek, np. ilu studentów odczuwa silny stres, skorzystaj ze wzoru:
gdzie \(z\) = 1,96 dla 95% ufności, \(p\) to spodziewany odsetek (najostrożniej 0,5), a \(e\) – akceptowany błąd. Dla błędu ±10 punktów procentowych wychodzi 97 osób, a dla ±5 – 385 (Rys. 2). Przy populacji liczącej 2000 osób poprawka obniża tę liczbę do 323. Jeśli porównujesz grupy, decyduje moc testu: do wykrycia średniego efektu (d = 0,5) z mocą 80% potrzeba 64 osób w każdej grupie, a do wykrycia korelacji r = 0,3 – 85 osób (Cohen, 1992). „Sto osób wystarczy” to zwyczaj, a nie reguła statystyczna.
Jak policzyć liczebność próby w R?
# Ile osób do ankiety? Poziom ufności 95%
z <- qnorm(0.975)                                          # 1,96

# 1) Szacowanie odsetka (np. ilu studentów odczuwa silny stres) z błędem ±e
n_odsetek <- function(e, p = 0.5) z^2 * p * (1 - p) / e^2  # p = 0,5 to wariant najostrożniejszy
ceiling(n_odsetek(c(0.10, 0.05)))                          # błąd ±10 i ±5 punktów procentowych

# 2) Poprawka dla małej populacji (np. 2000 studentów wydziału)
n0 <- n_odsetek(0.05); N <- 2000
ceiling(n0 / (1 + (n0 - 1) / N))

# 3) Porównanie dwóch grup testem t: średni efekt d = 0,5, moc 80%
ceiling(power.t.test(delta = 0.5, sd = 1, sig.level = 0.05, power = 0.80)$n)   # osób w KAŻDEJ grupie

# 4) Korelacja r = 0,3 (efekt umiarkowany), moc 80% – przybliżenie Fishera
ceiling(((z + qnorm(0.80)) / atanh(0.3))^2 + 3)
Wynik w konsoli R:
[1]  97 385
[1] 323
[1] 64
[1] 85
Etyka i RODO w ankiecie
- Na początku napisz, kto prowadzi badanie i w jakim celu, ile trwa, że udział jest dobrowolny i anonimowy oraz z kim się kontaktować.
- Zbieraj tylko dane potrzebne do hipotez (zasada minimalizacji danych z RODO). Nie proś o imię ani e-mail, jeśli ich nie potrzebujesz.
- Uważaj na metryczkę: wiek, kierunek i rok studiów razem mogą zidentyfikować osobę z małej grupy.
- Przy pytaniach o zdrowie psychiczne podaj, gdzie szukać pomocy, i sprawdź, czy uczelnia wymaga zgody komisji etycznej.
Ankieta do pracy magisterskiej i licencjackiej – pytania studentów
„Pytania otwarte czy zamknięte?” Do sprawdzania hipotez – zamknięte i skale. Otwarte zostaw do eksploracji. Rada „unikaj pytań zamkniętych” jest błędna; unikać trzeba pytań niejasnych.
„Czy opracowanie ankiety w pracy licencjackiej wygląda inaczej?” Nie. Zwykle jest mniej hipotez i mniejsza próba, ale operacjonalizacja, pilotaż i RODO obowiązują tak samo.
„Czy mogę uogólnić wyniki na wszystkich studentów?” Tylko przy doborze losowym. Dobór wygodny, typowy w pracach dyplomowych, opisz w ograniczeniach. Gdzie zebrać odpowiedzi, przeczytasz w poradniku gdzie zrobić ankietę do pracy magisterskiej.
Najczęstsze błędy
- Pytania „na wszelki wypadek”, niezwiązane z żadną hipotezą.
- Pytania podwójne, np. „Czy wykładowcy są kompetentni i życzliwi?”.
- Jedno pytanie zamiast skali do pomiaru postawy.
- Brak pilotażu.
- Nieprzekodowane pytanie odwrócone przy liczeniu wyniku skali.
Bibliografia
- Likert, R. (1932). A technique for the measurement of attitudes. Archives of Psychology, 22(140), 1–55.
- Norman, G. (2010). Likert scales, levels of measurement and the “laws” of statistics. Advances in Health Sciences Education, 15(5), 625–632. https://doi.org/10.1007/s10459-010-9222-y
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. https://doi.org/10.1037/0033-2909.112.1.155
- Cochran, W. G. (1977). Sampling techniques (3rd ed.). Wiley.
- Dillman, D. A., Smyth, J. D., & Christian, L. M. (2014). Internet, phone, mail, and mixed-mode surveys: The tailored design method (4th ed.). Wiley.
- Rozporządzenie Parlamentu Europejskiego i Rady (UE) 2016/679 z dnia 27 kwietnia 2016 r. w sprawie ochrony osób fizycznych w związku z przetwarzaniem danych osobowych i w sprawie swobodnego przepływu takich danych oraz uchylenia dyrektywy 95/46/WE (ogólne rozporządzenie o ochronie danych). Dz. Urz. UE L 119 z 4.05.2016, s. 1–88.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikOpracowanie wyników ankiety
- PoradnikJak opracować wyniki ankiety krok po kroku
- PoradnikJak opisać wyniki ankiety w pracy magisterskiej
- Słownik wzorówCzęstości i procenty
- Słownik wzorówAlfa Cronbacha
- Słownik wzorówTest chi-kwadrat
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.