

Test Shapiro-Wilka – wzór, interpretacja i przykład
Test Shapiro-Wilka sprawdza, czy wyniki mogą pochodzić z rozkładu normalnego. Typowe pytanie z pracy dyplomowej: czy mogę użyć testu t albo ANOVA, czy rozkład punktów w grupach za bardzo odbiega od normalnego?
W prostych słowachTest ustawia Twoje wyniki od najmniejszego do największego i porównuje je z tym, jak powinny wyglądać wyniki z idealnego rozkładu normalnego. Statystyka W mówi, jak dobrze oba szeregi do siebie pasują: 1 oznacza dopasowanie idealne. Małe p sygnalizuje, że odchylenie od normalności jest większe, niż mógłby dać przypadek.
Kiedy stosować test Shapiro-Wilka?
- sprawdzasz założenie normalności przed testem t, ANOVA albo korelacją Pearsona;
- normalność oceniasz tam, gdzie wymaga jej metoda: osobno w każdej grupie albo na resztach modelu (ANOVA, regresja), a nie na wszystkich wynikach wrzuconych do jednego worka;
- masz od 3 do 5000 obserwacji (tyle obsługuje funkcja
shapiro.test()w R); - wynik testu zawsze zestawiasz z wykresem Q-Q i histogramem.
Jak wygląda wzorcowy kształt, przypomnisz sobie w haśle o rozkładzie normalnym. Odchylenia opiszesz liczbowo skośnością i kurtozą. Gdy rozkład wyraźnie nie jest normalny, a grupy są małe, sięgnij po testy nieparametryczne, np. test U Manna-Whitneya.
Wzór na statystykę W
- \(x_{(i)}\)
- i-ty wynik po ustawieniu wszystkich od najmniejszego do największego (to nie jest ranga, tylko sama wartość)
- \(a_i\)
- współczynniki z tablic Shapiro i Wilka (1965); zależą tylko od n, są symetryczne ze zmienionym znakiem (\(a_1 = -a_n\)), a ich kwadraty sumują się do 1
- licznik
- „ważona rozpiętość” wyników – taka, jakiej oczekujemy, gdy rozkład jest normalny
- mianownik
- suma kwadratów odchyleń od średniej
- \(W\)
- im bliżej 1, tym lepsza zgodność z rozkładem normalnym; hipoteza zerowa brzmi: dane pochodzą z rozkładu normalnego
Przykład krok po kroku
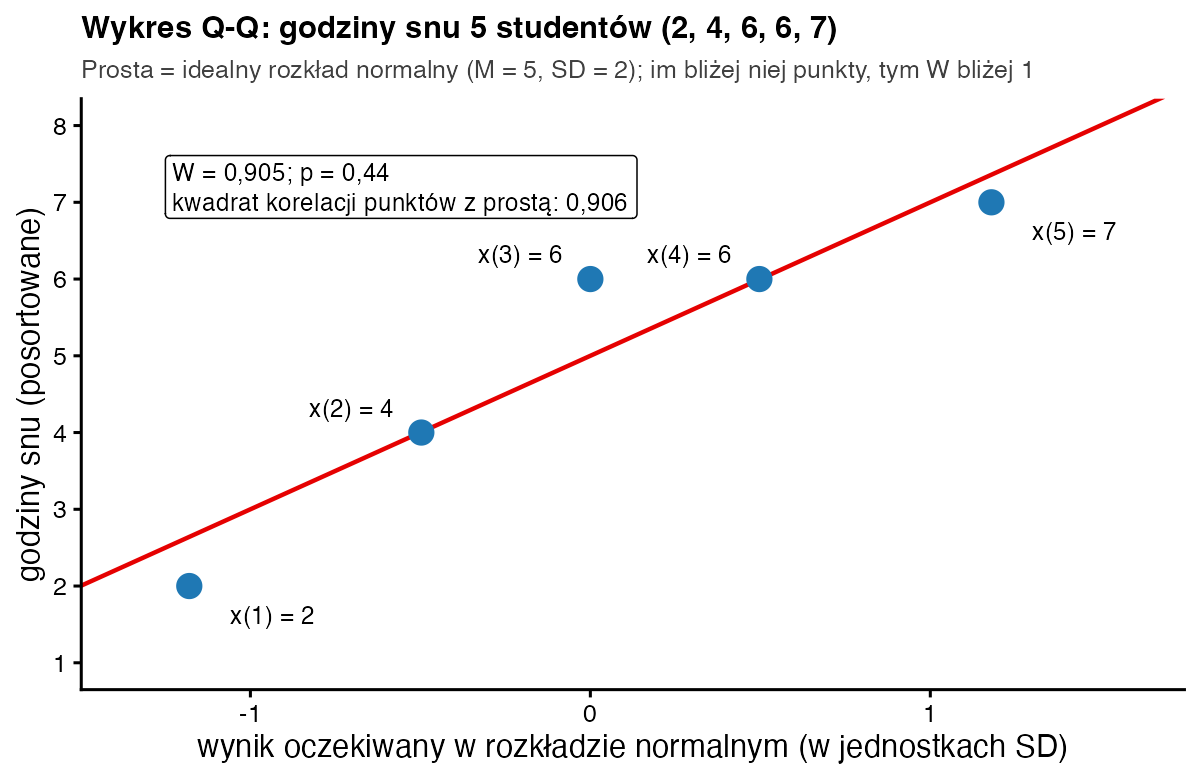
Pięcioro studentów zapisało, ile godzin spało przed kolokwium: 6, 2, 7, 4, 6. Średnia wynosi 5 godzin. Współczynniki \(a_i\) dla n = 5 odczytujemy z tablic.
| i | x(i) | x(i) − 5 | (x(i) − 5)² | ai | ai · x(i) |
|---|---|---|---|---|---|
| 1 | 2 | −3 | 9 | −0,6646 | −1,329 |
| 2 | 4 | −1 | 1 | −0,2413 | −0,965 |
| 3 | 6 | 1 | 1 | 0 | 0 |
| 4 | 6 | 1 | 1 | 0,2413 | 1,448 |
| 5 | 7 | 2 | 4 | 0,6646 | 4,652 |
| Σ = 25 | 0 | 16 | 3,806 |
- Uporządkuj wyniki. 2, 4, 6, 6, 7; średnia = 25 / 5 = 5.
- Mianownik. 9 + 1 + 1 + 1 + 4 = 16.
- Licznik. Suma iloczynów \(a_i x_{(i)}\) wynosi 3,806. Szybciej: 0,6646 · (7 − 2) + 0,2413 · (6 − 4) = 3,323 + 0,483 = 3,806. Do kwadratu: 14,48.
- Statystyka W. W = 14,48 / 16 = 0,905.
- Wartość p. Program podaje p = 0,44. To więcej niż 0,05, więc nie ma podstaw do odrzucenia hipotezy o normalności.
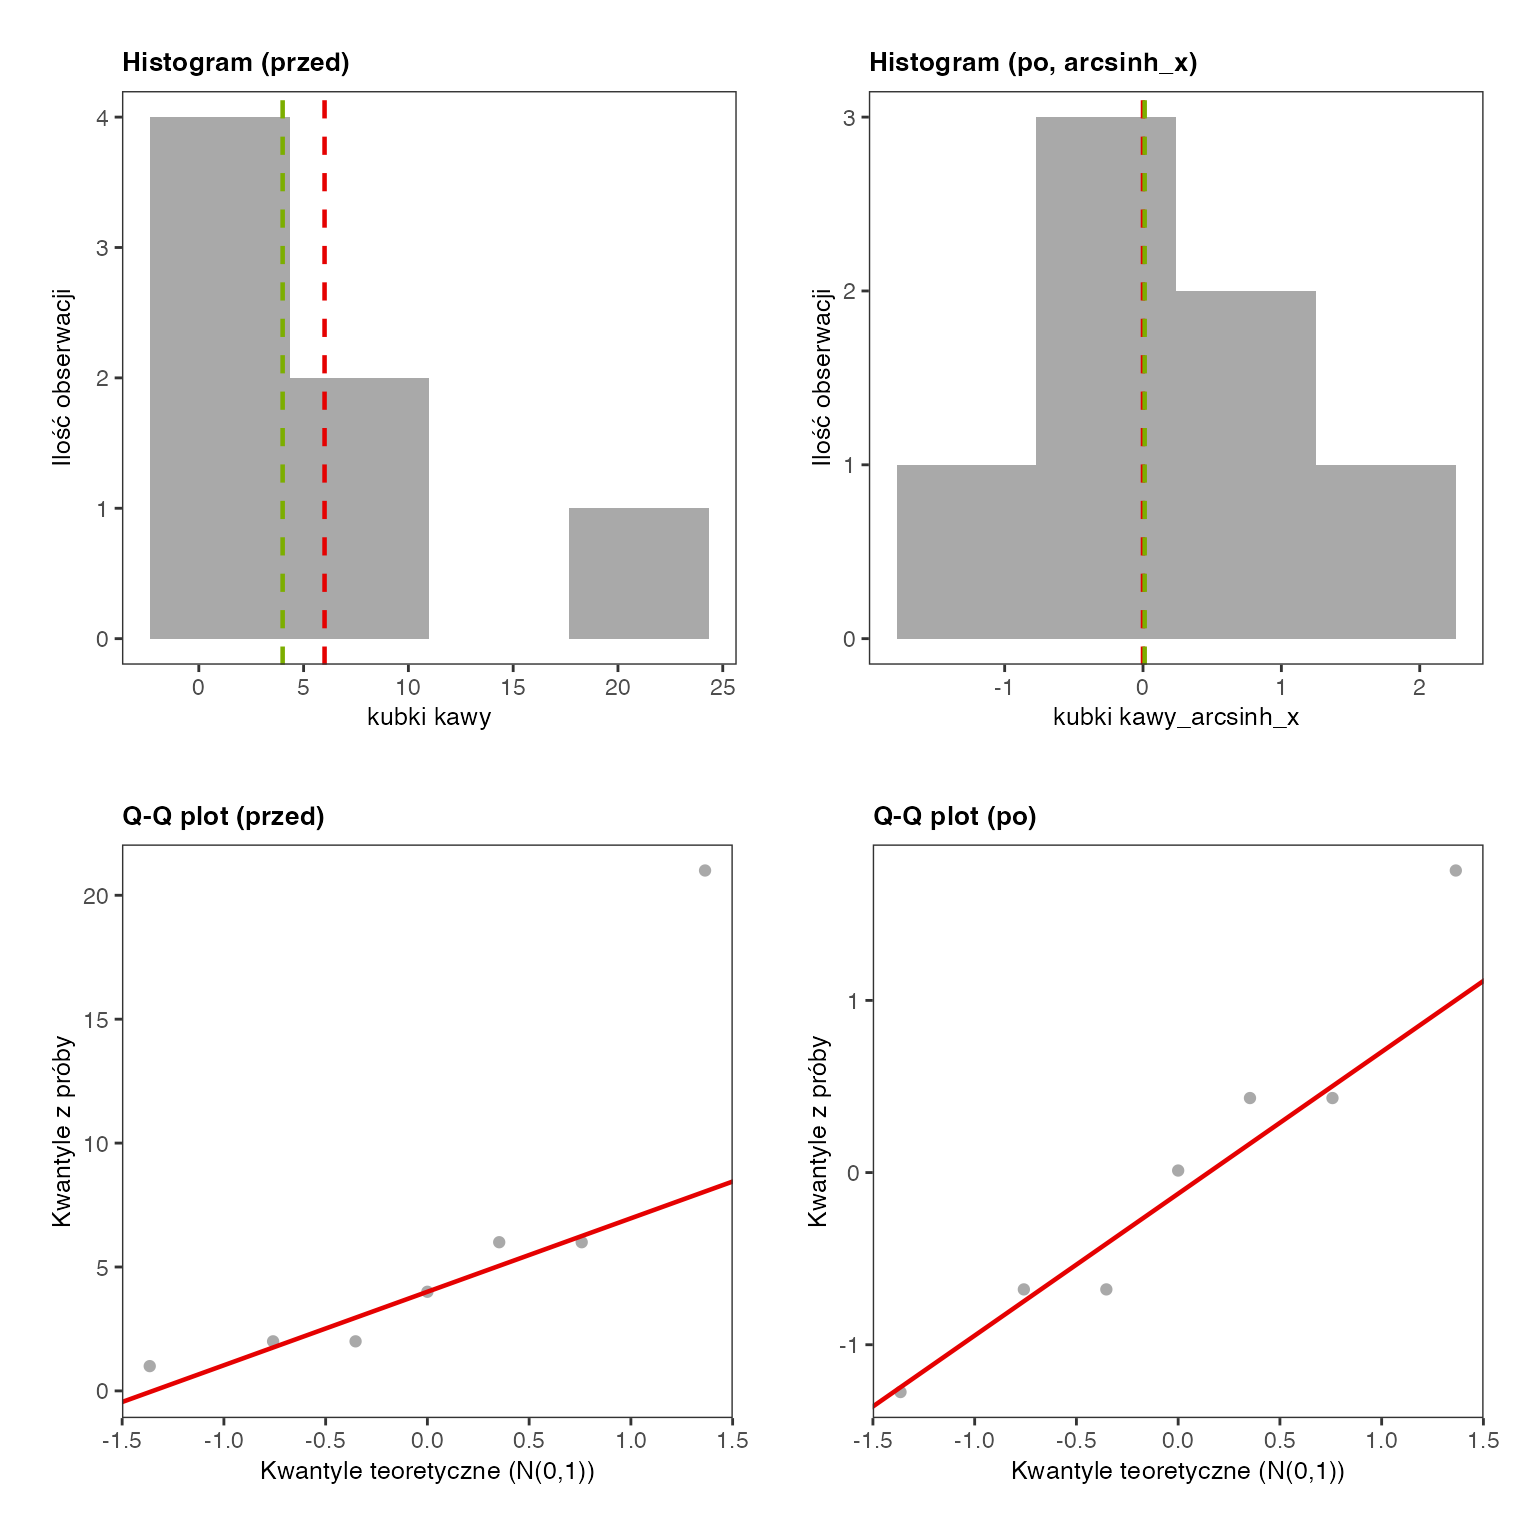
- Lekcja. Przy pięciu osobach test prawie niczego nie wykryje. Dla porównania liczba kubków kawy w tygodniu 1, 2, 2, 4, 6, 6, 21 daje W = 0,71 i p = 0,005 – jedna skrajna wartość wystarcza, żeby odrzucić normalność.
Jak zinterpretować i opisać wynik?
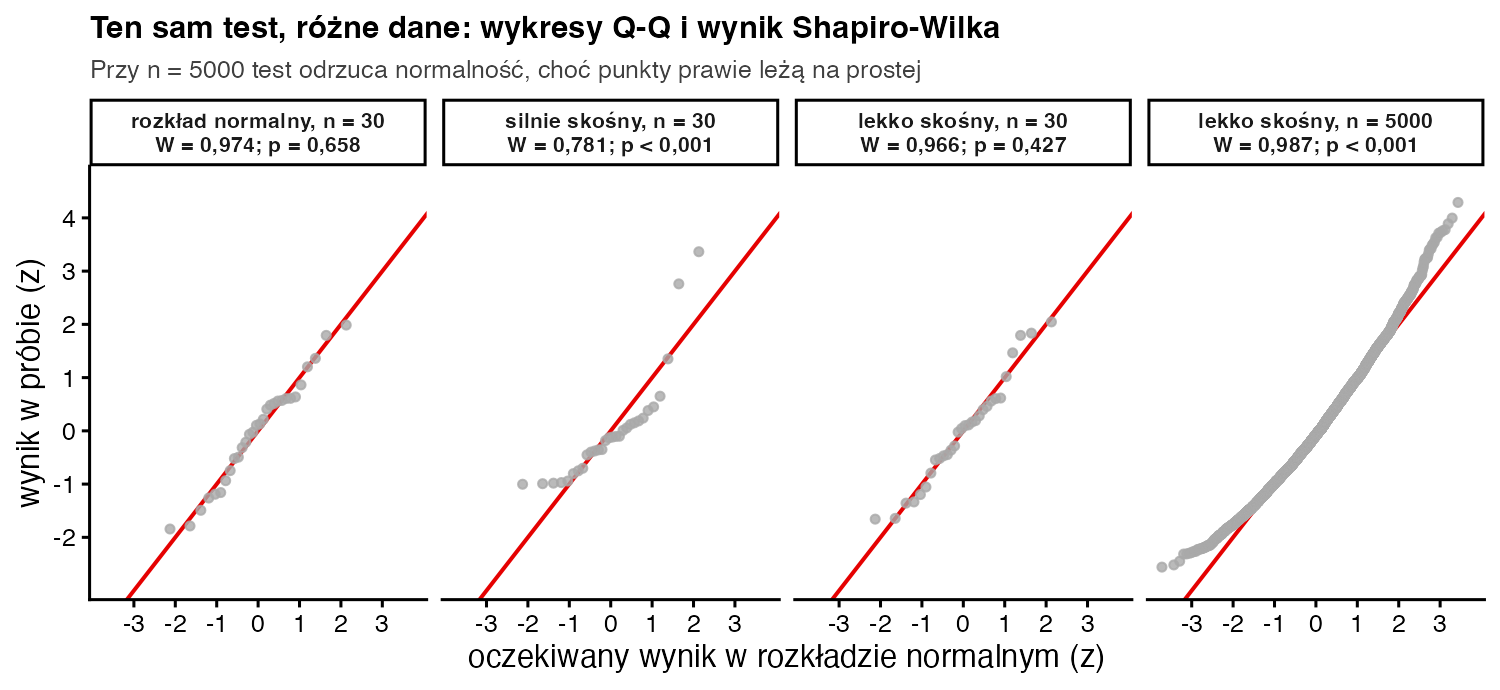
Gdy p > 0,05, piszesz: „brak podstaw do odrzucenia hipotezy o normalności rozkładu”. Nie pisz „rozkład jest normalny” – test tylko nie znalazł dowodów przeciw. Gdy p ≤ 0,05, rozkład istotnie różni się od normalnego. Pamiętaj o dwóch pułapkach. Przy małych próbach test ma niską moc, więc przepuszcza nawet wyraźne odchylenia. Przy dużych próbach wyłapuje drobiazgi bez znaczenia, a test t i ANOVA przy kilkudziesięciu osobach w grupie i tak dobrze znoszą umiarkowaną skośność. Dlatego decyzję opieraj na teście, wykresie Q-Q i skośności łącznie (Ghasemi i Zahediasl, 2012).
Zapis w stylu APA: Rozkład liczby godzin snu nie odbiegał istotnie od rozkładu normalnego, W = 0,91; p = 0,440. Rozkład liczby kubków kawy istotnie różnił się od normalnego, W = 0,71; p = 0,005.
Jak policzyć test Shapiro-Wilka w R?
sen <- c(6, 2, 7, 4, 6)

# 1) „ręcznie”: W ze współczynników a_i z tablic Shapiro i Wilka (n = 5)
a <- c(-0.6646, -0.2413, 0, 0.2413, 0.6646)
b <- sum(a * sort(sen))                    # licznik przed podniesieniem do kwadratu
W <- b^2 / sum((sen - mean(sen))^2)
W                                          # 0.905

# 2) gotową funkcją (algorytm Roystona)
shapiro.test(sen)

# 3) kontrprzykład: kubki kawy w tygodniu z jedną skrajną wartością
shapiro.test(c(1, 2, 2, 4, 6, 6, 21))$p.value

# 4) wykres Q-Q – oglądaj go zawsze razem z testem
qqnorm(sen); qqline(sen, col = "red")

# w ANOVA lub regresji testuj reszty modelu, np.:
# shapiro.test(residuals(lm(punkty ~ grupa, data = dane)))
Wynik w konsoli R:
[1] 0.905162

	Shapiro-Wilk normality test

data:  sen
W = 0.90531, p-value = 0.4399

[1] 0.004631144
Wynik „ręczny” (0,9052) minimalnie różni się od wyniku funkcji (0,9053), bo R liczy współczynniki \(a_i\) algorytmem Roystona (1995), a nie z czterocyfrowych tablic.
Shapiro-Wilk czy Kołmogorow-Smirnow?
Przy próbach typowych dla prac dyplomowych wybierz test Shapiro-Wilka. W porównaniach symulacyjnych wykrywa odchylenia od normalności częściej niż test Kołmogorowa-Smirnowa (Razali i Wah, 2011). Jeśli promotor lub program wymaga testu Kołmogorowa-Smirnowa, użyj wersji z poprawką Lillieforsa. Klasyczna wersja zakłada, że średnią i odchylenie standardowe populacji znasz z góry, a nie liczysz ich z próby.
Najczęstsze błędy
- Testowanie wszystkich wyników razem zamiast osobno w każdej grupie albo na resztach modelu.
- Pisanie „p > 0,05, więc rozkład jest normalny” – to tylko brak podstaw do odrzucenia normalności.
- Ślepe zaufanie testowi przy setkach obserwacji, gdy p < 0,05 wynika z drobnych, nieistotnych praktycznie odchyleń.
- Pomijanie wykresu Q-Q i histogramu.
- Mylenie \(x_{(i)}\) z rangą albo liczenie W z błędnymi współczynnikami – W nigdy nie przekracza 1.
Bibliografia
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3–4), 591–611. https://doi.org/10.1093/biomet/52.3-4.591
- Royston, P. (1995). Remark AS R94: A remark on algorithm AS 181: The W-test for normality. Journal of the Royal Statistical Society. Series C (Applied Statistics), 44(4), 547–551. https://doi.org/10.2307/2986146
- Razali, N. M., & Wah, Y. B. (2011). Power comparisons of Shapiro-Wilk, Kolmogorov-Smirnov, Lilliefors and Anderson-Darling tests. Journal of Statistical Modeling and Analytics, 2(1), 21–33.
- Ghasemi, A., & Zahediasl, S. (2012). Normality tests for statistical analysis: A guide for non-statisticians. International Journal of Endocrinology and Metabolism, 10(2), 486–489. https://doi.org/10.5812/ijem.3505
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówRozkład normalny
- Słownik wzorówSkośność
- Słownik wzorówTest t Studenta dla prób niezależnych
- Słownik wzorówTest U Manna-Whitneya
- PoradnikTesty parametryczne
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.