

Test t Studenta dla prób zależnych – wzór i przykład
Test t dla prób zależnych sprawdza, czy średnia zmiana u tych samych osób (np. przed i po) jest większa, niż mógłby ją „zrobić” przypadek. Typowe pytanie z pracy dyplomowej: czy po warsztatach studenci zdobywają więcej punktów w teście wiedzy niż przed nimi?
W prostych słowachZamiast porównywać dwie kolumny wyników, test patrzy na zmianę u każdej osoby. Liczy średnią z tych zmian i sprawdza, ile razy jest ona większa od „szumu”, czyli od tego, jak bardzo zmiany różnią się między osobami. Jeśli prawie wszyscy poprawili się o podobną liczbę punktów, nawet niewielki przyrost bywa istotny.
Kiedy stosować test t dla prób zależnych?
- te same osoby zmierzono dwa razy (przed i po, rano i wieczorem) albo masz dobrane pary (np. rodzeństwo);
- zmienna jest ilościowa (punkty, czas, wynik skali);
- rozkład różnic między pomiarami jest zbliżony do normalnego – sprawdzasz różnice, a nie surowe wyniki, np. testem Shapiro-Wilka;
- każda osoba ma oba pomiary – osoba z jednym wynikiem wypada z analizy.
Gdy różnice są wyraźnie skośne albo dane są porządkowe (np. ocena 1–5), wybierz test Wilcoxona. Gdy pomiarów jest więcej niż dwa – ANOVA z powtarzanymi pomiarami. Dwie różne grupy osób porównasz testem t dla prób niezależnych.
Wzór na test t dla prób zależnych
- \(d_i\)
- różnica u i-tej osoby: wynik „po” minus wynik „przed”
- \(\bar{d}\)
- średnia różnica, czyli przeciętna zmiana w grupie
- \(s_d\)
- odchylenie standardowe różnic – mówi, jak bardzo zmiany różnią się między osobami
- \(n\)
- liczba par, czyli osób z oboma pomiarami
- \(s_d / \sqrt{n}\)
- błąd standardowy średniej różnicy – „szum” w mianowniku
- \(df\)
- stopnie swobody – potrzebne, żeby odczytać wartość p
Przykład krok po kroku
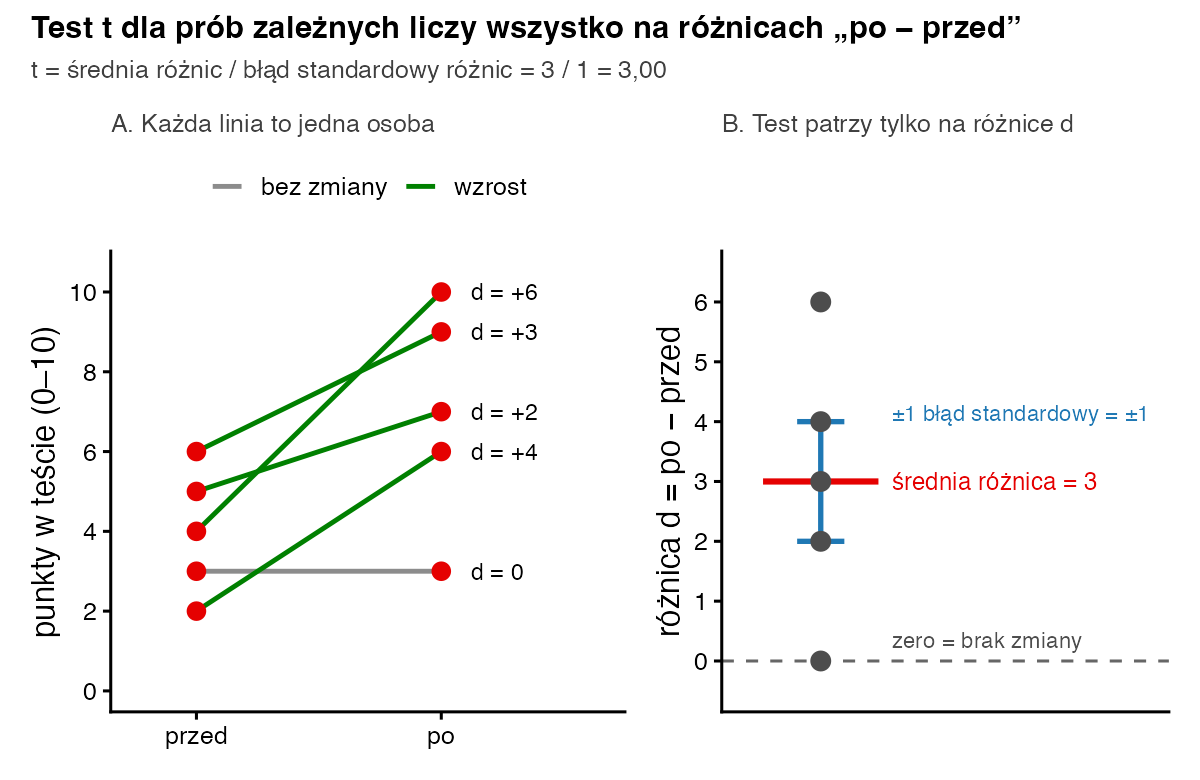
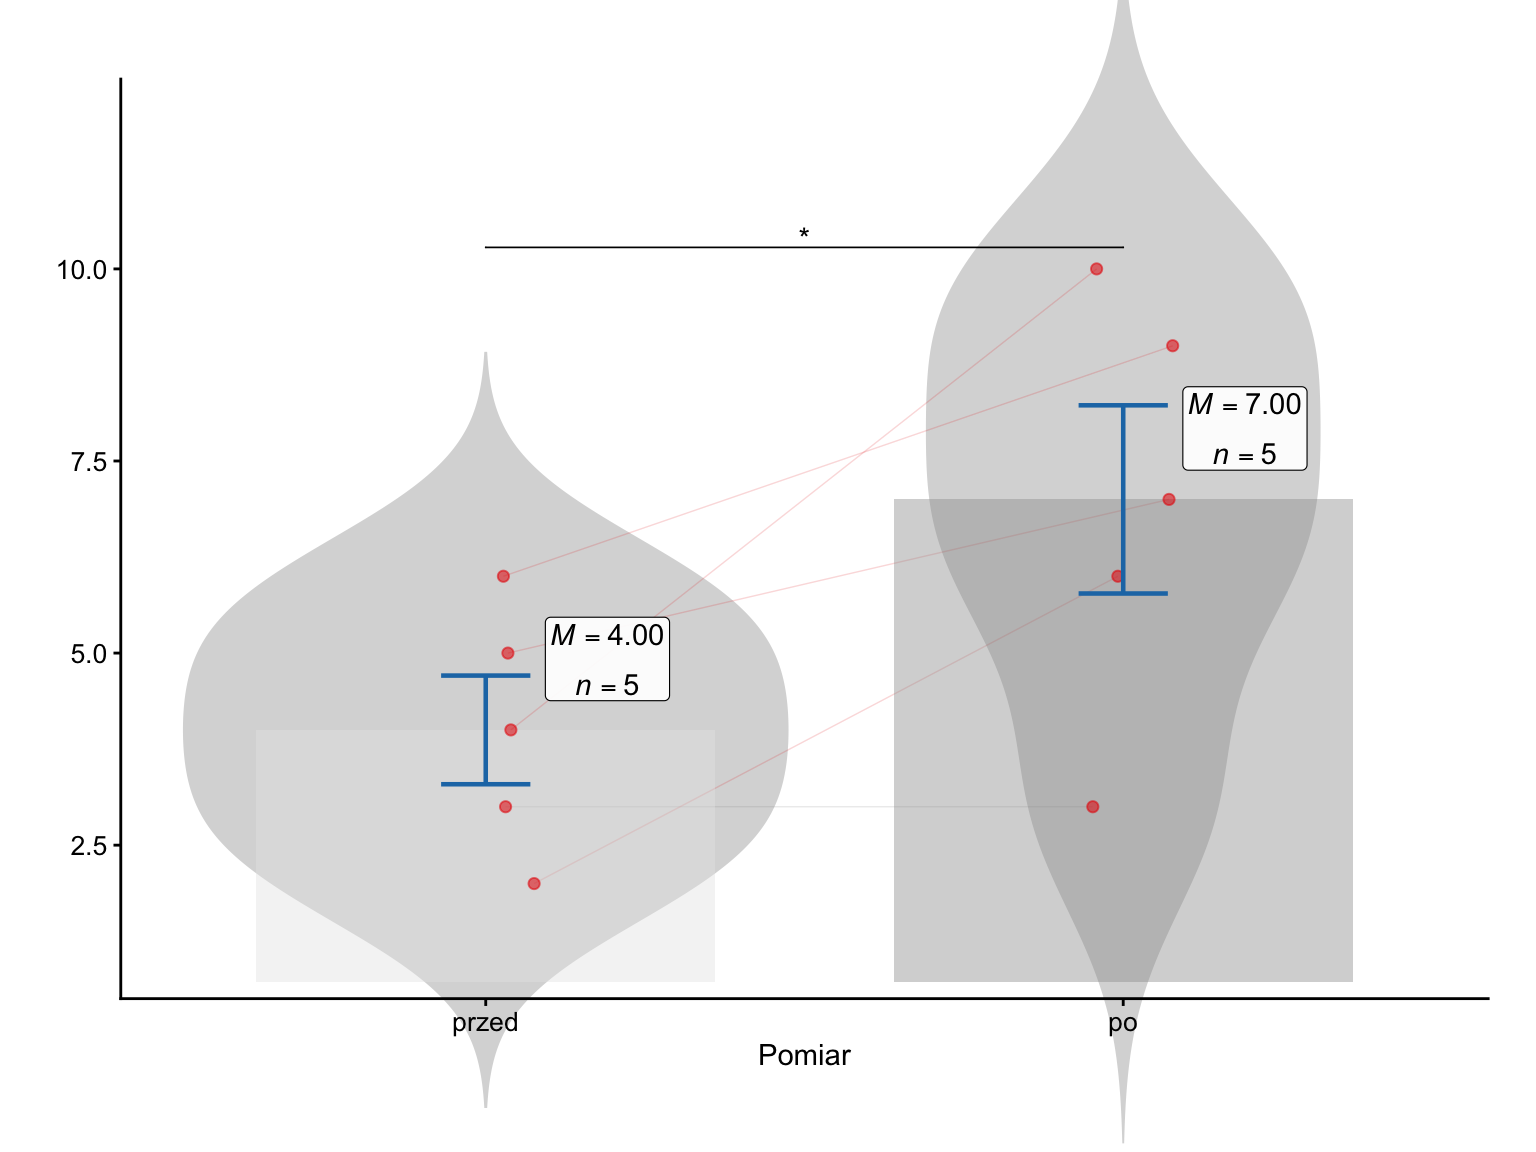
Pięcioro studentów napisało krótki test wiedzy (0–10 punktów) przed warsztatami z pisania pracy i po nich. Od wyniku „po” odejmujemy wynik „przed” u każdej osoby.
| Osoba | Przed | Po | d = po − przed | d − 3 | (d − 3)² |
|---|---|---|---|---|---|
| 1 | 5 | 7 | 2 | −1 | 1 |
| 2 | 3 | 3 | 0 | −3 | 9 |
| 3 | 6 | 9 | 3 | 0 | 0 |
| 4 | 4 | 10 | 6 | 3 | 9 |
| 5 | 2 | 6 | 4 | 1 | 1 |
| Σ | 20 | 35 | 15 | 0 | 20 |
- Średnia różnica. \(\bar{d} = 15 / 5 = 3\) punkty. To tyle samo co różnica średnich: 7 − 4 = 3.
- Odchylenie standardowe różnic. Suma kwadratów odchyleń wynosi 20, więc \(s_d = \sqrt{20 / 4} = \sqrt{5} \approx 2{,}24\).
- Mianownik („szum”). \(s_d / \sqrt{n} = \sqrt{5} / \sqrt{5} = 1\).
- Statystyka t. t = 3 / 1 = 3,00; stopnie swobody df = 5 − 1 = 4.
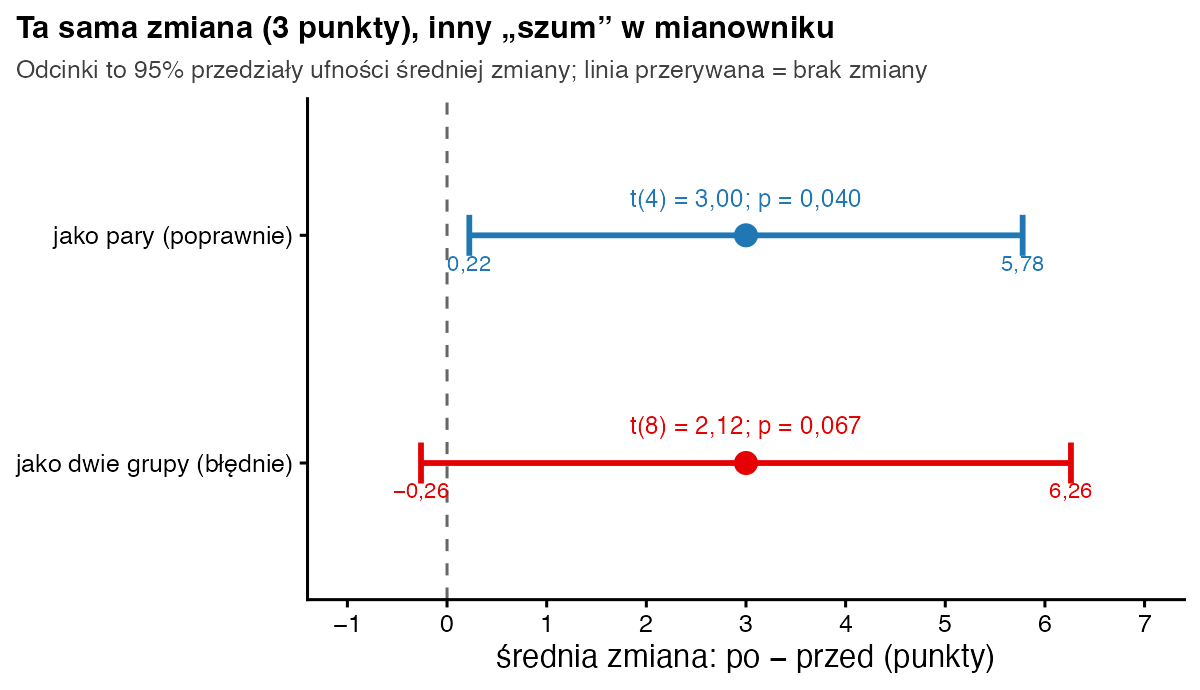
- Wartość p. Dla t = 3,00 i df = 4 program podaje p = 0,040. To mniej niż 0,05, więc wzrost uznajemy za istotny statystycznie. 95% przedział ufności dla średniej zmiany wynosi od 0,22 do 5,78 punktu.
- Wielkość efektu. \(d_z = \bar{d} / s_d = 3 / 2{,}24 \approx 1{,}34\) – to jedna z wersji d Cohena dla prób zależnych.
Jak zinterpretować i opisać wynik?
Po warsztatach studenci zdobywali średnio o 3 punkty więcej. Gdyby warsztaty niczego nie zmieniały, średnią zmianę tak dużą lub większą otrzymalibyśmy tylko w około 4% podobnych badań – to właśnie mówi wartość p. Siłę efektu opisuje dz = 1,34; umownie 0,8 i więcej to efekt duży (Cohen, 1988). Dla prób zależnych istnieje kilka wersji d, więc napisz, którą podajesz (Lakens, 2013). Bez grupy kontrolnej nie wiesz też, czy wzrost wynika z warsztatów, czy np. z ponownego rozwiązywania podobnego testu.
Zapis w stylu APA: Po warsztatach studenci uzyskiwali istotnie więcej punktów (M = 7,00; SD = 2,74) niż przed nimi (M = 4,00; SD = 1,58), t(4) = 3,00; p = 0,040; dz = 1,34; 95% CI dla różnicy [0,22; 5,78].
Jak policzyć test t dla prób zależnych w R?
przed <- c(5, 3, 6, 4, 2)
po    <- c(7, 3, 9, 10, 6)

# 1) „ręcznie”, dokładnie według wzoru
d <- po - przed                              # różnice: 2 0 3 6 4
t <- mean(d) / (sd(d) / sqrt(length(d)))
t                                            # 3

# 2) gotową funkcją (paired = TRUE to test dla prób zależnych)
t.test(po, przed, paired = TRUE)

# 3) wielkość efektu d_z = średnia różnic / SD różnic
mean(d) / sd(d)                              # 1.34
Wynik w konsoli R:
[1] 3

	Paired t-test

data:  po and przed
t = 3, df = 4, p-value = 0.03994
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 0.2235549 5.7764451
sample estimates:
mean difference
              3

[1] 1.341641
Kolejność ma znaczenie: t.test(po, przed, paired = TRUE) liczy różnice „po − przed”, więc dodatnie t oznacza wzrost. I-ty wynik w obu wektorach musi należeć do tej samej osoby.
Test t dla prób zależnych czy niezależnych – jak wybrać?
Zadaj sobie jedno pytanie: czy każdy wynik z pierwszej kolumny ma „swojego partnera” w drugiej? Jeśli tak (ta sama osoba albo dobrana para) – wybierz test dla prób zależnych. Jeśli w kolumnach są różne osoby – test dla prób niezależnych. Pomyłka zwykle zabiera moc: tu test dla grup niezależnych dał p = 0,067 zamiast 0,040 (Rys. 3). Test t dla prób zależnych to w praktyce test t dla jednej próby wykonany na różnicach, z wartością odniesienia 0.
Najczęstsze błędy
- Użycie testu dla prób niezależnych, gdy te same osoby zbadano dwa razy.
- Sprawdzanie normalności osobno „przed” i „po” zamiast na różnicach.
- Przestawiona kolejność osób w jednej z kolumn – różnice tracą wtedy sens.
- Pisanie „przyjęto H0”, gdy p > 0,05. Poprawnie: „brak podstaw do odrzucenia H0”.
- Podawanie „d Cohena” bez informacji, którą wersję policzono (dz, dav).
Bibliografia
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, 863. https://doi.org/10.3389/fpsyg.2013.00863
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest Wilcoxona
- Słownik wzorówTest t Studenta dla prób niezależnych
- Słownik wzorówd Cohena – wielkość efektu
- PoradnikTest t Studenta – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportTest t Studenta
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.