

Odchylenie standardowe populacji (σ) – wzór i różnica z SD z próby
Odchylenie standardowe populacji (σ, „sigma”) liczysz wtedy, gdy masz wyniki wszystkich osób, o których chcesz coś powiedzieć, a nie tylko ich części. Typowe pytanie: który wzór wybrać, gdy opisuję próbę studentów, a który, gdy zbadałem całą grupę bez wyjątku?
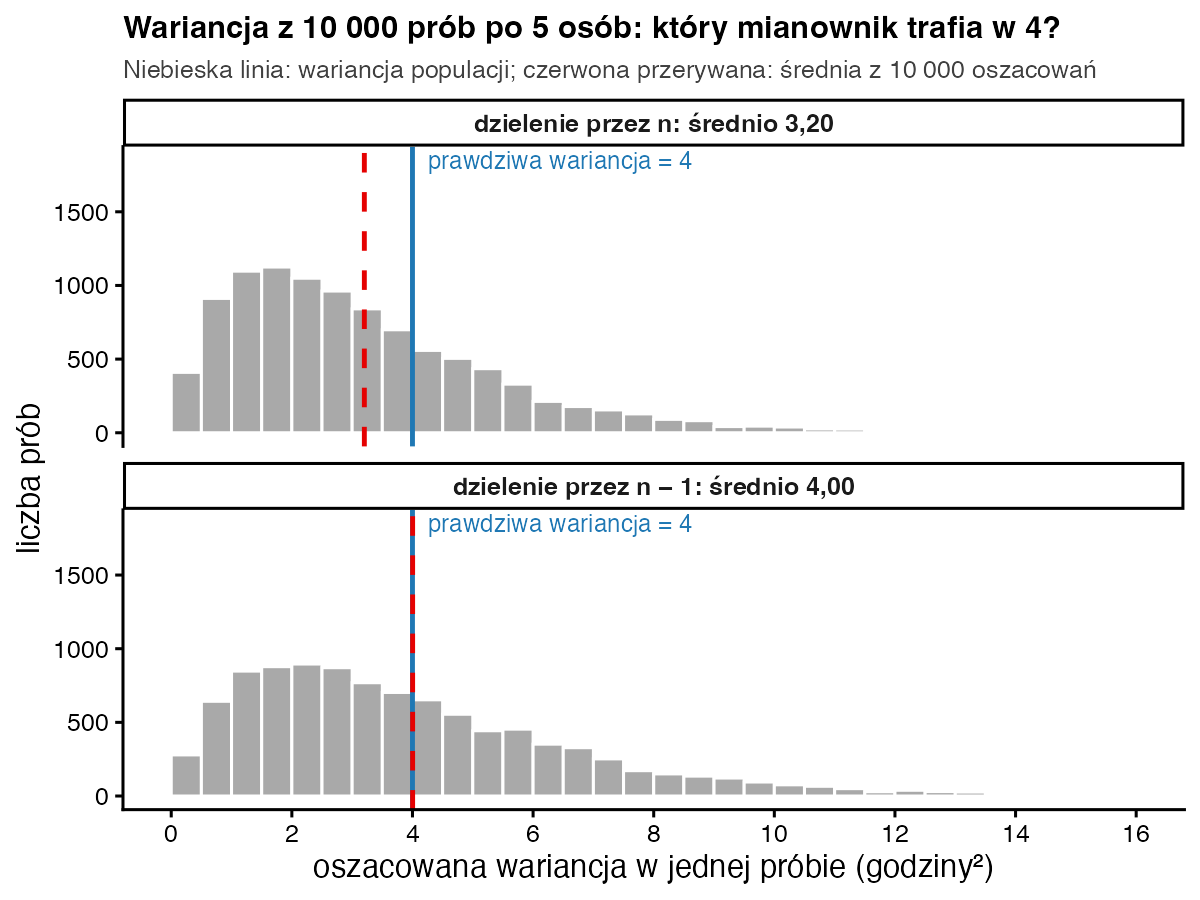
W prostych słowachOba wzory mierzą to samo: jak daleko wyniki typowo leżą od średniej. Różnią się tylko mianownikiem. Dla populacji dzielisz przez liczbę wszystkich osób (N), a dla próby – przez n − 1. Wersja z próby wychodzi odrobinę większa, bo „nadrabia” to, że średnią liczysz z tych samych danych.
Kiedy stosować odchylenie standardowe populacji?
- dane obejmują całą grupę, o której piszesz, i nie uogólniasz wniosków dalej (np. wszyscy mieszkańcy jednego pokoju w akademiku);
- znasz σ z zewnątrz, np. z norm testu psychologicznego, i podstawiasz je do wzoru na wynik z;
- uczysz się teorii: σ i μ to parametry populacji, a s i x̄ – ich oszacowania z próby.
W pracy dyplomowej prawie zawsze badasz próbę, więc potrzebujesz odchylenia standardowego z próby (dzielenie przez n − 1). Tam znajdziesz też pełną interpretację SD. Znane σ wykorzystasz w haśle o rozkładzie normalnym, gdzie zamieniasz wynik na wynik z. Jak z rozkładu statystyki testu powstaje wartość p, przeczytasz w haśle o istotności statystycznej.
Wzór na odchylenie standardowe populacji
- \(\sigma\)
- odchylenie standardowe populacji (grecka litera sigma)
- \(\mu\)
- średnia populacji (grecka litera mi)
- \(N\)
- liczba wszystkich osób w populacji
- \(s,\ \bar{x},\ n\)
- odchylenie standardowe, średnia i liczebność z próby
- \(\sigma = s\sqrt{(N-1)/N}\)
- przeliczenie wyniku programu (s) na σ dla tych samych danych
Przykład krok po kroku
Pięcioro studentów mieszka w jednym pokoju w akademiku. Interesuje Cię tylko ten pokój, więc te pięć osób to cała populacja. Ich godziny snu przed kolokwium to znane z hasła o średniej arytmetycznej 6, 2, 7, 4, 6.
| x | x − 5 | (x − 5)² |
|---|---|---|
| 6 | 1 | 1 |
| 2 | −3 | 9 |
| 7 | 2 | 4 |
| 4 | −1 | 1 |
| 6 | 1 | 1 |
| Σ = 25 | 0 | 16 |
- Średnia populacji. μ = 25 / 5 = 5 godzin.
- Suma kwadratów odchyleń. 1 + 9 + 4 + 1 + 1 = 16.
- Wariancja populacji. σ² = 16 / 5 = 3,2 (w próbie byłoby 16 / 4 = 4).
- Odchylenie standardowe populacji. σ = √3,2 = 1,79 godziny.
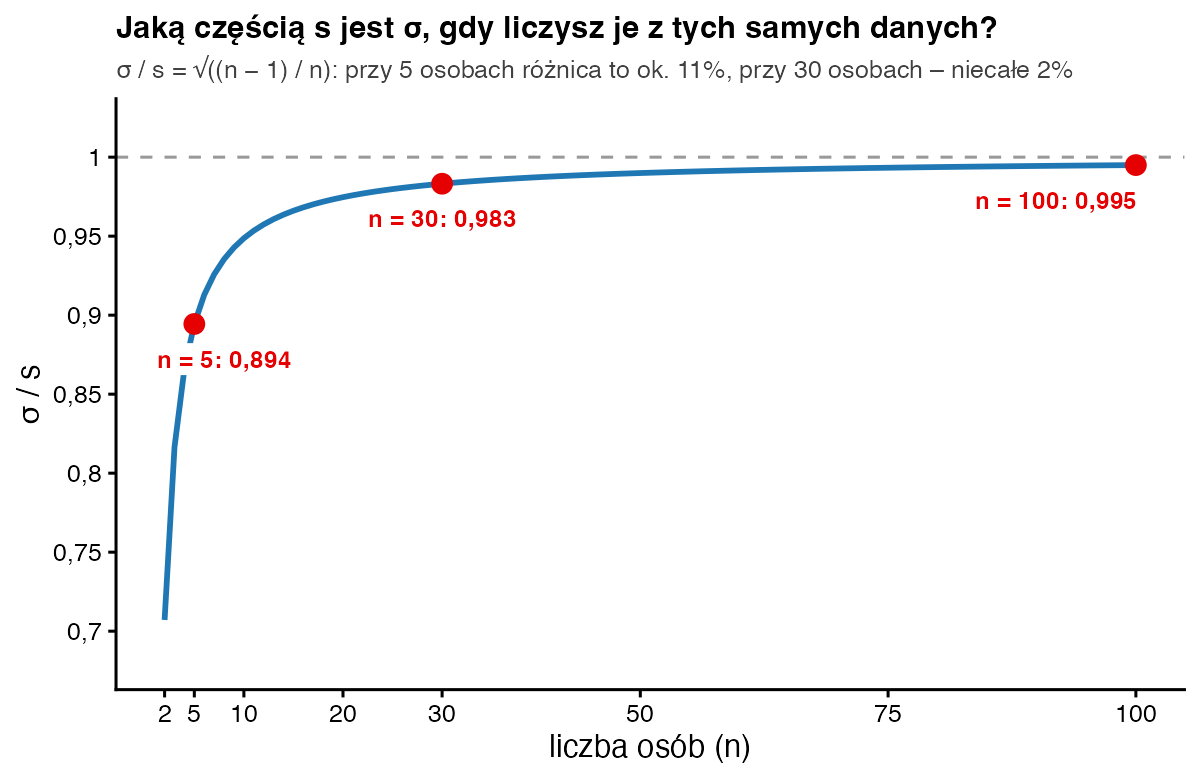
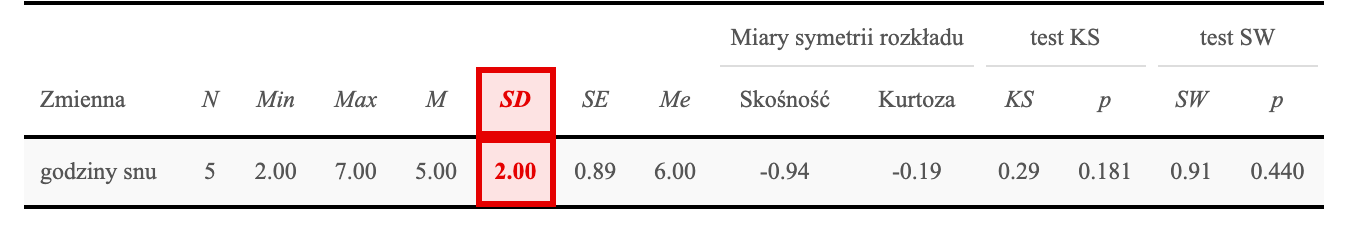
- Porównanie. Dla tych samych danych SD z próby wynosi s = 2. Stosunek 1,79 / 2 = 0,894, czyli √(4/5).
Jak zinterpretować i opisać wynik?
Godziny snu mieszkańców pokoju odbiegają od ich średniej typowo o 1,79 godziny. Ten wynik opisuje tylko te pięć osób i nie mówi nic o wszystkich studentach. Jeśli chcesz uogólniać, potraktuj dane jako próbę i podaj s = 2. Zwróć też uwagę na zapis: parametry populacji oznaczasz literami greckimi (μ, σ) i wielką literą N.
Zapis w stylu APA: Mieszkańcy pokoju (N = 5) spali w noc przed kolokwium średnio 5 godzin (μ = 5,00; σ = 1,79).
Jak policzyć σ w R?
sen <- c(6, 2, 7, 4, 6)              # wszyscy mieszkańcy pokoju = cała populacja
N <- length(sen)

# 1) „ręcznie”, według wzoru dla populacji (mianownik N)
mu <- mean(sen)
sum((sen - mu)^2) / N                # wariancja populacji σ² = 3.2
sqrt(sum((sen - mu)^2) / N)          # σ = 1.789

# 2) R ma tylko wersję z próby (mianownik n - 1) – można ją przeliczyć
sigma <- sd(sen) * sqrt((N - 1) / N)
c(s = sd(sen), sigma = sigma, stosunek = sigma / sd(sen))
Wynik w konsoli R:
[1] 3.2
[1] 1.788854
        s     sigma  stosunek
2.0000000 1.7888544 0.8944272
R nie ma osobnej funkcji dla σ: sd() zawsze dzieli przez n − 1. Wystarczy pomnożyć jej wynik przez √((N − 1) / N).
Próba czy populacja – skąd mam wiedzieć?
Zadaj sobie pytanie: czy chcę mówić o osobach, których nie zbadałem? Jeśli ankietowałeś 200 studentów swojej uczelni, a wnioski dotyczą wszystkich jej studentów, masz próbę – nawet dużą – i liczysz s. Jeśli opisujesz wyłącznie zbadaną grupę i nie wychodzisz poza nią, masz populację i możesz policzyć σ. W razie wątpliwości wybierz wersję z próby. To standard w programach statystycznych i w czasopismach, a przy kilkudziesięciu osobach różnica i tak jest niewielka (Rys. 2).
Najczęstsze błędy
- Używanie w Excelu funkcji STDEV.P (dla populacji) do danych z ankiety – to próba, więc potrzebne jest STDEV.S.
- Nazywanie „populacją” dużej próby, np. 300 ankietowanych studentów.
- Oznaczanie wyników z próby greckimi literami σ i μ zamiast SD i M.
- Przekonanie, że wersja z n − 1 jest „mniej dokładna”. Jest odwrotnie: to ona średnio nie zaniża wariancji (Rys. 1).
- Wybieranie wzoru według tego, który daje „ładniejszy” wynik. O wyborze decyduje to, czy uogólniasz wnioski, a nie wielkość SD.
Bibliografia
- Pearson, K. (1894). Contributions to the mathematical theory of evolution. Philosophical Transactions of the Royal Society of London. A, 185, 71–110.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówOdchylenie standardowe
- Słownik wzorówŚrednia arytmetyczna
- Słownik wzorówBłąd standardowy średniej
- PoradnikStatystyka opisowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.