

Jak opracować wyniki ankiety – krok po kroku (z przykładem w R)
Opracowanie wyników ankiety to droga od surowego pliku z Formularzy Google do wyników skal, tabel i testów, które trafią do rozdziału empirycznego. Typowe pytanie z pracy dyplomowej: masz już eksport odpowiedzi i hipotezy – od czego zacząć, żeby niczego nie zepsuć po drodze?
W prostych słowachNajpierw porządek, potem liczby. Usuwasz puste odpowiedzi, sprawdzasz braki i odwracasz pytania sformułowane „na odwrót”. Dopiero wtedy liczysz wyniki skal, ich rzetelność i statystyki opisowe. Testy hipotez są ostatnim krokiem, a nie pierwszym.
Przykład: mini-ankieta „Stres przed sesją”
Ta sama ankieta wraca we wszystkich naszych poradnikach o ankietach. Studenci psychologii i ekonomii odpowiedzieli na cztery pytania na skali od 1 (zdecydowanie się nie zgadzam) do 5 (zdecydowanie się zgadzam): S1 „Przed egzaminem czuję silne napięcie”, S2 „Martwię się, że nie zdam”, S3 „Przez stres trudno mi się skupić na nauce” i S4 „W czasie sesji jestem spokojny/spokojna”. S4 jest pytaniem odwróconym: wysoka odpowiedź oznacza mało stresu. Badani podali też płeć, kierunek, liczbę godzin snu na dobę w czasie sesji i to, co pomaga im w stresie (pytanie wielokrotnego wyboru). Formularz zebrał 9 odpowiedzi.
| Osoba | Płeć | Kierunek | S1 | S2 | S3 | S4 | 6 − S4 | Stres (średnia) | Sen (h) |
|---|---|---|---|---|---|---|---|---|---|
| 1 | K | Psychologia | 4 | 5 | 4 | 1 | 5 | 4,5 | 4 |
| 2 | M | Ekonomia | 2 | 1 | 2 | 5 | 1 | 1,5 | 8 |
| 3 | K | Psychologia | 5 | 3 | 3 | 3 | 3 | 3,5 | 5 |
| 4 | K | Ekonomia | 3 | 2 | 2 | 3 | 3 | 2,5 | 7 |
| 5 | M | Psychologia | 3 | 4 | 2 | 3 | 3 | 3,0 | 6 |
| 6 | K | Ekonomia | 5 | 4 | 3 | 2 | 4 | 4,0 | 6 |
| 7 | K | Psychologia | 2 | 3 | 2 | 5 | 1 | 2,0 | 7 |
| 8 | M | Ekonomia | 4 | 3 | 3 | 4 | 2 | 3,0 | 5 |
| Mediana | – | – | 3,5 | 3 | 2,5 | 3 | 3 | 3,0 | 6 |
Analiza danych ankietowych krok po kroku
- Eksport i import. W Formularzach Google otwórz arkusz odpowiedzi i pobierz go jako CSV (z MS Forms dostaniesz plik Excel). Skróć nagłówki do kodów S1–S4, a pełną treść pytań zapisz osobno. To Twoja książka kodów.
- Czyszczenie. Usuń odpowiedzi testowe, powtórzone i puste. Sprawdź, czy wszystkie wartości mieszczą się w skali 1–5. Zapisz, ile ankiet odrzucasz i dlaczego. U nas odpada 1 z 9: osoba podała tylko płeć i kierunek. Zostaje N = 8.
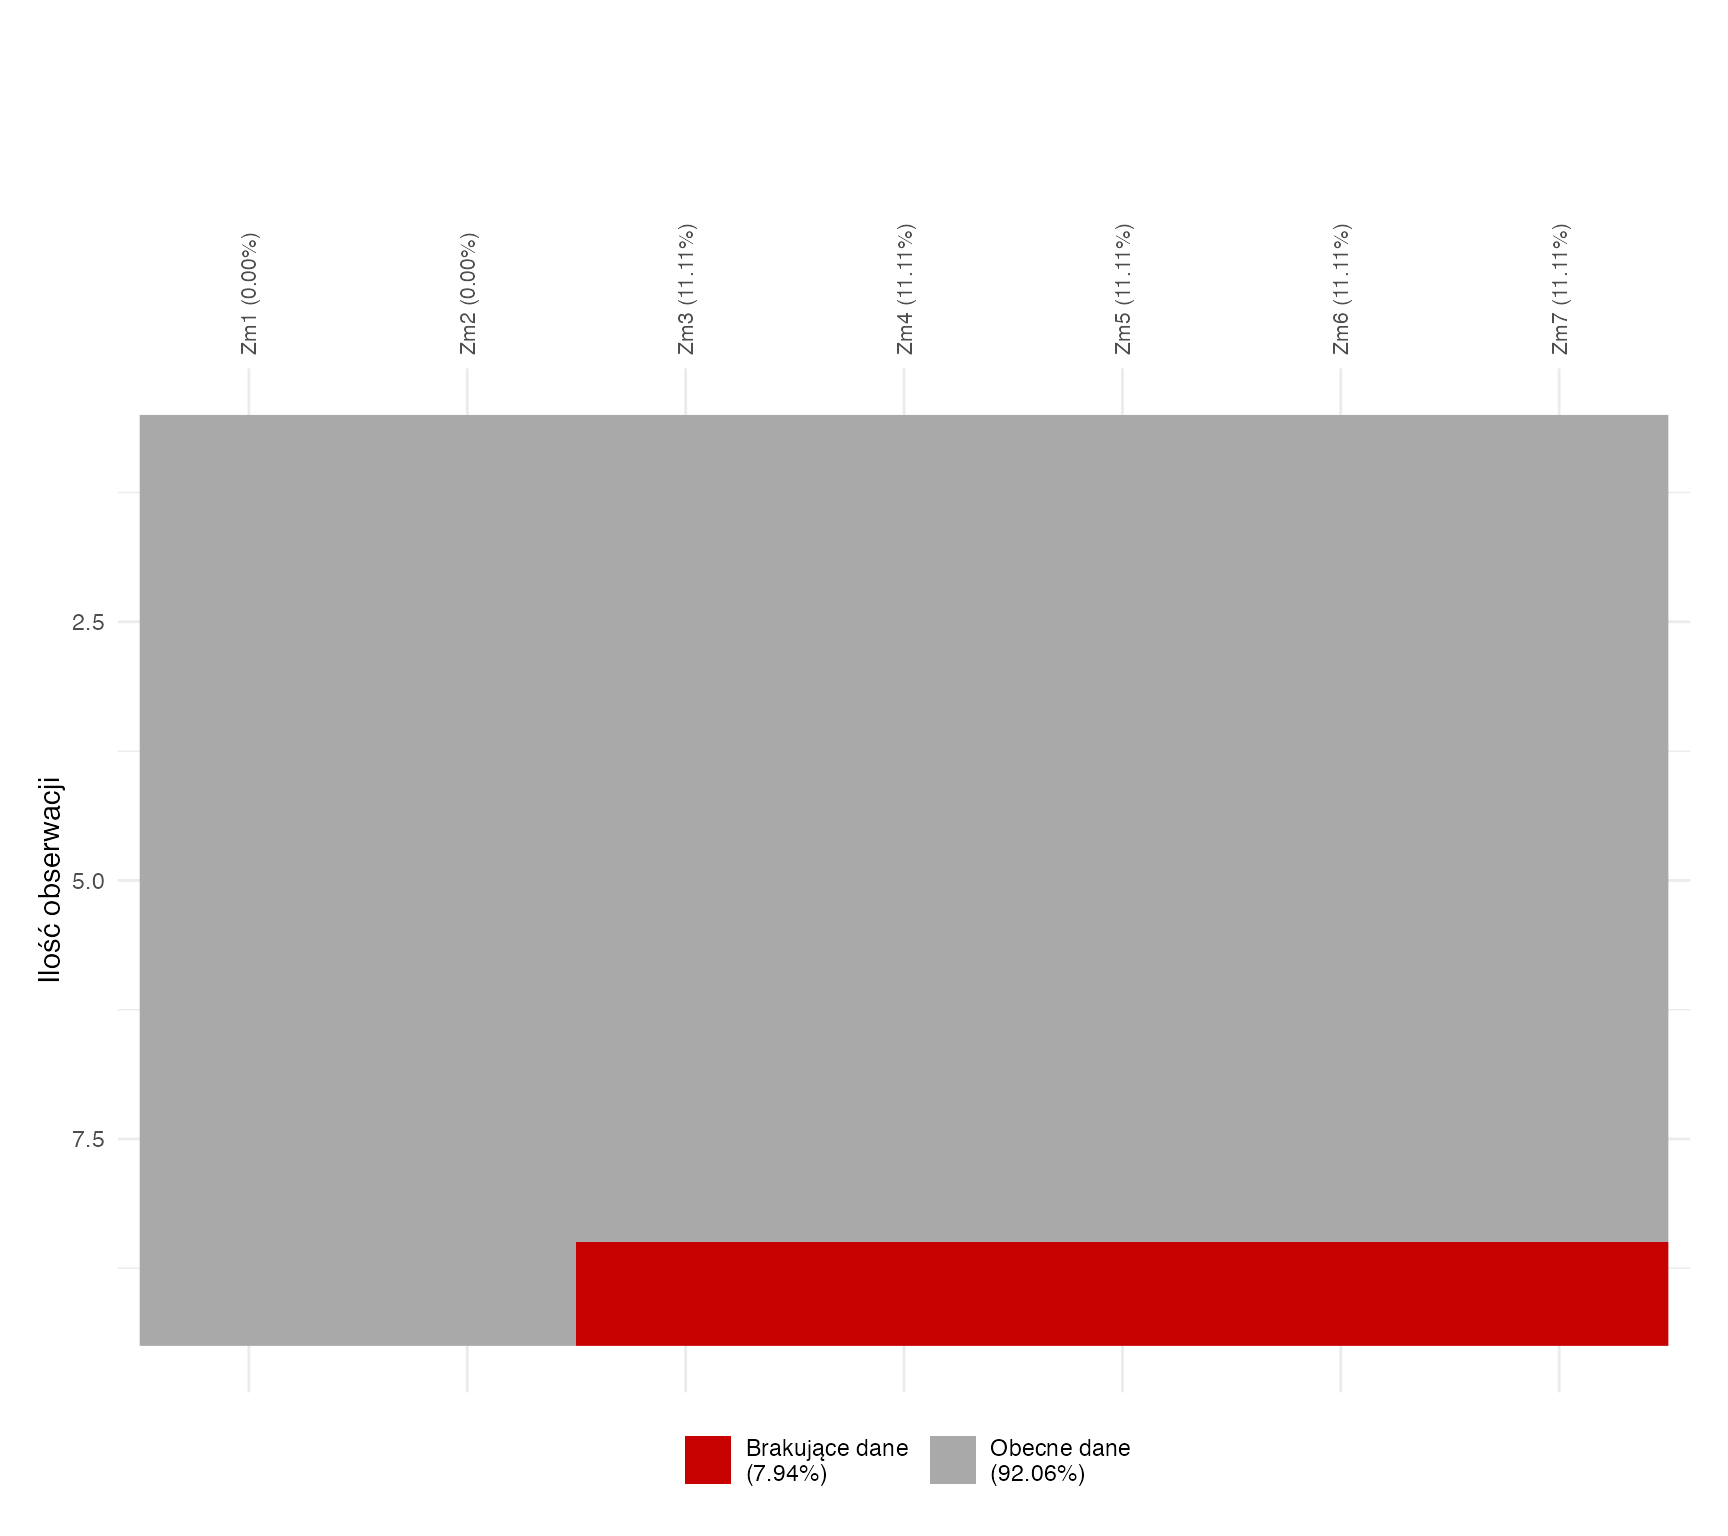
- Braki danych. Policz braki w każdej kolumnie i u każdej osoby (Rys. 1). Nie uzupełniaj ich odpowiedziami „na oko” ani średnią: średnia się nie zmieni, ale sztucznie zmaleje rozrzut wyników. Opisz liczbę braków i wybierz udokumentowaną metodę, np. analizę pełnych odpowiedzi albo – przy większej liczbie braków – imputację wielokrotną (Schafer i Graham, 2002).
- Rekodowanie. Odpowiedzi tekstowe zamień na liczby („zdecydowanie się zgadzam” = 5). Pytanie odwrócone przekoduj wzorem: nowa wartość = (min + max) − odpowiedź, czyli na skali 1–5: 6 − odpowiedź. Pytanie wielokrotnego wyboru rozbij na osobne kolumny „tak/nie” dla każdej opcji.
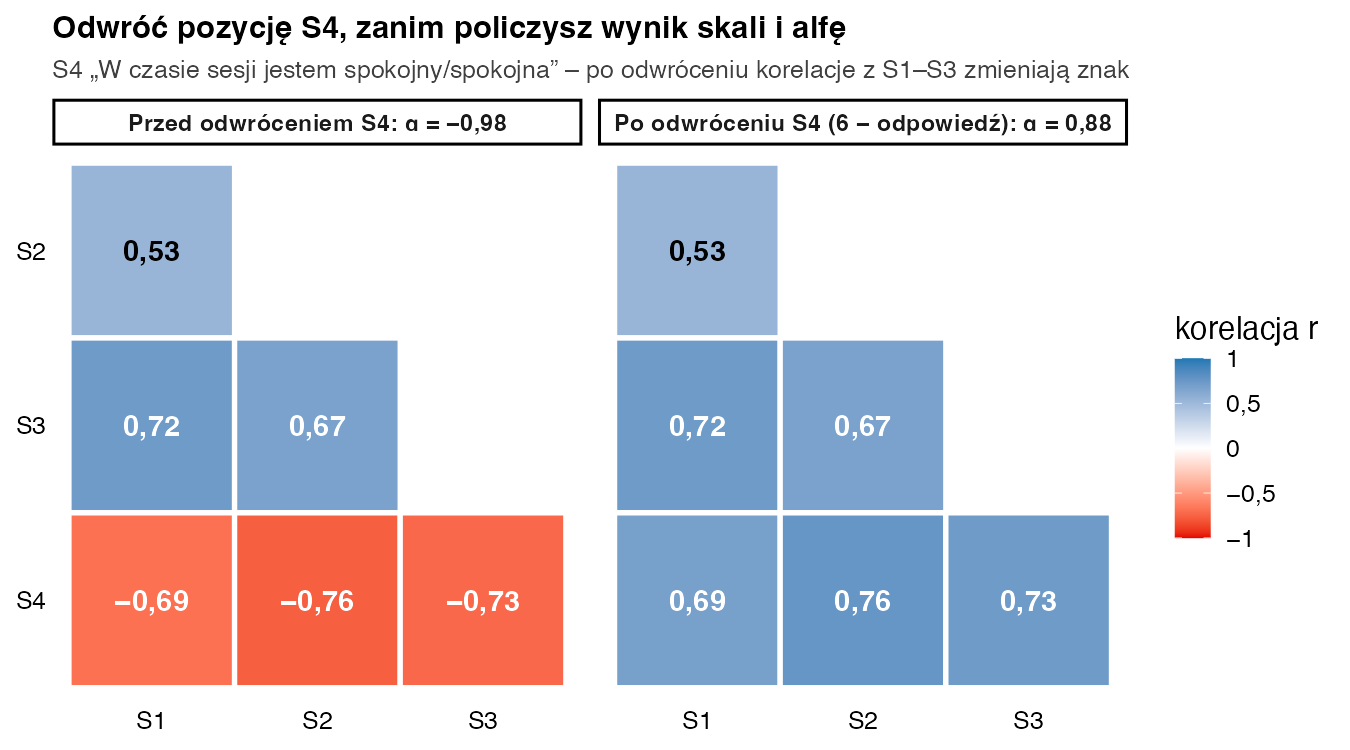
- Wyniki skal i rzetelność. Wynik skali to średnia (albo suma) jej pozycji. Rzetelność sprawdź alfą Cronbacha: u nas α = 0,88. Bez odwrócenia S4 wyszłoby α = −0,98 (Rys. 2).
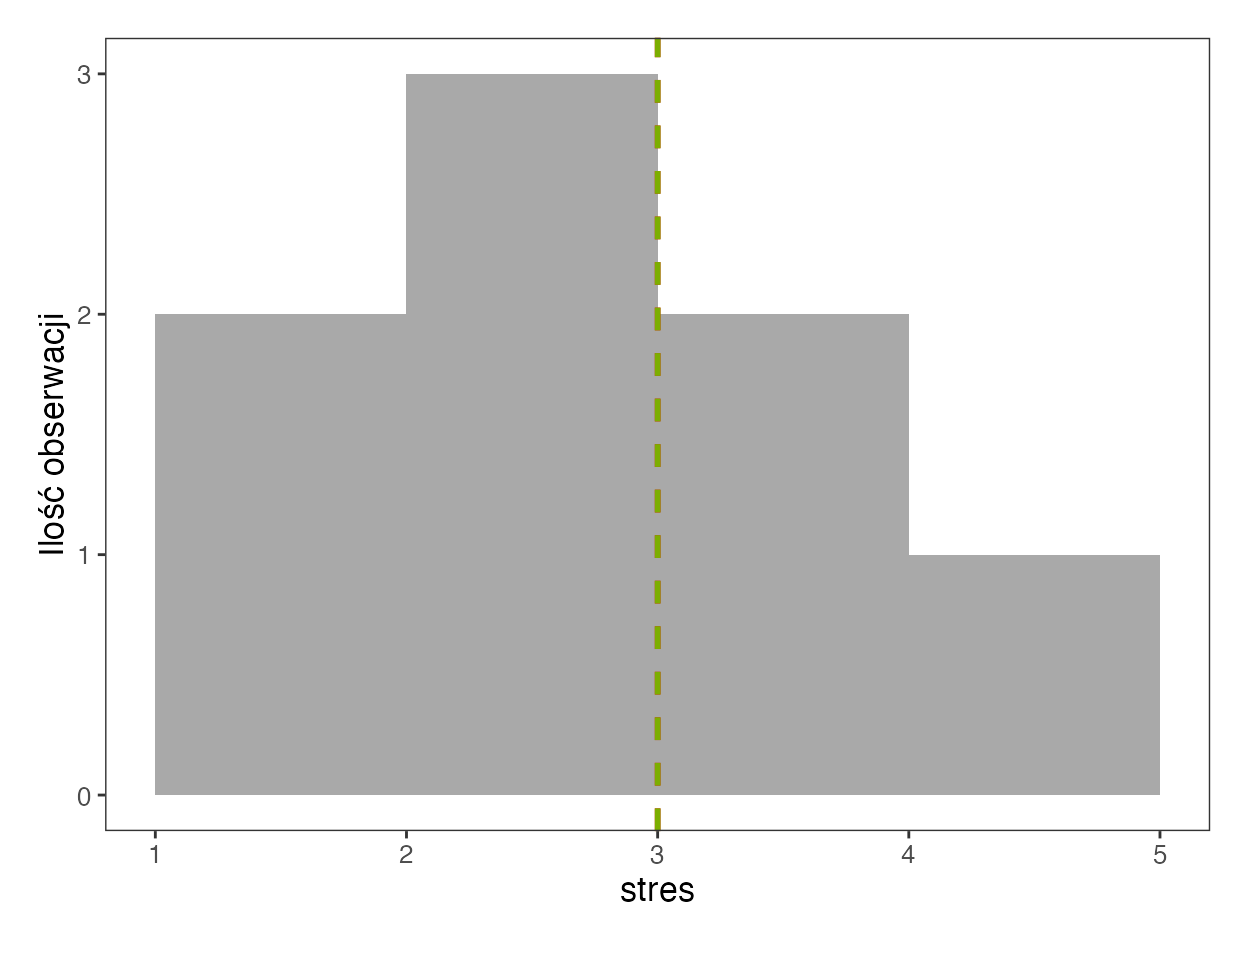
- Opis próby i zmiennych. Dla płci, kierunku i pojedynczych pytań podaj liczebności i procenty, dla wyników skal – średnią, odchylenie standardowe i medianę. Stres: M = 3,00; SD = 1,00. Sen: M = 6,00; SD = 1,31. Obejrzyj też histogram (Rys. 3).
- Testy hipotez. Licz tylko to, co zapisałeś w hipotezach. H1: dłuższy sen wiąże się z mniejszym stresem – r = −0,87; p = 0,005. H2: kierunki różnią się poziomem stresu – t(6) = 0,68; p = 0,522, więc brak podstaw do odrzucenia H0. Dobór testów omawiamy w poradniku o analizie statystycznej w pracy magisterskiej.
Jak opracować wyniki ankiety w R?
# 1) Import: plik CSV z Arkuszy Google (Plik → Pobierz → CSV); w praktyce read.csv("ankieta.csv")
ankieta <- read.csv(na.strings = "", check.names = FALSE, text = '
płeć,kierunek,S1,S2,S3,S4,sen,pomaga
Kobieta,Psychologia,4,5,4,1,4,"Sport, Rozmowa z bliskimi, Muzyka"
Mężczyzna,Ekonomia,2,1,2,5,8,"Sport, Spacer"
Kobieta,Psychologia,5,3,3,3,5,Muzyka
Kobieta,Ekonomia,3,2,2,3,7,Rozmowa z bliskimi
Mężczyzna,Psychologia,3,4,2,3,6,"Spacer, Muzyka"
Kobieta,Ekonomia,5,4,3,2,6,"Sport, Rozmowa z bliskimi"
Kobieta,Psychologia,2,3,2,5,7,"Rozmowa z bliskimi, Muzyka"
Mężczyzna,Ekonomia,4,3,3,4,5,"Sport, Spacer, Muzyka"
Kobieta,Psychologia,,,,,,')

# 2) Braki danych: najpierw policz, potem zdecyduj (tu: 1 osoba bez odpowiedzi na pytania)
colSums(is.na(ankieta))
ankieta <- ankieta[rowSums(is.na(ankieta[, 3:8])) < 6, ]   # odrzucamy pustą ankietę
nrow(ankieta)

# 3) Rekodowanie: pozycja odwrócona S4 (skala 1–5) i pytanie wielokrotnego wyboru
ankieta$S4r <- 6 - ankieta$S4
cbind(n = sort(table(unlist(strsplit(ankieta$pomaga, ", "))), decreasing = TRUE))

# 4) Wynik skali (średnia 4 pozycji) i rzetelność
pozycje <- ankieta[, c("S1", "S2", "S3", "S4r")]
ankieta$stres <- rowMeans(pozycje)
round(psych::alpha(pozycje)$total$raw_alpha, 2)

# 5) Opis próby i zmiennych
table(ankieta$płeć, ankieta$kierunek)
round(sapply(ankieta[, c("stres", "sen")], function(x) c(M = mean(x), SD = sd(x), Me = median(x))), 2)

# 6) Hipotezy: H1 – stres a sen (Pearson), H2 – stres a kierunek (t Studenta)
h1 <- cor.test(ankieta$stres, ankieta$sen)
h2 <- t.test(stres ~ kierunek, data = ankieta, var.equal = TRUE)
round(c(r = unname(h1$estimate), p_H1 = h1$p.value, t = unname(h2$statistic), p_H2 = h2$p.value), 3)
Wynik w konsoli R:
    płeć kierunek       S1       S2       S3       S4      sen   pomaga
       0        0        1        1        1        1        1        1
[1] 8
                   n
Muzyka             5
Rozmowa z bliskimi 4
Sport              4
Spacer             3
[1] 0.88

            Ekonomia Psychologia
  Kobieta          2           3
  Mężczyzna        2           1
   stres  sen
M      3 6.00
SD     1 1.31
Me     3 6.00
     r   p_H1      t   p_H2
-0.873  0.005 -0.679  0.522
Znak t zależy od kolejności grup. R ustawia je alfabetycznie i odejmuje średnią psychologii od średniej ekonomii, stąd t = −0,68.
Analiza wyników ankiety: Excel, SPSS czy R?
Częstości, alfę i test t policzysz w każdym z nich (w Excelu – formułami). Excel najlepiej sprawdza się jednak przy czyszczeniu danych i prostych tabelach. SPSS i jamovi mają menu, a skrypt R zapisuje każdy krok, więc po uwagach promotora powtórzysz całą analizę jednym poleceniem. Niezależnie od programu metody analizy wyników ankiety układają się w trzy poziomy: opis (częstości, średnie), związki (korelacje, tabele krzyżowe z testem chi-kwadrat) i modele (regresja). Ankieta zebrana w jednym momencie pokazuje związki, a nie przyczyny. Pisz więc „wiąże się z”, a nie „wpływa na”. Jak zamienić te liczby na tekst rozdziału, pokazujemy w poradniku jak opisać wyniki ankiety w pracy magisterskiej. Jeśli wolisz oddać ten etap statystykowi, zobacz, jak wygląda opracowanie wyników ankiety z naszą pomocą.
Najczęstsze błędy
- Liczenie wyniku skali i alfy bez odwrócenia pytań sformułowanych przeciwnie.
- Uzupełnianie braków wymyślonymi odpowiedziami albo średnią, bez słowa w pracy.
- Oczekiwanie, że procenty z pytania wielokrotnego wyboru zsumują się do 100%. Każda osoba mogła zaznaczyć kilka opcji: u nas 16 wskazań na 8 osób.
- Testowanie wszystkich par zmiennych „na wszelki wypadek”. Im więcej testów, tym większa szansa na przypadkowo istotny wynik.
- Średnia i odchylenie standardowe dla płci albo kierunku zamiast liczebności i procentów.
Bibliografia
- Cronbach, L. J. (1951). Coefficient alpha and the internal structure of tests. Psychometrika, 16(3), 297–334. https://doi.org/10.1007/BF02310555
- Schafer, J. L., & Graham, J. W. (2002). Missing data: Our view of the state of the art. Psychological Methods, 7(2), 147–177. https://doi.org/10.1037/1082-989X.7.2.147
- Dillman, D. A., Smyth, J. D., & Christian, L. M. (2014). Internet, phone, mail, and mixed-mode surveys: The tailored design method (4th ed.). Wiley.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikOpracowanie wyników ankiety
- PoradnikJak opisać wyniki ankiety w pracy magisterskiej
- PoradnikJak przygotować ankietę do pracy magisterskiej
- Słownik wzorówCzęstości i procenty
- Słownik wzorówAlfa Cronbacha
- Słownik wzorówTest chi-kwadrat
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.