

Analiza statystyczna – co to jest i jak ją przeprowadzić?
Analiza statystyczna to opisanie zebranych danych liczbami i wykresami oraz sprawdzenie, jakie wnioski o szerszej grupie ludzi można z nich wyciągnąć – i z jaką niepewnością. Typowe pytanie z pracy dyplomowej: od czego zacząć, gdy masz już plik z wynikami ankiety albo eksperymentu?
W prostych słowachNajpierw opisujesz to, co masz: ile osób, jakie średnie, jak duży rozrzut. Potem pytasz, czy to, co widać w Twojej próbie, mogło wyjść przypadkiem. Statystyka nie usuwa niepewności – mówi, jak duża ona jest.
Co to jest analiza statystyczna danych?
Statystyczna analiza danych obejmuje porządkowanie wyników, ich opis i wnioskowanie. Dotyczy nie tylko liczb: analizujesz też dane jakościowe, np. kierunek studiów albo odpowiedź „tak/nie”. Zbieranie danych to osobny etap badania – analiza zaczyna się, gdy plik jest gotowy. Same obliczenia to tylko część pracy. Równie ważne są dobór metody, sprawdzenie założeń i uczciwa interpretacja.
Statystyka opisowa a wnioskowanie statystyczne
| Statystyka opisowa | Wnioskowanie statystyczne | |
|---|---|---|
| Pytanie | Co widać w mojej próbie? | Co z tego wynika dla populacji? |
| Miary | średnia, mediana, odchylenie standardowe, procenty | wartość p, przedział ufności, wielkość efektu |
| Narzędzia | tabele, histogramy, wykresy pudełkowe | testy statystyczne, modele (np. regresja) |
| Przykład | „po warsztatach średnio o 3 punkty więcej” | „taka zmiana rzadko wynikałaby z przypadku, p = 0,040” |
Więcej o pierwszej części przeczytasz we wpisie statystyka opisowa, o drugiej – we wpisie test statystyczny.
Rodzaj zmiennej decyduje o metodzie
Zanim wybierzesz analizę, nazwij typ każdej zmiennej. Nominalna (kierunek studiów, płeć) – opisujesz ją procentami, a związki sprawdzasz testem chi-kwadrat. Porządkowa (pojedyncze pytanie 1–5, miejsce w rankingu) – medianą i testami rangowymi. Ilościowa (punkty, czas, suma pytań ze skali) – średnią i odchyleniem standardowym, a różnice testami parametrycznymi, o ile spełnione są ich założenia. Ta sama ankieta często zawiera wszystkie trzy typy.
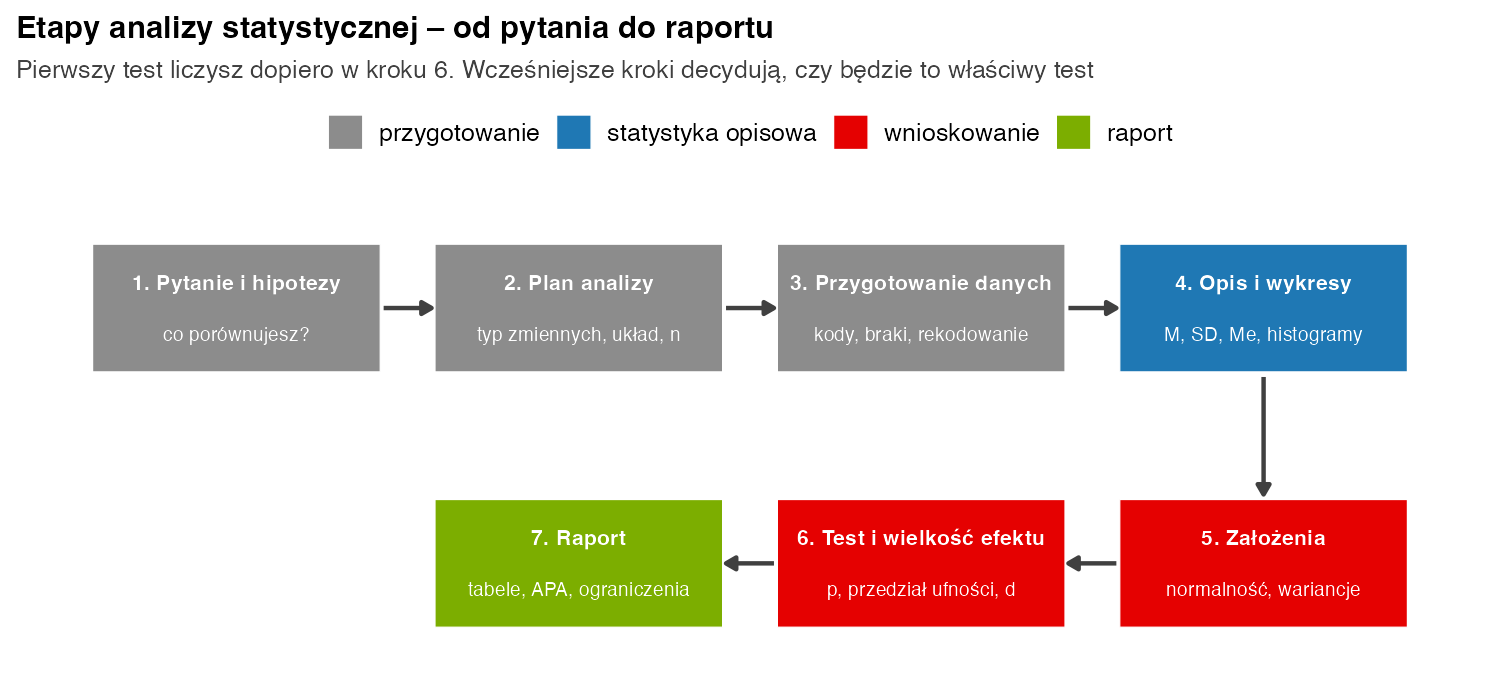
Etapy statystycznej analizy danych
- Pytanie badawcze i hipotezy. Co porównujesz albo jaki związek sprawdzasz (zobacz: jak postawić hipotezę)?
- Plan analizy. Typ zmiennych (ilościowe, porządkowe, nominalne), układ badania (różne osoby czy te same osoby kilka razy), liczba osób.
- Przygotowanie danych. Kodowanie odpowiedzi, braki danych, odwrócenie pytań, wyłapanie błędów wpisu.
- Opis i wykresy. Statystyki opisowe i wykresy – zanim policzysz pierwszy test (Tukey, 1977).
- Sprawdzenie założeń. Normalność rozkładu w grupach lub reszt modelu, równość wariancji, obserwacje odstające.
- Test i wielkość efektu. Wartość p, przedział ufności i miara siły efektu, np. d Cohena.
- Raport. Tabele, opis w stylu APA (American Psychological Association, 2020) i ograniczenia badania.
Mapa metod: jakie analizy statystyczne wybrać?
| Pytanie badawcze | Metoda | Przykład krok po kroku |
|---|---|---|
| Jak wygląda moja próba? | statystyki opisowe, częstości i procenty | statystyka opisowa – przykład |
| Czy dwie grupy się różnią? | test t albo test U Manna-Whitneya | test t, test U |
| Czy różnią się trzy grupy lub więcej? | ANOVA albo test Kruskala-Wallisa | ANOVA – przykład |
| Czy wynik zmienił się po interwencji? | test t dla prób zależnych albo test Wilcoxona | przykład poniżej |
| Czy dwie zmienne ilościowe są powiązane? | korelacja Pearsona albo Spearmana | Pearson, Spearman |
| Czy dwie cechy jakościowe są powiązane? | test chi-kwadrat | chi-kwadrat – przykład |
| Co przewiduje wynik? | regresja liniowa lub logistyczna | regresja – przykład |
| Czy skala z ankiety jest rzetelna? | alfa Cronbacha, omega McDonalda | alfa Cronbacha – przykład |
Szczegółowe tabele wyboru testu, z warunkami jego użycia, znajdziesz we wpisach o testach parametrycznych i testach nieparametrycznych.
Przykład: analiza statystyczna danych w R
Pięcioro studentów napisało test przed warsztatami z R i po nich (punkty 0–10). Przed: 5, 3, 6, 4, 2. Po: 7, 3, 9, 10, 6.
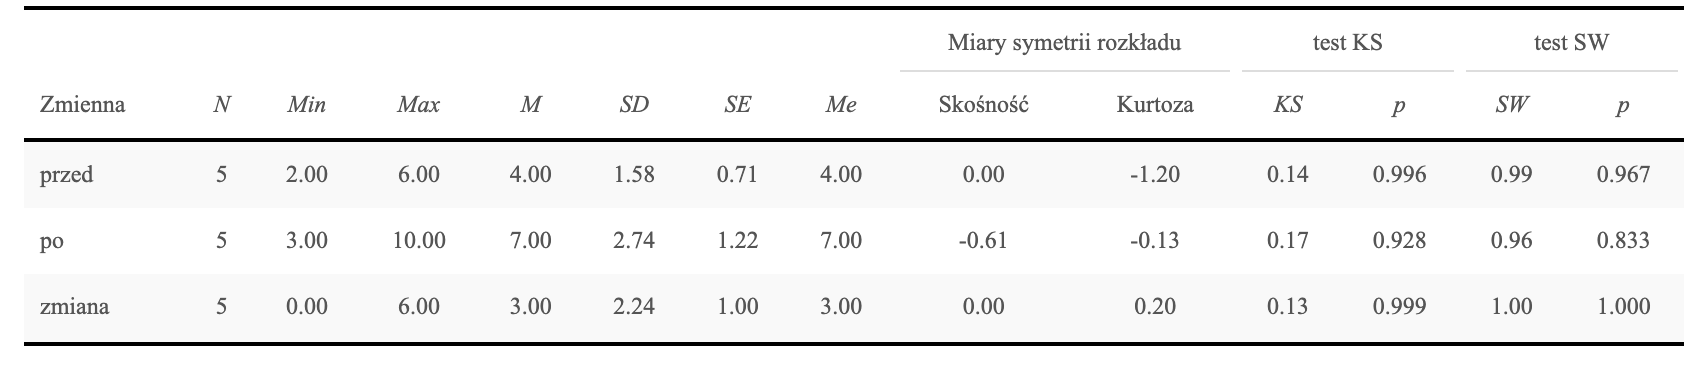
- Opis. Przed warsztatami M = 4,00 (SD = 1,58), po nich M = 7,00 (SD = 2,74). Średnia zmiana to 3 punkty (SD = 2,24).
- Założenia. Te same osoby zbadano dwa razy, więc potrzebny jest test dla prób zależnych. Normalność sprawdzasz na różnicach: test Shapiro-Wilka daje p > 0,99.
- Test i efekt. t(4) = 3,00; p = 0,040; dz = 1,34.
# punkty z testu (0–10) przed warsztatami z R i po nich – te same 5 osób
przed  <- c(5, 3, 6, 4, 2)
po     <- c(7, 3, 9, 10, 6)
zmiana <- po - przed

# 1) statystyka opisowa: co widać w próbie?
round(sapply(list(przed = przed, po = po, zmiana = zmiana),
             function(x) c(M = mean(x), SD = sd(x), Me = median(x))), 2)

# 2) założenie testu t dla par: normalność RÓŻNIC (nie surowych wyników)
shapiro.test(zmiana)$p.value

# 3) wnioskowanie: test t dla prób zależnych i wielkość efektu d_z
t.test(po, przed, paired = TRUE)
mean(zmiana) / sd(zmiana)

# 4) typowy błąd: te same dane potraktowane jak dwie niezależne grupy
t.test(po, przed, var.equal = TRUE)$p.value
Wynik w konsoli R:
   przed   po zmiana
M   4.00 7.00   3.00
SD  1.58 2.74   2.24
Me  4.00 7.00   3.00
[1] 0.9998029

	Paired t-test

data:  po and przed
t = 3, df = 4, p-value = 0.03994
alternative hypothesis: true mean difference is not equal to 0
95 percent confidence interval:
 0.2235549 5.7764451
sample estimates:
mean difference
              3

[1] 1.341641
[1] 0.066688
Zapis w stylu APA: Po warsztatach studenci uzyskiwali istotnie więcej punktów (M = 7,00; SD = 2,74) niż przed nimi (M = 4,00; SD = 1,58), t(4) = 3,00; p = 0,040; dz = 1,34; 95% CI dla różnicy [0,22; 5,78].
Wynik nie dowodzi, że to warsztaty podniosły wyniki – nie było grupy kontrolnej. Ostatnia linia kodu pokazuje też typowy błąd: te same dane potraktowane jak dwie niezależne grupy dają p = 0,067. Wynik wychodzi nieistotny, bo taki test pomija to, że oba pomiary pochodzą od tych samych osób.
Obliczenia statystyczne a statystyka w analizie danych – czym się różnią?
Program (R, SPSS, jamovi, SZTOS) wykona każde obliczenie, o które go poprosisz – także niewłaściwy test. Statystyka w analizie danych to przede wszystkim decyzje: jaka metoda pasuje do pytania i układu badania, czy założenia są spełnione i jak uczciwie opisać wynik. Dlatego obliczenia statystyczne zaplanuj przed zebraniem danych, a nie po nim.
Najczęstsze błędy
- Traktowanie p jako prawdopodobieństwa, że H0 jest prawdziwa. p mówi, jak często wynik co najmniej tak skrajny pojawiałby się, gdyby H0 była prawdziwa (Wasserstein i Lazar, 2016).
- „Brak istotności, więc brak różnicy”. Poprawnie: brak podstaw do odrzucenia H0.
- „Potwierdziliśmy hipotezę”. Wynik może ją wspierać, ale jej nie dowodzi.
- Wnioski o przyczynie z korelacji albo z badania bez grupy kontrolnej.
- Test dla grup niezależnych użyty dla tych samych osób zbadanych dwa razy.
- Dziesiątki testów bez korekty na wielokrotne porównania.
Bibliografia
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikStatystyka dla początkujących
- PoradnikMetody statystyczne – przegląd
- PoradnikBadanie statystyczne – podstawowe pojęcia
- PoradnikStatystyka opisowa – podstawy
- PoradnikTest statystyczny – na czym polega
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.