

Metody statystyczne – mapa najważniejszych analiz
Metody statystyczne to narzędzia do opisu danych i do wnioskowania o populacji na podstawie próby: od średnich i procentów, przez testy różnic i korelacje, po regresję i analizy wielu zmiennych naraz. Typowe pytanie z pracy dyplomowej: jaką metodę statystyczną wybrać do mojej hipotezy?
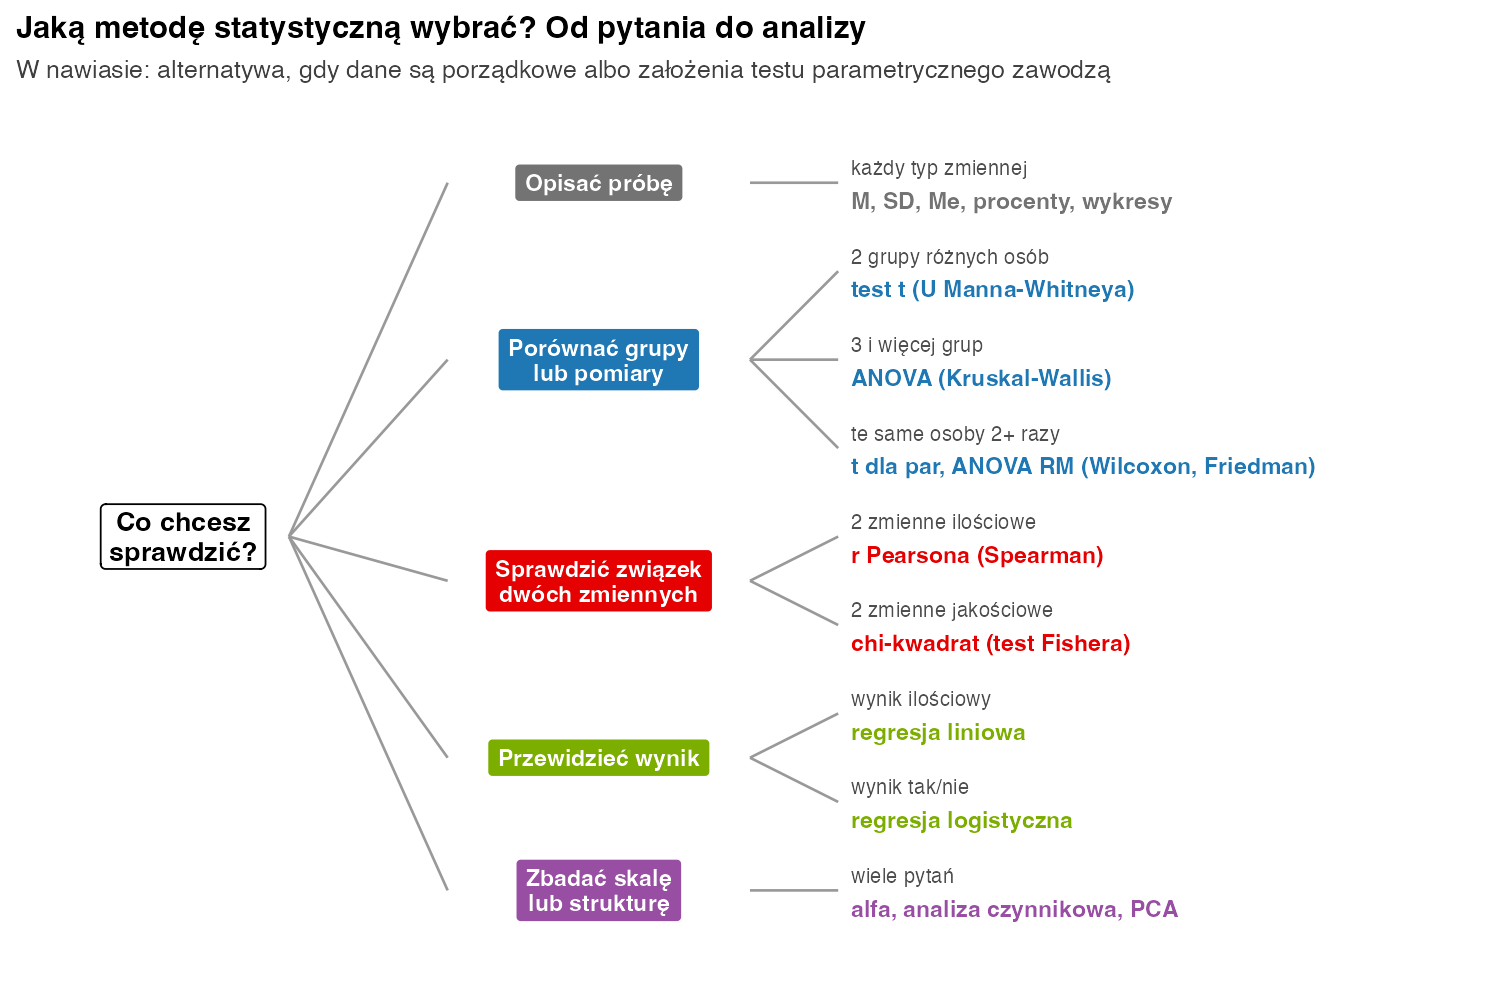
W prostych słowachMetodę wybierasz na podstawie pytania badawczego, a nie ulubionego testu. Zwykle wystarczą trzy pytania: jakiego typu są zmienne, czy porównujesz różne osoby, czy te same osoby kilka razy, i ile masz grup. Tabela poniżej prowadzi od pytania do metody i do przykładu krok po kroku.
Rodzaje metod statystycznych
- Opis danych – średnie, mediany, odchylenia, procenty i wykresy (statystyka opisowa).
- Porównania – czy grupy lub pomiary się różnią: testy t, analiza wariancji i ich odpowiedniki rangowe (testy parametryczne, testy nieparametryczne).
- Związki – czy dwie zmienne idą w parze: korelacje i test chi-kwadrat.
- Regresja – jak jedna lub kilka zmiennych przewiduje wynik. Tu mieszczą się też moderacja i mediacja.
- Analizy wielowymiarowe – struktura wielu pytań naraz: rzetelność skali, analiza czynnikowa, analiza głównych składowych (PCA), modele strukturalne (Tabachnick i Fidell, 2019).
Trzy pytania przed wyborem metody
- Jaki typ ma zmienna zależna? Ilościowa (punkty, czas), porządkowa (ocena 1–5) czy nominalna (tak/nie, kierunek). Od tego zależy, czy liczysz średnie, rangi, czy procenty.
- Czy porównujesz różne osoby, czy te same osoby kilka razy? Pomiar przed i po u tych samych studentów wymaga testu dla prób zależnych.
- Ile masz grup lub zmiennych? Dwie grupy – test t lub U, trzy i więcej – ANOVA lub test Kruskala-Wallisa, kilka predyktorów – regresja.
Dopiero potem sprawdzasz założenia: normalność rozkładu w grupach lub reszt modelu, podobne wariancje, brak skrajnych obserwacji. Gdy zawodzą, sięgasz po metodę z nawiasu w tabeli albo po wersję odporną, np. test Welcha.
Jaką metodę statystyczną wybrać? Tabela doboru
Wyniki w tabeli policzono na tych samych mini-danych, które liczymy ręcznie w słowniku wzorów. W nawiasie podajemy alternatywę na dane porządkowe albo na wypadek niespełnionych założeń.
| Pytanie badawcze | Zmienne | Metoda (alternatywa) | Wynik na mini-danych | Przykład krok po kroku |
|---|---|---|---|---|
| Jak wygląda moja próba? | każdy typ | statystyki opisowe, częstości | sen: M = 5,00; SD = 2,00 | statystyka opisowa |
| Czy dwie grupy się różnią? | ilościowa + 2 grupy różnych osób | test t (U Manna-Whitneya) | t(8) = 3,00; p = 0,017 | test t, test U |
| Czy różnią się trzy grupy lub więcej? | ilościowa + 3 grupy | ANOVA (Kruskal-Wallis) | F(2, 6) = 7,00; p = 0,027 (H = 5,60; p = 0,061) | ANOVA |
| Czy wynik zmienił się u tych samych osób? | ilościowa, 2 lub więcej pomiarów | t dla prób zależnych, ANOVA z powtarzanymi pomiarami (Wilcoxon, Friedman) | przed i po: t(4) = 3,00; p = 0,040 | test Friedmana |
| Czy dwie zmienne ilościowe są powiązane? | 2 ilościowe | korelacja Pearsona (Spearmana) | r = 0,80; p = 0,104 | Pearson, Spearman |
| Czy dwie cechy jakościowe są powiązane? | 2 nominalne | chi-kwadrat (dokładny test Fishera) | χ²(1) = 10,00; p = 0,002; φ = 0,50 | chi-kwadrat |
| Co przewiduje wynik? | wynik ilościowy albo tak/nie | regresja liniowa (logistyczna) | punkty = 1,2 + 1,6 × godziny; R² = 0,64 | regresja |
| Czy efekt zależy od trzeciej zmiennej albo działa przez pośrednika? | 3 zmienne | moderacja (interakcja), mediacja | – | mediacja |
| Czy pytania tworzą rzetelną skalę? | pozycje jednej skali | alfa Cronbacha, omega McDonalda | – | alfa Cronbacha |
| Jaka struktura kryje się za wieloma pytaniami? | wiele zmiennych | analiza czynnikowa, PCA, modele PLS-SEM | – | czynnikowa, PCA, PLS-SEM |
Test t, ANOVA i regresja – ta sama matematyka
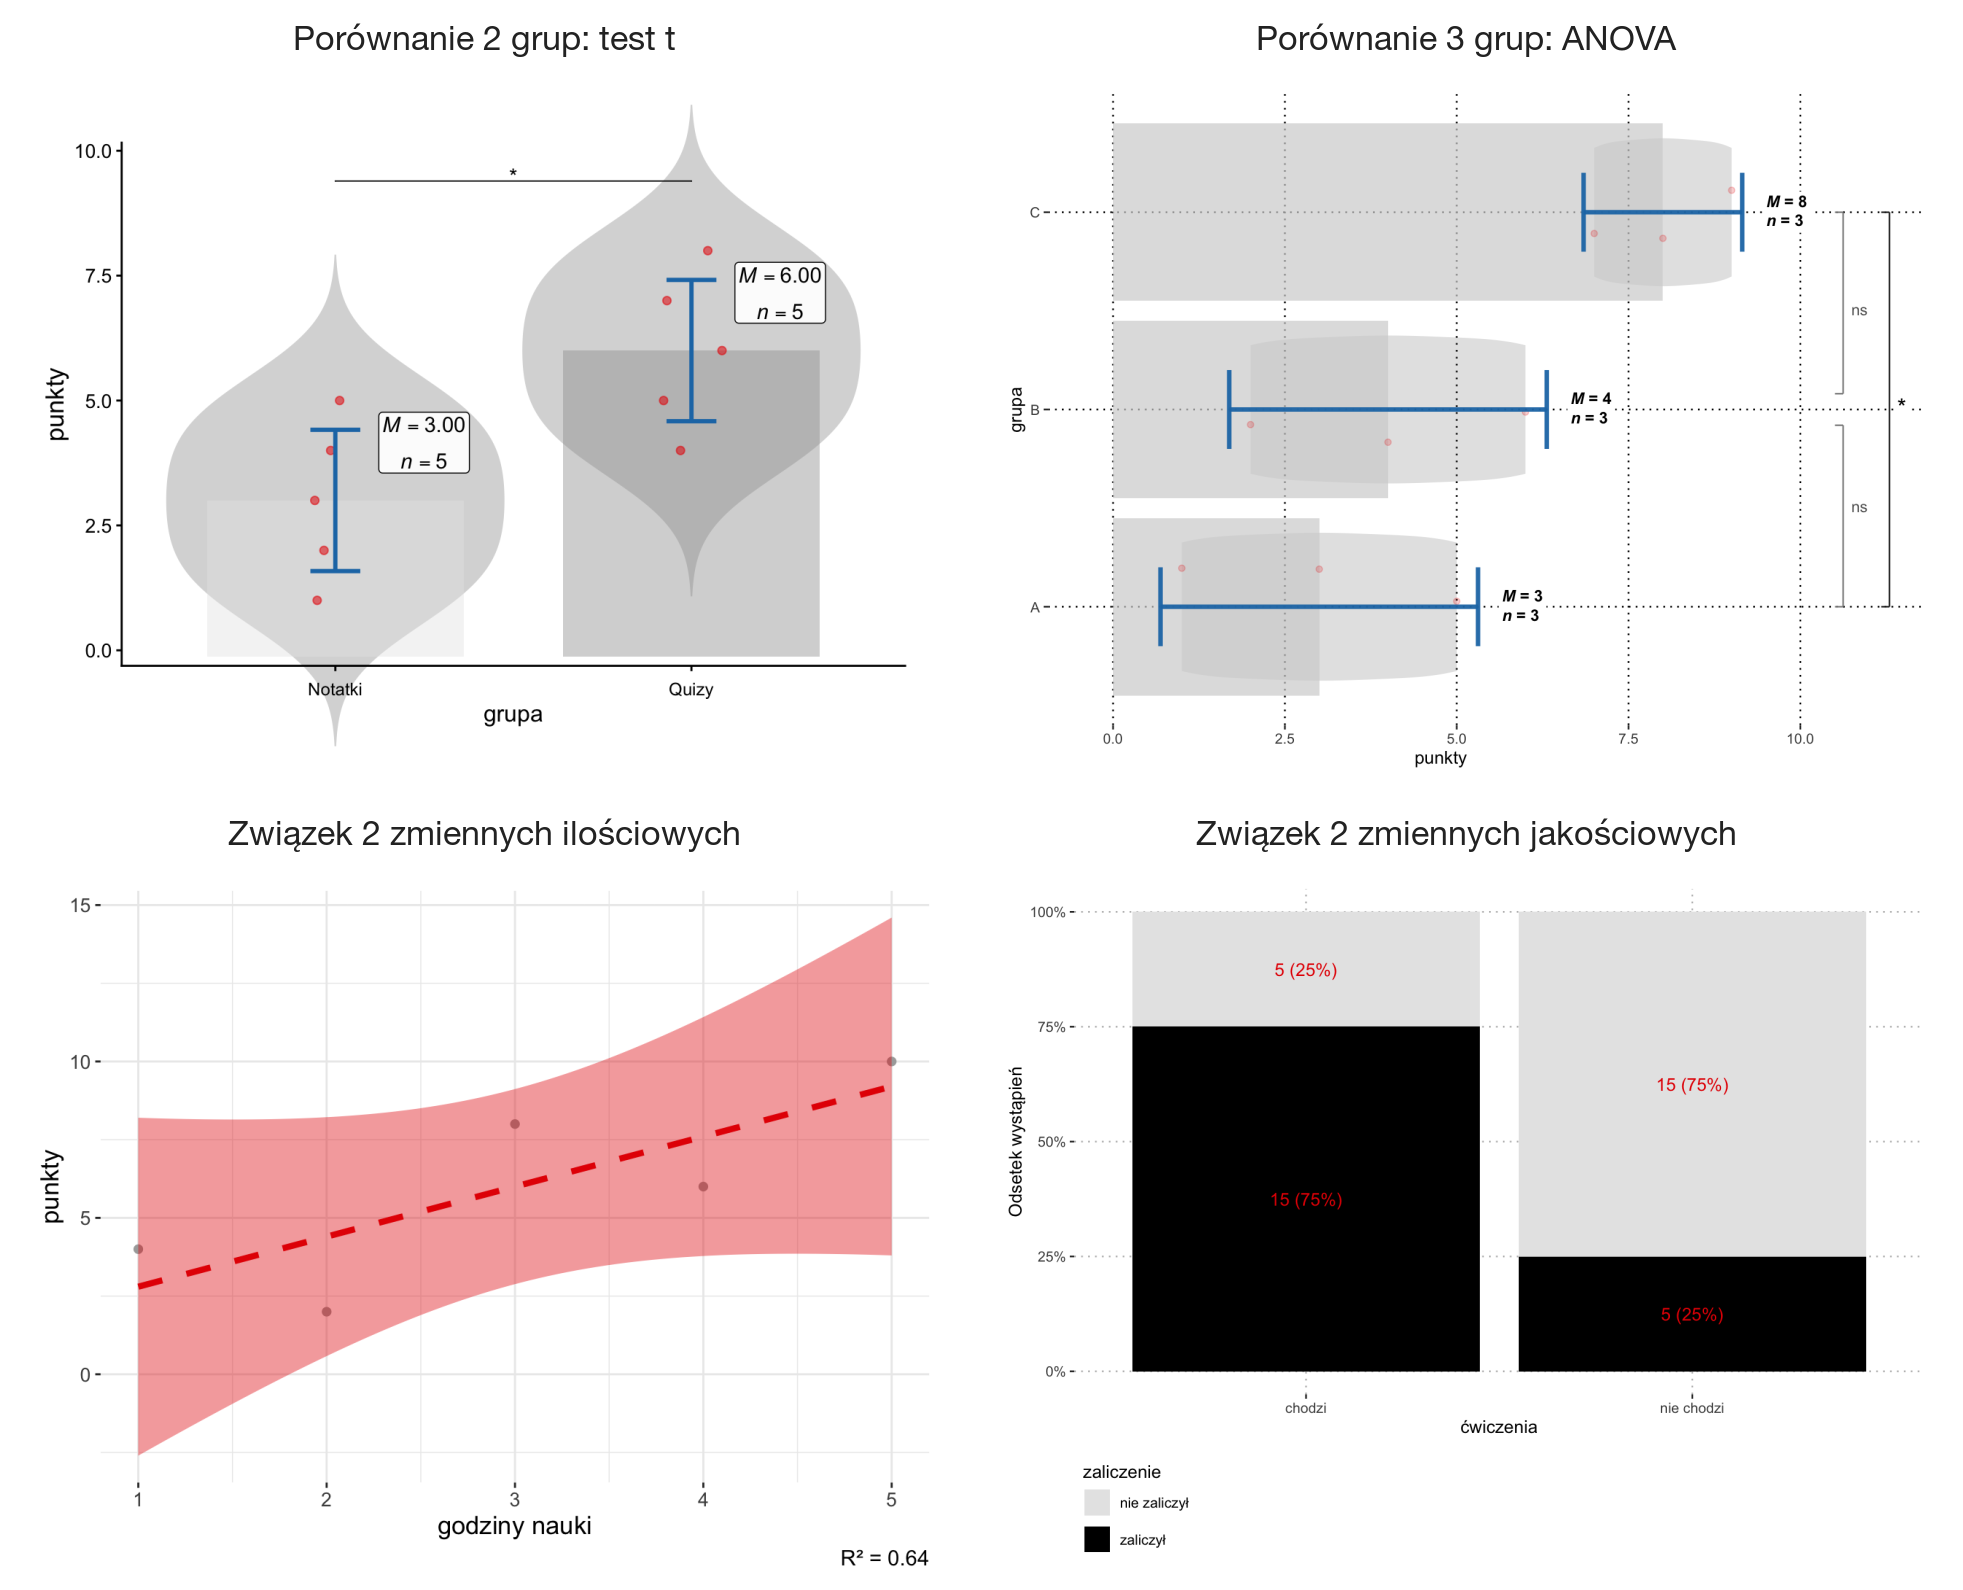
Wiele metod to szczególne przypadki jednego modelu liniowego (Cohen, 1968). Weź punkty studentów uczących się z notatek (1–5) i z quizów (4–8). Test t daje t(8) = 3,00; p = 0,017. ANOVA dla tych dwóch grup daje F(1, 8) = 9,00, czyli dokładnie 3,00², i to samo p. Regresja z grupą jako predyktorem daje współczynnik b = 3, równy różnicy średnich, i znów p = 0,017. Nawet korelacja grupy z wynikiem, r = 0,73, to ten sam rezultat zapisany inaczej. Nie szukasz więc „lepszej” z tych metod. Wybierasz tę, która najprościej odpowiada na Twoje pytanie i pozwala dodać kolejne zmienne.
Jak policzyć najważniejsze metody w R?
# Jedna analiza z każdej rodziny metod – na mini-zbiorach ze słownika wzorów
sen     <- c(6, 2, 7, 4, 6)                                 # opis jednej zmiennej
notatki <- c(1, 2, 3, 4, 5); quizy <- c(4, 5, 6, 7, 8)      # dwie grupy
punkty  <- c(1, 3, 5, 2, 4, 6, 7, 8, 9)                     # trzy grupy
grupa   <- factor(rep(c("A", "B", "C"), each = 3))
godziny <- 1:5; wynik <- c(4, 2, 8, 6, 10)                  # związek i regresja
tabela  <- matrix(c(15, 5, 5, 15), nrow = 2)                # dwie cechy jakościowe

round(c(M = mean(sen), SD = sd(sen),
        p_t = t.test(quizy, notatki, var.equal = TRUE)$p.value,
        F = summary(aov(punkty ~ grupa))[[1]]$"F value"[1],
        p_KW = kruskal.test(punkty ~ grupa)$p.value,
        r = cor(godziny, wynik),
        chi2 = unname(chisq.test(tabela, correct = FALSE)$statistic)), 3)
coef(lm(wynik ~ godziny))                                   # regresja: 1,2 + 1,6 * godziny

# Ta sama matematyka: test t, ANOVA i regresja dla dwóch grup
y <- c(notatki, quizy); g <- factor(rep(c("Notatki", "Quizy"), each = 5))
anova(lm(y ~ g))                                            # F = 9 = t^2
summary(lm(y ~ g))$coefficients                             # b = 3 (różnica średnich), t = 3
Wynik w konsoli R:
     M     SD    p_t      F   p_KW      r   chi2
 5.000  2.000  0.017  7.000  0.061  0.800 10.000
(Intercept)     godziny
        1.2         1.6
Analysis of Variance Table

Response: y
          Df Sum Sq Mean Sq F value  Pr(>F)
g          1   22.5    22.5       9 0.01707 *
Residuals  8   20.0     2.5
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
            Estimate Std. Error  t value    Pr(>|t|)
(Intercept)        3  0.7071068 4.242641 0.002827299
gQuizy             3  1.0000000 3.000000 0.017071681
Metody statystyczne w pracy magisterskiej – ile ich potrzeba?
Zwykle jedna metoda na hipotezę plus opis próby i rzetelność skal. Promotor oceni trafność doboru, a nie liczbę analiz. Dziesięć testów bez korekty na wielokrotne porównania to raczej problem niż zaleta. Plan analiz dla całej pracy opisujemy we wpisie analiza statystyczna w pracy magisterskiej.
Czy można zawsze używać metod nieparametrycznych „na wszelki wypadek”?
Można, ale płacisz za to – zwykle niewielką – utratą mocy. Przy danych zbliżonych do normalnych test rangowy nieco rzadziej wykrywa prawdziwą różnicę i nie daje różnicy średnich z przedziałem ufności. Wybieraj go, gdy zmienna jest porządkowa albo rozkład w małej grupie jest wyraźnie skośny i ma wyniki odstające.
Najczęstsze błędy
- Wybór metody po obejrzeniu wyników, według tego, która daje mniejsze p.
- Test dla grup niezależnych użyty dla tych samych osób zbadanych dwa razy.
- Opisywanie korelacji jako wpływu albo przyczyny.
- Średnie i test t dla zmiennej nominalnej, np. kodów kierunku studiów.
- Wiele testów bez korekty, np. poprawki Bonferroniego.
Bibliografia
- Cohen, J. (1968). Multiple regression as a general data-analytic system. Psychological Bulletin, 70(6), 426–443. https://doi.org/10.1037/h0026714
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikTesty parametryczne
- PoradnikTesty nieparametryczne
- PoradnikKorelacja Pearsona – przykład
- PoradnikRegresja liniowa – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.