

Test t Welcha – wzór, stopnie swobody i przykład
Test t Welcha porównuje średnie w dwóch niezależnych grupach bez założenia, że rozrzut wyników w obu grupach jest taki sam. Typowe pytanie z pracy dyplomowej: czy studenci piszący kolokwium online mają inne wyniki niż ci, którzy pisali na sali – skoro online wyniki są dużo bardziej rozrzucone?
W prostych słowachTest Welcha to test t z „poprawką na nierówny rozrzut”. Każda grupa wnosi do mianownika tyle niepewności, ile sama ma, zamiast jednej wspólnej wariancji. Do tego test uczciwie obniża stopnie swobody, gdy niepewność pochodzi głównie z jednej małej, rozrzuconej grupy. Gdy grupy są podobne, daje prawie to samo co klasyczny test t.
Kiedy stosować test t Welcha?
- porównujesz dwie grupy różnych osób pod względem zmiennej ilościowej;
- wariancje w grupach mogą się różnić – zwłaszcza gdy grupy mają też różną liczebność;
- wyniki w każdej grupie mają rozkład zbliżony do normalnego (przy kilkudziesięciu osobach w grupie test jest na to dość odporny);
- w praktyce: zawsze, gdy nie masz mocnych powodów zakładać równych wariancji – to dziś zalecany wybór domyślny (Delacre i in., 2017).
Klasyczną wersję ze wspólną wariancją opisuje hasło o teście t Studenta dla prób niezależnych. Różnice wariancji opiszesz testem Levene’a. Przy trzech i więcej grupach odpowiednikiem jest ANOVA Welcha (w R: oneway.test()), alternatywa dla klasycznej jednoczynnikowej ANOVA. Przy wynikach porządkowych lub bardzo skośnych wybierz test U Manna-Whitneya.
Wzór na test t Welcha
- \(\bar{x}_1,\ \bar{x}_2\)
- średnie w grupie 1 i w grupie 2
- \(s_1^2,\ s_2^2\)
- wariancje w grupach, liczone osobno – bez łączenia w jedną wspólną
- \(s^2/n\)
- „niepewność” średniej danej grupy (kwadrat jej błędu standardowego)
- \(n_1,\ n_2\)
- liczba osób w każdej grupie
- \(df\)
- stopnie swobody Welcha-Satterthwaite’a; zwykle nie są liczbą całkowitą i są mniejsze niż \(n_1 + n_2 - 2\)
Przykład krok po kroku
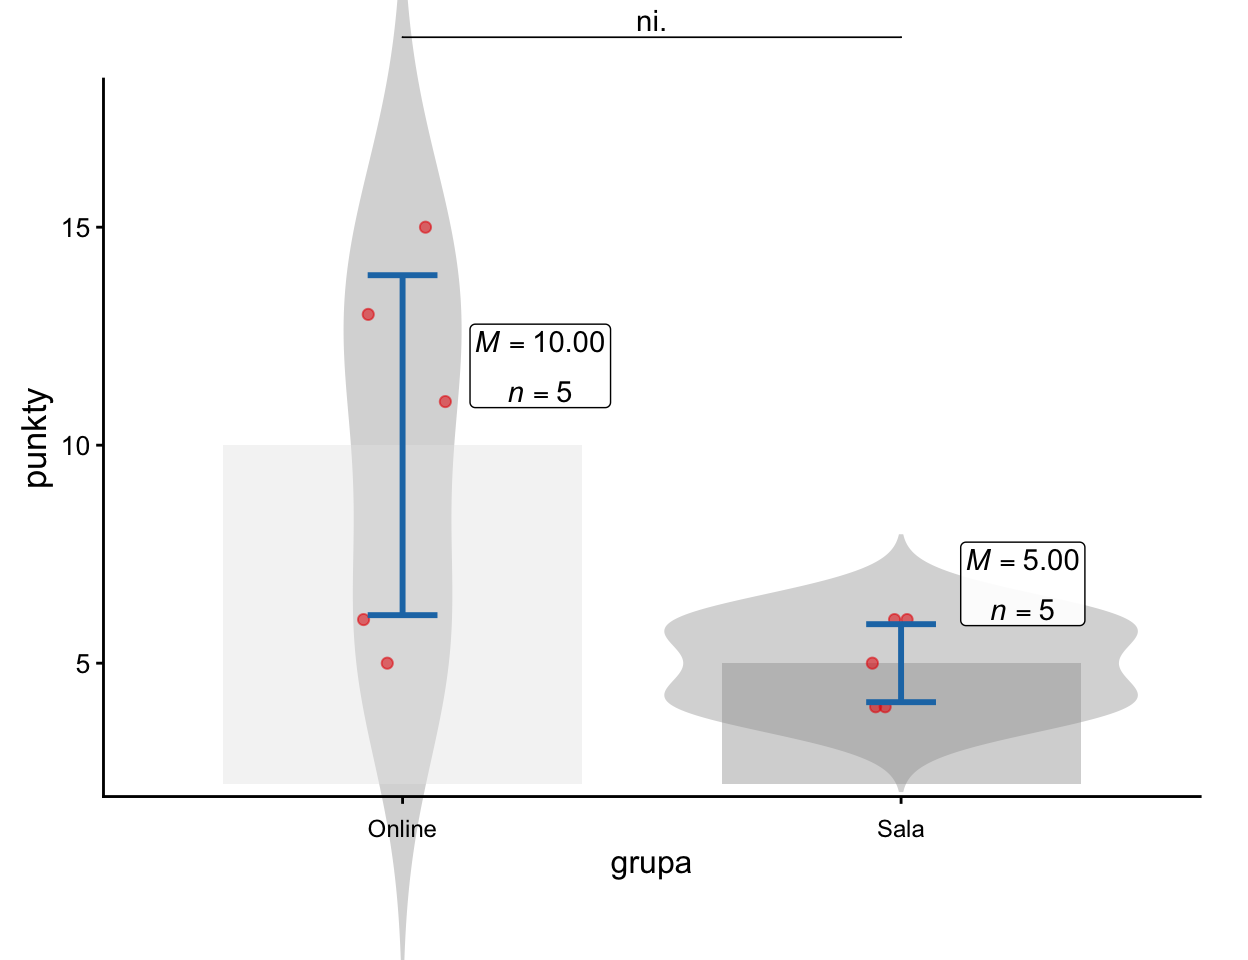
Kolokwium (0–20 punktów) napisało pięcioro studentów na sali i pięcioro online. Te same dane analizujemy w haśle o teście Levene’a – tam wyszło, że wariancje istotnie się różnią.
| Sala x | x − 5 | (x − 5)² | Online x | x − 10 | (x − 10)² |
|---|---|---|---|---|---|
| 4 | −1 | 1 | 5 | −5 | 25 |
| 4 | −1 | 1 | 6 | −4 | 16 |
| 5 | 0 | 0 | 11 | 1 | 1 |
| 6 | 1 | 1 | 13 | 3 | 9 |
| 6 | 1 | 1 | 15 | 5 | 25 |
| Σ = 25 | 0 | 4 | Σ = 50 | 0 | 76 |
- Średnie. Sala: 25 / 5 = 5. Online: 50 / 5 = 10. Różnica: 5 punktów.
- Wariancje. Sala: 4 / 4 = 1. Online: 76 / 4 = 19.
- Mianownik. 1 / 5 = 0,2 i 19 / 5 = 3,8; \(\sqrt{0{,}2 + 3{,}8} = \sqrt{4} = 2\).
- Statystyka t. t = 5 / 2 = 2,50.
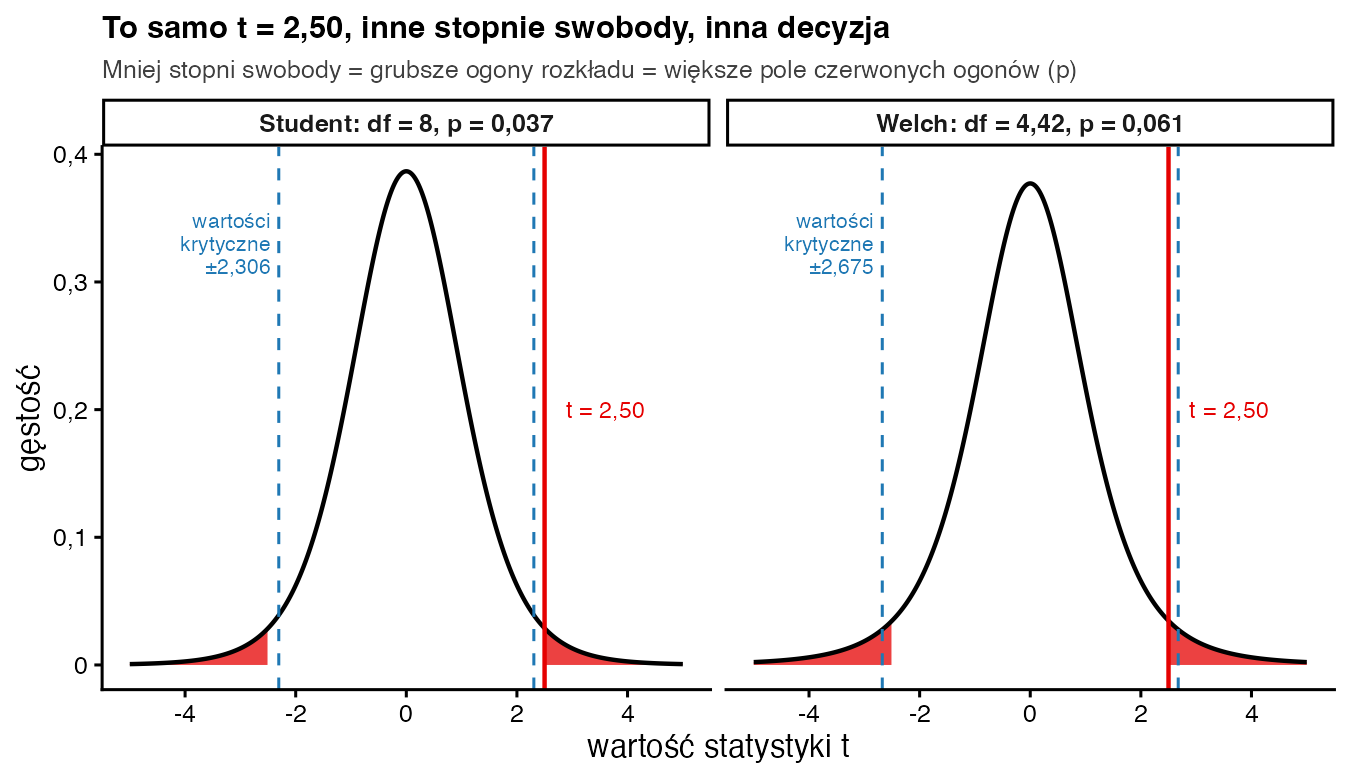
- Stopnie swobody. \(df = (0{,}2 + 3{,}8)^2 / (0{,}2^2/4 + 3{,}8^2/4) = 16 / (0{,}01 + 3{,}61) = 16 / 3{,}62 = 4{,}42\).
- Wartość p. Dla t = 2,50 i df = 4,42 program podaje p = 0,061. Brak podstaw do odrzucenia H0.
- Porównanie. Klasyczny test Studenta daje to samo t = 2,50 (przy równych grupach mianowniki są identyczne), ale df = 8 i p = 0,037. Decyzja zmienia się wyłącznie przez stopnie swobody.
Jak zinterpretować i opisać wynik?
Studenci piszący online uzyskali średnio o 5 punktów więcej, ale przy tak dużym rozrzucie i pięciu osobach w grupie różnica nie okazała się istotna. Nie oznacza to, że forma kolokwium nie ma znaczenia – badanie mogło mieć po prostu za małą moc. Stopnie swobody podawaj z dwoma miejscami po przecinku i zaznacz, że to test Welcha. Wielkość efektu możesz opisać d Cohena liczonym ze średniej wariancji obu grup: \(d = 5 / \sqrt{(1 + 19)/2} = 1{,}58\).
Zapis w stylu APA: Studenci piszący kolokwium online (M = 10,00; SD = 4,36) nie różnili się istotnie od piszących na sali (M = 5,00; SD = 1,00), test t Welcha: t(4,42) = 2,50; p = 0,061; d = 1,58.
Jak policzyć test t Welcha w R?
sala   <- c(4, 4, 5, 6, 6)
online <- c(5, 6, 11, 13, 15)

# 1) „ręcznie”, według wzoru Welcha
v_on <- var(online) / 5; v_sa <- var(sala) / 5         # 3.8 i 0.2
t  <- (mean(online) - mean(sala)) / sqrt(v_on + v_sa)   # 2.5
df <- (v_on + v_sa)^2 / (v_on^2 / (5 - 1) + v_sa^2 / (5 - 1))
c(t = t, df = df, p = 2 * pt(-abs(t), df))

# 2) gotową funkcją – w R t.test() domyślnie liczy test Welcha
t.test(online, sala)

# 3) dla porównania: klasyczny test Studenta (wspólna wariancja)
t.test(online, sala, var.equal = TRUE)$p.value
Wynik w konsoli R:
         t         df          p
2.50000000 4.41988950 0.06089481

	Welch Two Sample t-test

data:  online and sala
t = 2.5, df = 4.4199, p-value = 0.06089
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 -0.3509059 10.3509059
sample estimates:
mean of x mean of y
       10         5

[1] 0.03694204
SPSS pokazuje dwa wiersze testu t – który wybrać?
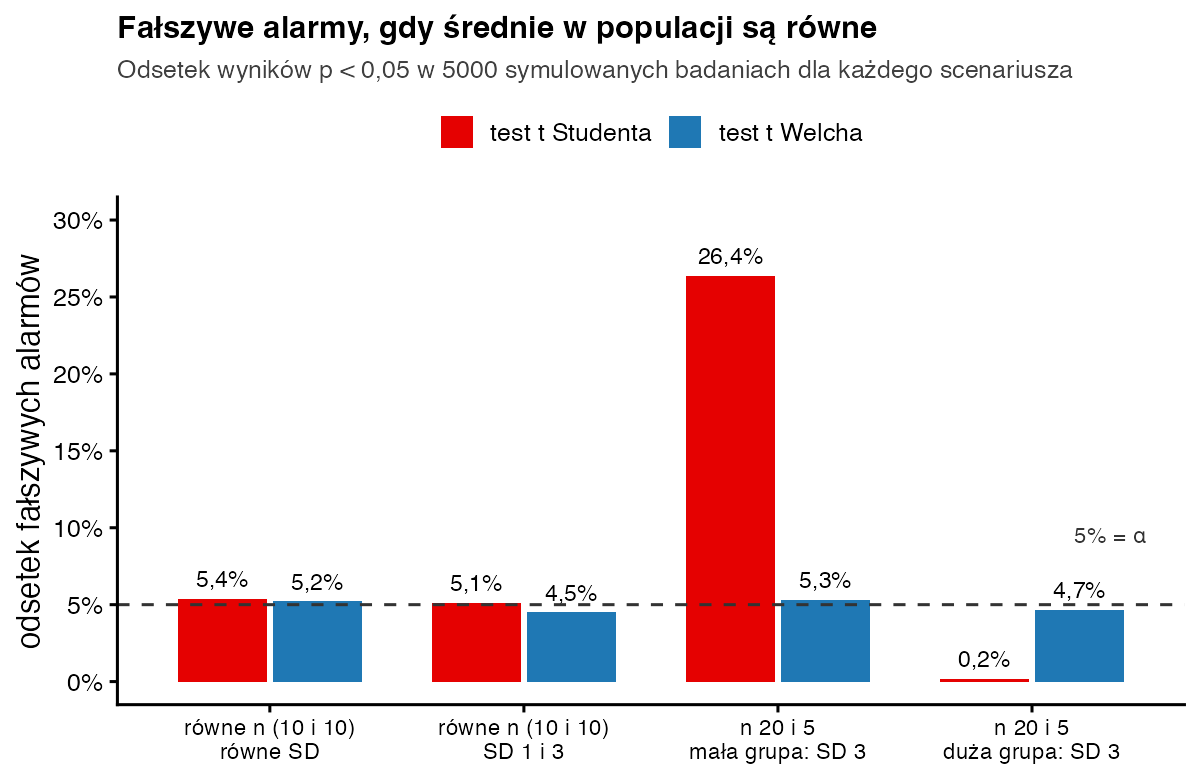
Wiersz „Equal variances assumed” to klasyczny test Studenta, a „Equal variances not assumed” – test Welcha. Najprościej i najbezpieczniej raportować drugi wiersz, niezależnie od wyniku testu Levene’a. Gdy wariancje i liczebności są podobne, oba wiersze dają prawie to samo. Gdy się różnią, Welch chroni Cię przed fałszywym alarmem (rysunek 3). Nie wybieraj wiersza po tym, który daje „ładniejsze” p.
Najczęstsze błędy
- Zaokrąglanie stopni swobody do liczby całkowitej (t(4) zamiast t(4,42)) albo podawanie df = n1 + n2 − 2.
- Wybór między testem Studenta a Welcha po sprawdzeniu, który daje istotny wynik.
- Uzależnianie wyboru testu wyłącznie od testu Levene’a przy bardzo małych grupach.
- Nazywanie testu Welcha nieparametrycznym – nadal porównuje średnie i wymaga rozkładów zbliżonych do normalnego.
- Użycie testu Welcha dla tych samych osób zbadanych dwa razy – tu potrzebny jest test t dla prób zależnych.
Bibliografia
- Welch, B. L. (1947). The generalization of “Student’s” problem when several different population variances are involved. Biometrika, 34(1–2), 28–35. https://doi.org/10.1093/biomet/34.1-2.28
- Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin, 2(6), 110–114. https://doi.org/10.2307/3002019
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest t Studenta dla prób niezależnych
- Słownik wzorówTest Levene’a
- Słownik wzorówd Cohena – wielkość efektu
- PoradnikTesty parametryczne
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportTest t Studenta
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.