

Test t Studenta – przykład krok po kroku z interpretacją
Ten wpis prowadzi przez całą analizę testem t dla prób niezależnych: od pytania badawczego, przez sprawdzenie założeń, po gotowy akapit wyników i tabelę do pracy. Przykładowe pytanie z pracy dyplomowej: czy studenci powtarzający materiał z quizów piszą kolokwium lepiej niż ci, którzy uczą się z notatek?
W skróciePytanie i hipotezy → statystyki opisowe → założenia → test t i test Welcha → d Cohena → opis w stylu APA, tabela i wykres. Wzór i obliczenia ręczne na mniejszych danych znajdziesz w haśle test t Studenta dla prób niezależnych. Tutaj skupiamy się na tym, jak analizę przeprowadzić, opisać i obronić.
Krok 1. Pytanie badawcze i hipotezy
Prowadzący losowo podzielił 16 studentów na dwie grupy. Grupa „Notatki” powtarzała materiał z własnych notatek, a grupa „Quizy” rozwiązywała krótkie quizy. Zmienna zależna to punkty z kolokwium (0–10). Każda osoba należy tylko do jednej grupy, dlatego wybieramy test dla prób niezależnych.
- H0: średnia liczba punktów w populacji jest w obu grupach taka sama (\(\mu_Q = \mu_N\));
- H1: średnie się różnią (\(\mu_Q \neq \mu_N\)); test dwustronny, poziom istotności α = 0,05.
Krok 2. Dane i statystyki opisowe
| Grupa | Wyniki 8 osób | M | SD | Me |
|---|---|---|---|---|
| Notatki | 1, 3, 3, 4, 4, 5, 6, 6 | 4,00 | 1,69 | 4,0 |
| Quizy | 3, 5, 6, 7, 8, 8, 9, 10 | 7,00 | 2,27 | 7,5 |
Grupa Quizy ma średnio o 3 punkty więcej. Rozrzut wyników w obu grupach jest podobny, a mediany leżą blisko średnich, więc nic nie wskazuje na silną skośność.
Krok 3. Sprawdzenie założeń
- Niezależność obserwacji wynika z planu badania: każda osoba jest w jednej grupie i pisała kolokwium raz.
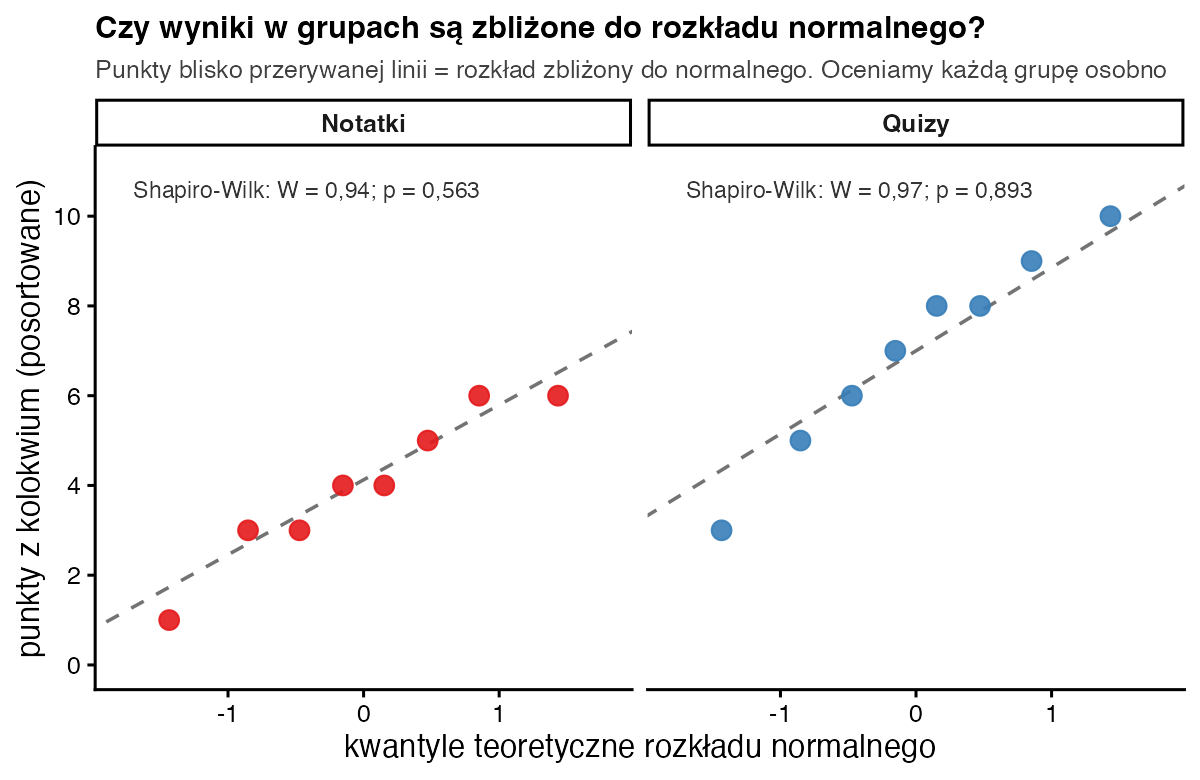
- Rozkład zbliżony do normalnego w każdej grupie. Test Shapiro-Wilka: Notatki W = 0,94; p = 0,563, Quizy W = 0,97; p = 0,893. Przy 8 osobach test ma małą moc, więc obejrzyj też wykres kwantyl-kwantyl (rys. 1).
- Podobne wariancje. Test Levene’a: F(1, 14) = 0,74; p = 0,405. Nie ma podstaw, by odrzucić założenie o równości wariancji.
Krok 4. Test t i wielkość efektu
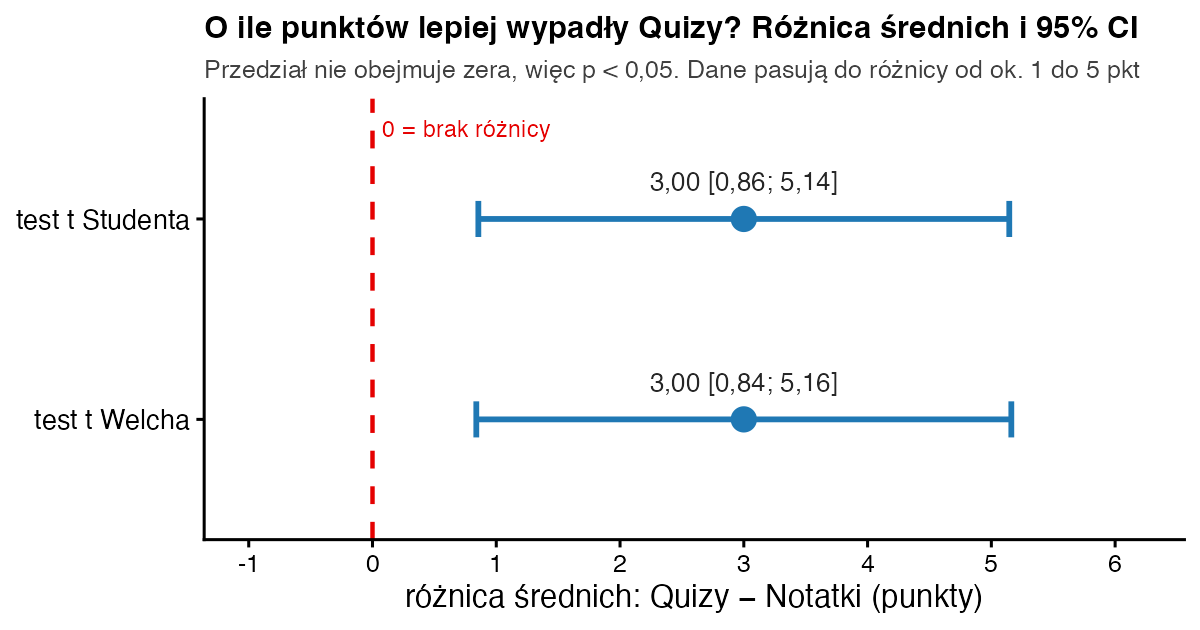
- Test t Studenta: t(14) = 3,00; p = 0,010. Różnica średnich wynosi 3 punkty, 95% CI [0,86; 5,14].
- Test t Welcha (bez założenia równych wariancji): t(12,94) = 3,00; p = 0,010. Przy równych grupach t jest identyczne, zmieniają się tylko stopnie swobody, a wniosek zostaje ten sam.
- Decyzja: p < 0,05, więc odrzucamy H0. Gdyby sposób powtórki nie miał znaczenia, różnica co najmniej tak duża pojawiałaby się w około 1% podobnych badań.
- Wielkość efektu: d Cohena = 3 / 2 = 1,50 (wspólne odchylenie standardowe wynosi 2), 95% CI [0,36; 2,60]. Według konwencji Cohena (1988) to efekt duży, ale szeroki przedział pokazuje, jak niepewne jest oszacowanie przy 16 osobach.
Krok 5. Jak opisać wynik w pracy?
Zapis w stylu APA: Studenci powtarzający materiał z quizów (M = 7,00; SD = 2,27) uzyskali istotnie więcej punktów z kolokwium niż studenci uczący się z notatek (M = 4,00; SD = 1,69), t(14) = 3,00; p = 0,010; d = 1,50. Różnica wyniosła 3 punkty, 95% CI [0,86; 5,14]. Test t Welcha dał ten sam wynik, t(12,94) = 3,00; p = 0,010.
| Zmienna | Notatki M (SD) | Quizy M (SD) | t(14) | p | d Cohena |
|---|---|---|---|---|---|
| punkty z kolokwium | 4,00 (1,69) | 7,00 (2,27) | 3,00 | 0,010 | 1,50 |
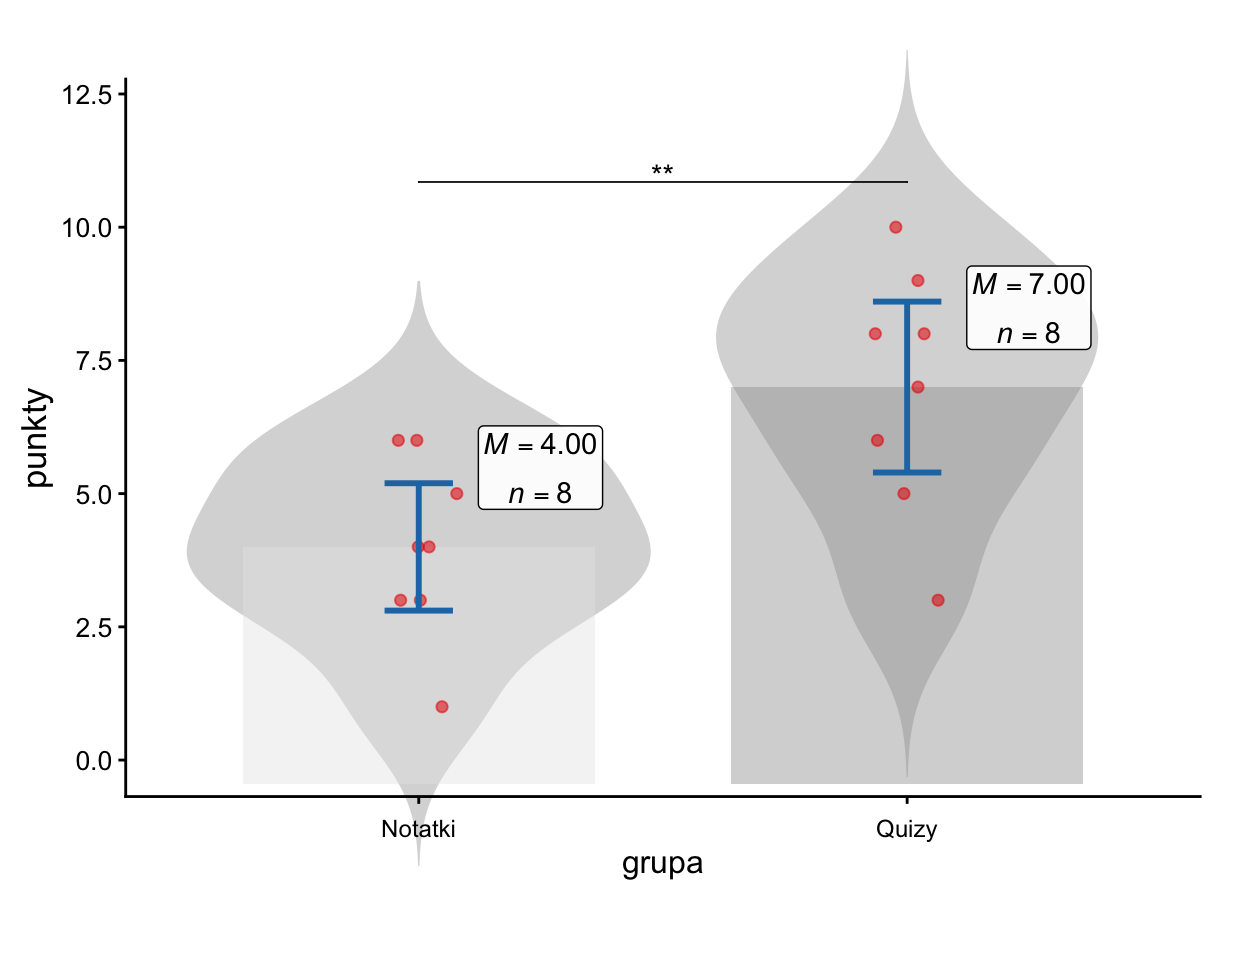
Pod tabelą dodaj notę: liczebność grup (n = 8), rodzaj testu i informację o wyniku testu Welcha. Wykres opisz w podpisie jednym–dwoma zdaniami (co oznaczają słupki, wąsy i kropki) i odwołaj się do niego w tekście, np. „Rozkład wyników w grupach przedstawia Rysunek 2”. Nie powtarzaj w tekście wszystkich liczb z tabeli. Tak wygląda pełny raport z takiej analizy w SZTOS: przykładowy raport testu t.
Cała analiza w R
# Dane: punkty z kolokwium (0–10), po 8 osób w grupie
notatki <- c(1, 3, 3, 4, 4, 5, 6, 6)
quizy   <- c(3, 5, 6, 7, 8, 8, 9, 10)
dane <- data.frame(grupa  = factor(rep(c("Notatki", "Quizy"), each = 8)),
                   punkty = c(notatki, quizy))

# 1) statystyki opisowe w grupach
aggregate(punkty ~ grupa, data = dane,
          FUN = function(x) c(M = mean(x), SD = round(sd(x), 2), Me = median(x)))

# 2) założenia: normalność w każdej grupie (p Shapiro-Wilka) i równość wariancji
sapply(list(Notatki = notatki, Quizy = quizy), function(x) round(shapiro.test(x)$p.value, 3))
car::leveneTest(punkty ~ grupa, data = dane, center = mean)

# 3) test t Studenta (równe wariancje) i dla porównania test Welcha
t.test(quizy, notatki, var.equal = TRUE)
welch <- t.test(quizy, notatki)
round(c(welch$statistic, welch$parameter, p = welch$p.value), 3)

# 4) wielkość efektu: d Cohena z 95% przedziałem ufności
effectsize::cohens_d(quizy, notatki)
Wynik w konsoli R:
    grupa punkty.M punkty.SD punkty.Me
1 Notatki     4.00      1.69      4.00
2   Quizy     7.00      2.27      7.50
Notatki   Quizy
  0.563   0.893
Levene's Test for Homogeneity of Variance (center = mean)
      Df F value Pr(>F)
group  1  0.7368 0.4051
      14

	Two Sample t-test

data:  quizy and notatki
t = 3, df = 14, p-value = 0.009552
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
 0.8552133 5.1447867
sample estimates:
mean of x mean of y
        7         4

     t     df      p
 3.000 12.943  0.010
Cohen's d |       95% CI
------------------------
1.50      | [0.36, 2.60]

- Estimated using pooled SD.
Co zrobić, gdy założenia nie są spełnione?
Gdy wariancje wyraźnie się różnią, zwłaszcza przy nierównych grupach, raportuj test t Welcha. Wielu metodologów zaleca go nawet jako wybór domyślny (Delacre i in., 2017). Gdy rozkłady są mocno skośne, mają wartości odstające albo zmienna jest porządkowa, użyj testu U Manna-Whitneya. Cały jego przebieg pokazujemy we wpisie test U Manna-Whitneya – przykład. Na naszych danych daje on ten sam wniosek: U = 9,5; p = 0,020. Test wybierz przed zobaczeniem wyników i uzasadnij wybór w rozdziale o metodzie.
Pytania promotora i recenzenta
Czy 8 osób w grupie to nie za mało?
Test t działa także w małych grupach, ale ma wtedy małą moc i daje szerokie przedziały ufności. Dlatego oprócz p podaj d Cohena z przedziałem ufności. Liczebność najlepiej zaplanować przed badaniem, na podstawie spodziewanej wielkości efektu.
Czy mogę napisać, że quizy poprawiają wyniki?
Tutaj tak, ostrożnie, bo studentów przydzielono do grup losowo. Jeśli porównujesz grupy, które same się wybrały (np. osoby, które z własnej woli robią quizy), pisz o różnicy między grupami, a nie o wpływie metody.
A jeśli porównuję trzy grupy?
Wtedy zamiast serii testów t wykonaj jednoczynnikową analizę wariancji. Cały przebieg znajdziesz we wpisie ANOVA – przykład krok po kroku.
Bibliografia
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Welch, B. L. (1947). The generalization of “Student’s” problem when several different population variances are involved. Biometrika, 34(1–2), 28–35. https://doi.org/10.1093/biomet/34.1-2.28
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówTest t Studenta dla prób niezależnych
- Słownik wzorówTest t Studenta dla prób zależnych
- Słownik wzorówd Cohena – wielkość efektu
- PoradnikTest U Manna-Whitneya – przykład
- PoradnikTesty parametryczne
- Przykładowy raportTest t Studenta
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.