

SPSS – analiza danych krok po kroku: procedury i tabele
Ten wpis prowadzi przez pięć procedur SPSS, których studenci używają najczęściej: częstości, statystyki opisowe, test t z testem Levene’a, korelację i regresję. Typowe pytanie z pracy dyplomowej: które liczby z tabel SPSS przepisać do pracy i jak je zapisać?
W skrócieDane → częstości → statystyki opisowe → test t z testem Levene’a → korelacja → regresja → opis w stylu APA. Ścieżki menu podajemy według polskiego podręcznika IBM SPSS Statistics 29, a każdą liczbę sprawdzamy w R. Wzory i obliczenia ręczne znajdziesz w hasłach słownika, do których prowadzą linki.
Krok 1. Dane w SPSS
Dziesięcioro studentów uczyło się do kolokwium z notatek albo z quizów. Zapisaliśmy kierunek (jedna osoba go nie podała), liczbę godzin nauki i punkty (0–10).
| Osoba | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|
| grupa | N | N | N | N | N | Q | Q | Q | Q | Q |
| kierunek | psy | eko | psy | psy | brak | eko | psy | eko | psy | eko |
| godziny | 3 | 2 | 1 | 4 | 5 | 4 | 3 | 5 | 6 | 7 |
| punkty | 1 | 2 | 3 | 4 | 5 | 4 | 5 | 6 | 7 | 8 |
N – Notatki, Q – Quizy, psy – psychologia, eko – ekonomia. W Widoku zmiennych ustaw poziom pomiaru: kierunek i grupa – nominalny, godziny i punkty – ilościowy. Brak danych zostaw pusty albo zadeklaruj jego kod (np. 99) jako brak. Inaczej SPSS policzy 99 jak zwykły wynik.
Krok 2. Częstości
Analiza → Statystyki opisowe → Częstości. Tabela pokazuje częstość, procent i procent ważnych (ang. Valid Percent). Psychologię podało 5 osób: to 50,0% wszystkich i 55,6% ważnych odpowiedzi. Ekonomię – 4 osoby (40,0% i 44,4%), a 1 osoba (10,0%) to brak danych. W pracy podaj procent ważnych i liczbę braków (zobacz: częstości i procenty).
Krok 3. Statystyki opisowe
Analiza → Statystyki opisowe → Statystyki opisowe. Dostajesz N, minimum, maksimum, średnią i odchylenie standardowe. Godziny nauki: M = 4,00; SD = 1,83 (od 1 do 7). Punkty: M = 4,50; SD = 2,17 (od 1 do 8).
Krok 4. Test t dla prób niezależnych
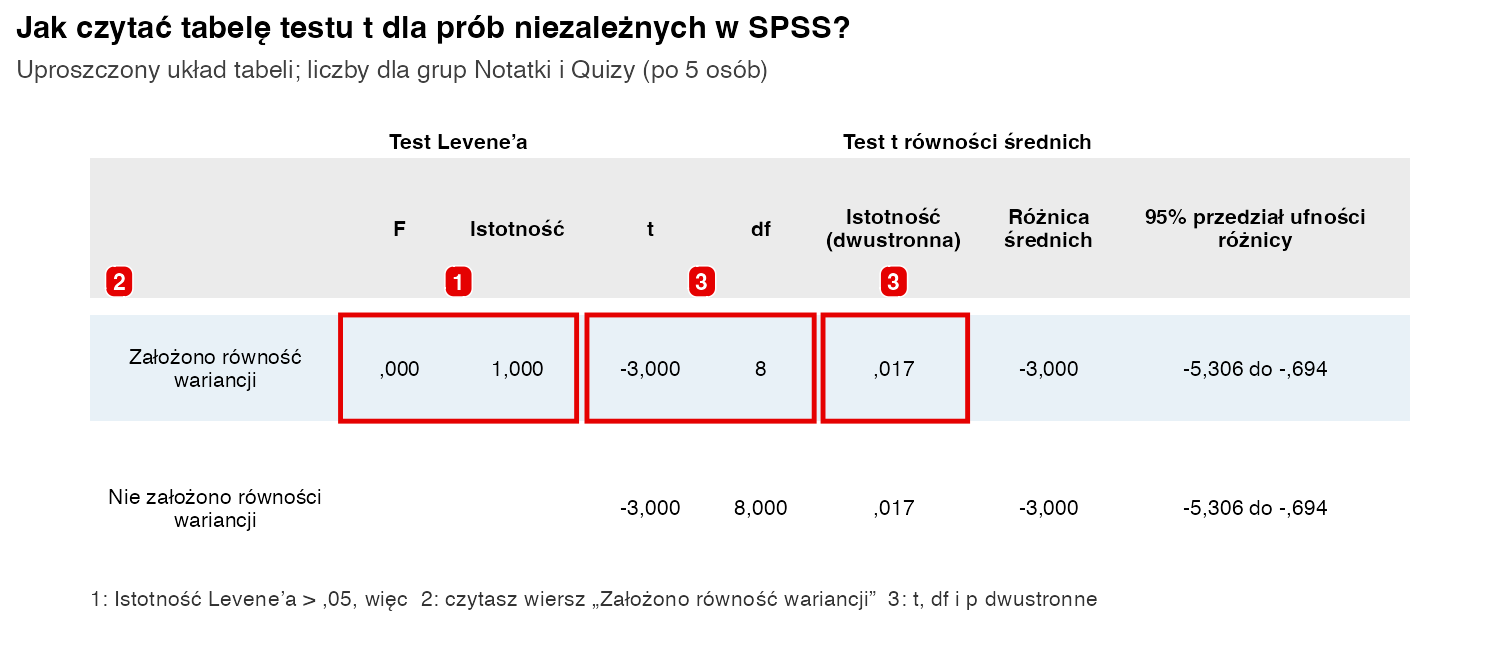
Analiza → Porównywanie średnich → Test t dla prób niezależnych. Punkty przenieś do zmiennych testowanych, grupę do zmiennej grupującej, w „Definiuj grupy” wpisz kody obu grup i zaznacz „Szacuj wielkości efektów”. Tabelę czytasz w trzech krokach (Rys. 1).
- Test Levene’a: F = 0,00; istotność 1,000. To więcej niż 0,05, więc nie ma podstaw, by odrzucić założenie o równości wariancji.
- Wiersz: czytasz „Założono równość wariancji”. Przy istotnym teście Levene’a czytasz wiersz drugi, czyli test Welcha.
- Wynik: t(8) = −3,00; p = 0,017; różnica średnich −3,00, czyli Notatki minus Quizy. Wielkość efektu: d Cohena = −1,90. Minus wynika z kolejności grup, a wartość 1,90 to według umownych progów efekt duży (Cohen, 1988).
Krok 5. Korelacja i regresja
Analiza → Korelacje → Parami. Korelacja Pearsona godzin nauki i punktów wynosi 0,84, istotność (dwustronna) 0,002, N = 10. Dwie gwiazdki przy współczynniku oznaczają p < 0,01.
Analiza → Regresja → Liniowe. Tabela podsumowania modelu podaje R = 0,84 i R-kwadrat = 0,71, tabela ANOVA – F(1, 8) = 19,20; p = 0,002, a tabela współczynników – stałą B = 0,50 i nachylenie B = 1,00. Każda dodatkowa godzina nauki wiąże się średnio z 1 punktem więcej. W regresji z jednym predyktorem standaryzowana Beta równa się r (0,84). Uwaga: grupa Quizy uczyła się też dłużej (średnio 5 godzin wobec 3), więc ten związek nie dowodzi, że to godziny „dają” punkty.
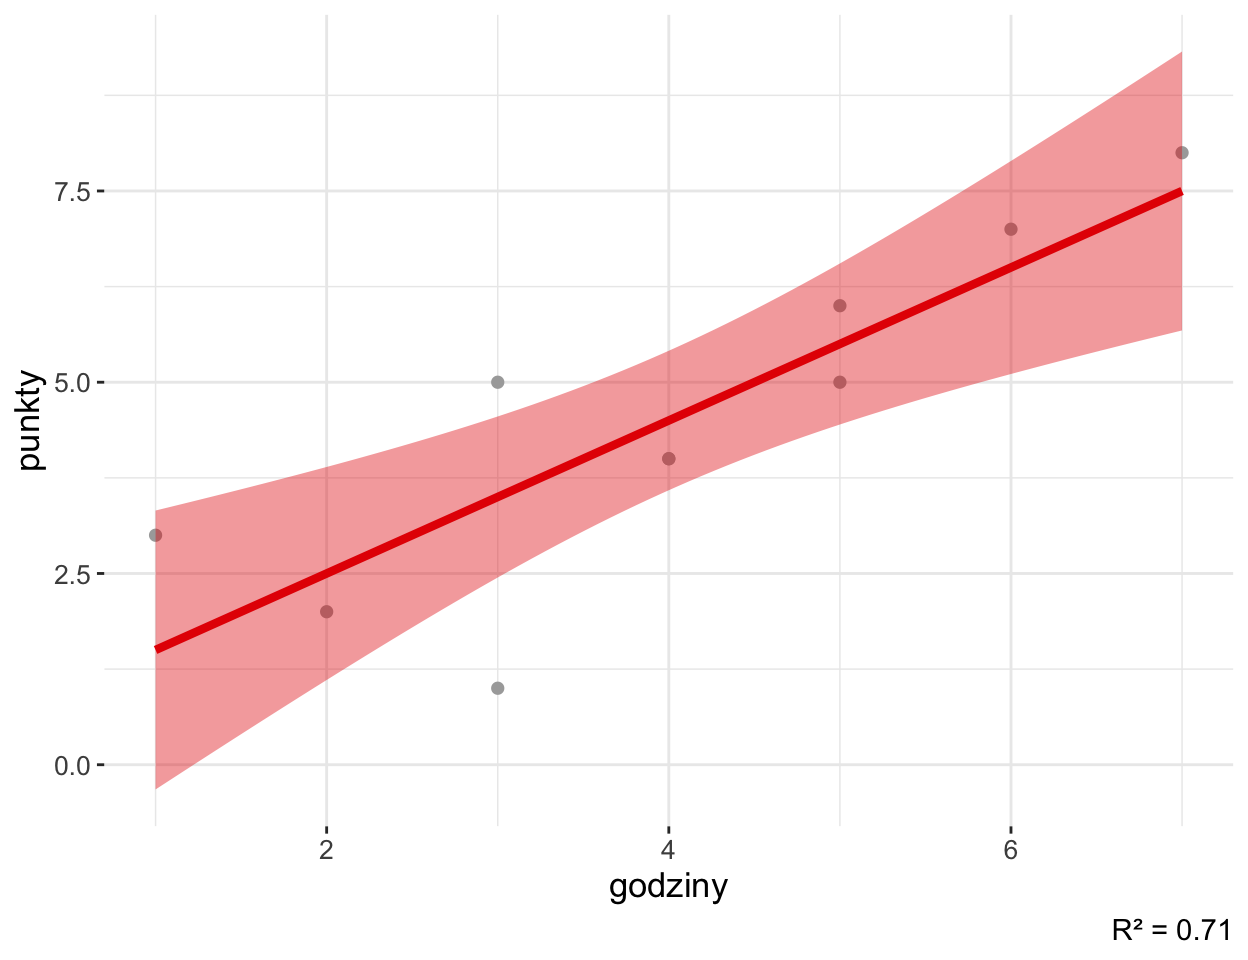
W tekście pracy odwołaj się do rysunku jednym zdaniem, np. „Związek liczby godzin nauki z wynikiem kolokwium przedstawia Rysunek 2”. W podpisie wyjaśnij, co oznaczają linia i pas. Nie przepisuj do tekstu wszystkich liczb z tabel SPSS – wybierz te, które odpowiadają na hipotezę, a resztę zostaw w tabeli.
Te same liczby w R
# Dane 10 studentów – tak jak w Widoku danych SPSS (NA = brak danych)
dane <- data.frame(
  grupa    = rep(c("Notatki", "Quizy"), each = 5),
  kierunek = c("psychologia", "ekonomia", "psychologia", "psychologia", NA,
               "ekonomia", "psychologia", "ekonomia", "psychologia", "ekonomia"),
  godziny  = c(3, 2, 1, 4, 5, 4, 3, 5, 6, 7),
  punkty   = c(1, 2, 3, 4, 5, 4, 5, 6, 7, 8))

# 1) Częstości: liczebność, procent (z brakami) i procent ważnych (bez braków)
cz <- table(dane$kierunek, useNA = "ifany")
cbind(n = cz, procent = round(100 * prop.table(cz), 1),
      procent_waznych = round(100 * c(prop.table(table(dane$kierunek)), NA), 1))

# 2) Statystyki opisowe: N, minimum, maksimum, średnia, odchylenie standardowe
round(sapply(dane[, c("godziny", "punkty")], function(x) c(N = length(x), Min = min(x),
      Max = max(x), M = mean(x), SD = sd(x))), 2)

# 3) Test t: Levene ze średnią (jak w SPSS), wiersz „Założono równość wariancji”, d Cohena
car::leveneTest(punkty ~ factor(grupa), data = dane, center = mean)
tt <- t.test(punkty ~ grupa, data = dane, var.equal = TRUE)
round(c(t = unname(tt$statistic), df = unname(tt$parameter), p = tt$p.value,
        roznica = unname(-diff(tt$estimate))), 3)
d <- effectsize::cohens_d(punkty ~ grupa, data = dane)
round(c(d = d$Cohens_d, CI_dolna = d$CI_low, CI_gorna = d$CI_high), 2)

# 4) Korelacja Pearsona i 5) regresja liniowa: punkty = a + b · godziny
kor <- cor.test(dane$godziny, dane$punkty)
round(c(r = unname(kor$estimate), p = kor$p.value), 3)
model <- lm(punkty ~ godziny, data = dane)
round(c(coef(model), R2 = summary(model)$r.squared, F = unname(summary(model)$fstatistic[1])), 3)
Wynik w konsoli R:
            n procent procent_waznych
ekonomia    4      40            44.4
psychologia 5      50            55.6
<NA>        1      10              NA
    godziny punkty
N     10.00  10.00
Min    1.00   1.00
Max    7.00   8.00
M      4.00   4.50
SD     1.83   2.17
Levene's Test for Homogeneity of Variance (center = mean)
      Df F value Pr(>F)
group  1       0      1
       8
      t      df       p roznica
 -3.000   8.000   0.017  -3.000
       d CI_dolna CI_gorna
   -1.90    -3.40    -0.32
    r     p
0.840 0.002
(Intercept)     godziny          R2           F
      0.500       1.000       0.706      19.200
Zapis w stylu APA: Studenci uczący się z quizów (M = 6,00; SD = 1,58) uzyskali istotnie więcej punktów niż studenci uczący się z notatek (M = 3,00; SD = 1,58), t(8) = 3,00; p = 0,017; d = 1,90. Liczba godzin nauki była dodatnio związana z liczbą punktów, r(8) = 0,84; p = 0,002; b = 1,00; R² = 0,71.
| Zmienna | M | SD | Min–Max | 1 |
|---|---|---|---|---|
| 1. Godziny nauki | 4,00 | 1,83 | 1–7 | – |
| 2. Punkty z kolokwium | 4,50 | 2,17 | 1–8 | 0,84** |
Pod tabelą dodaj notę: N = 10; ** p < 0,01. Dziesięć osób to tylko ilustracja – w prawdziwym badaniu potrzebujesz większej próby.
Pytania o tabele SPSS
SPSS pokazuje istotność ,000. Jak to zapisać?
Nie pisz p = 0. SPSS zaokrągla do trzech miejsc, więc zapisz p < 0,001.
Test Levene’a wyszedł istotny. Który wiersz podać?
Wiersz „Nie założono równości wariancji”, czyli test Welcha. Wielu metodologów zaleca go nawet jako wybór domyślny (Delacre i in., 2017).
Czy da się to zrobić bez licencji SPSS?
Tak. Te same tabele policzysz w darmowym programie jamovi albo w R, a inne możliwości porównujemy we wpisie programy do statystyki.
Bibliografia
- IBM. (b.d.). IBM SPSS Statistics Base 29 [Podręcznik użytkownika]. https://www.ibm.com/docs/SSLVMB_29.0.0/nl/pl/pdf/IBM_SPSS_Statistics_Base.pdf
- Field, A. (2018). Discovering statistics using IBM SPSS Statistics (5th ed.). SAGE.
- Levene, H. (1960). Robust tests for equality of variances. W I. Olkin, S. G. Ghurye, W. Hoeffding, W. G. Madow i H. B. Mann (Red.), Contributions to probability and statistics: Essays in honor of Harold Hotelling (s. 278–292). Stanford University Press.
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikProgramy do statystyki – porównanie
- PoradnikProgram jamovi
- PoradnikStatystyka opisowa – przykład
- PoradnikTest t Studenta – przykład
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.