

Dwuczynnikowa analiza wariancji (ANOVA) dla prób niezależnych – wzory i przykład
Dwuczynnikowa ANOVA sprawdza jednocześnie wpływ dwóch czynników na średnie wyniki oraz to, czy czynniki te współdziałają (interakcja). Typowe pytanie z pracy dyplomowej: czy nauka z quizów daje więcej punktów niż nauka z notatek i czy ta przewaga zależy od długości snu przed kolokwium?
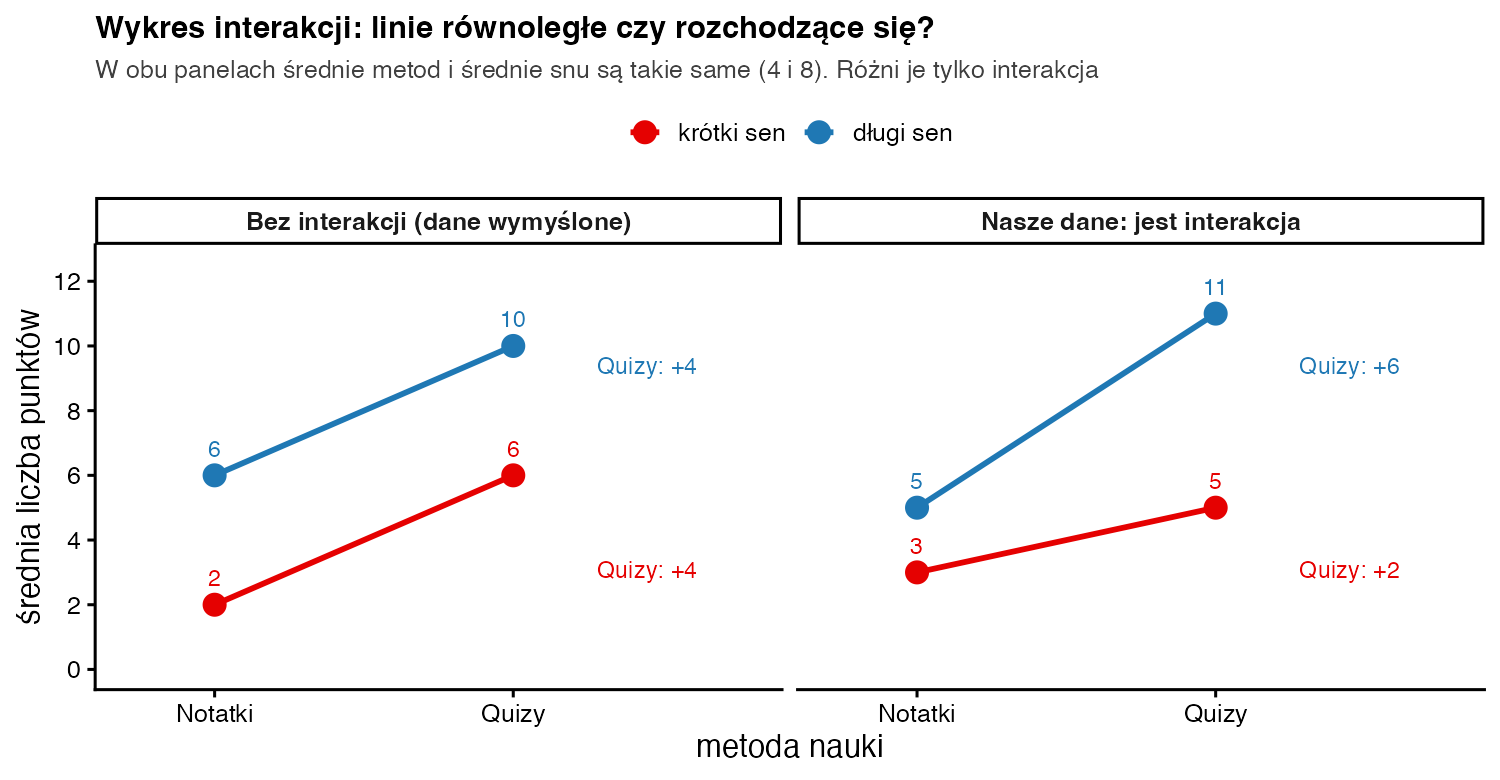
W prostych słowachCałą zmienność wyników dzielisz na cztery części: tę związaną z pierwszym czynnikiem, z drugim, z ich połączeniem i resztę, której nic nie wyjaśnia. Każdą część porównujesz z resztą. Interakcja oznacza, że działanie jednego czynnika zależy od poziomu drugiego – na wykresie linie nie są równoległe.
Kiedy stosować dwuczynnikową ANOVA?
- masz dwa czynniki jakościowe, a każda osoba trafia do jednej kombinacji ich poziomów;
- zmienna zależna jest ilościowa (punkty, czas, wynik skali);
- osoby w komórkach są różne i niezależne;
- reszty mają rozkład zbliżony do normalnego, a wariancje w komórkach są podobne (sprawdzisz to testem Levene’a).
Przy jednym czynniku wystarczy jednoczynnikowa ANOVA. Gdy te same osoby mierzysz kilka razy, potrzebujesz dwuczynnikowej ANOVA z powtarzanymi pomiarami. Kontrolę zmiennej ilościowej, np. pretestu, zapewnia analiza kowariancji.
Wzory dwuczynnikowej ANOVA
- \(a,\ b,\ n\)
- liczba poziomów czynnika A, liczba poziomów czynnika B i liczba osób w każdej komórce
- \(\bar{y}\)
- średnia ogólna wszystkich wyników
- \(\bar{y}_{i\cdot},\ \bar{y}_{\cdot j}\)
- średnie poziomów A (np. metod) i poziomów B (np. długości snu)
- \(\bar{y}_{ij}\)
- średnia w komórce, czyli w kombinacji poziomu i czynnika A z poziomem j czynnika B
- \(SS_E\)
- suma kwadratów błędu: odchylenia wyników od średniej ich własnej komórki
- \(F,\ df\)
- statystyka testu dla danego efektu i jej stopnie swobody
- \(\eta^2_p\)
- cząstkowe eta kwadrat, czyli wielkość efektu
Przykład krok po kroku
Dwunastu studentów losowo przydzielono do nauki z notatek albo z quizów. W każdej grupie połowa spała przed kolokwium krótko, a połowa długo, więc każda komórka ma 3 osoby (a = 2, b = 2, n = 3).
| Metoda | Sen | Punkty | Średnia komórki | Efekt interakcji \(\bar{y}_{ij} - \bar{y}_{i\cdot} - \bar{y}_{\cdot j} + \bar{y}\) | Σ(y − średnia komórki)² |
|---|---|---|---|---|---|
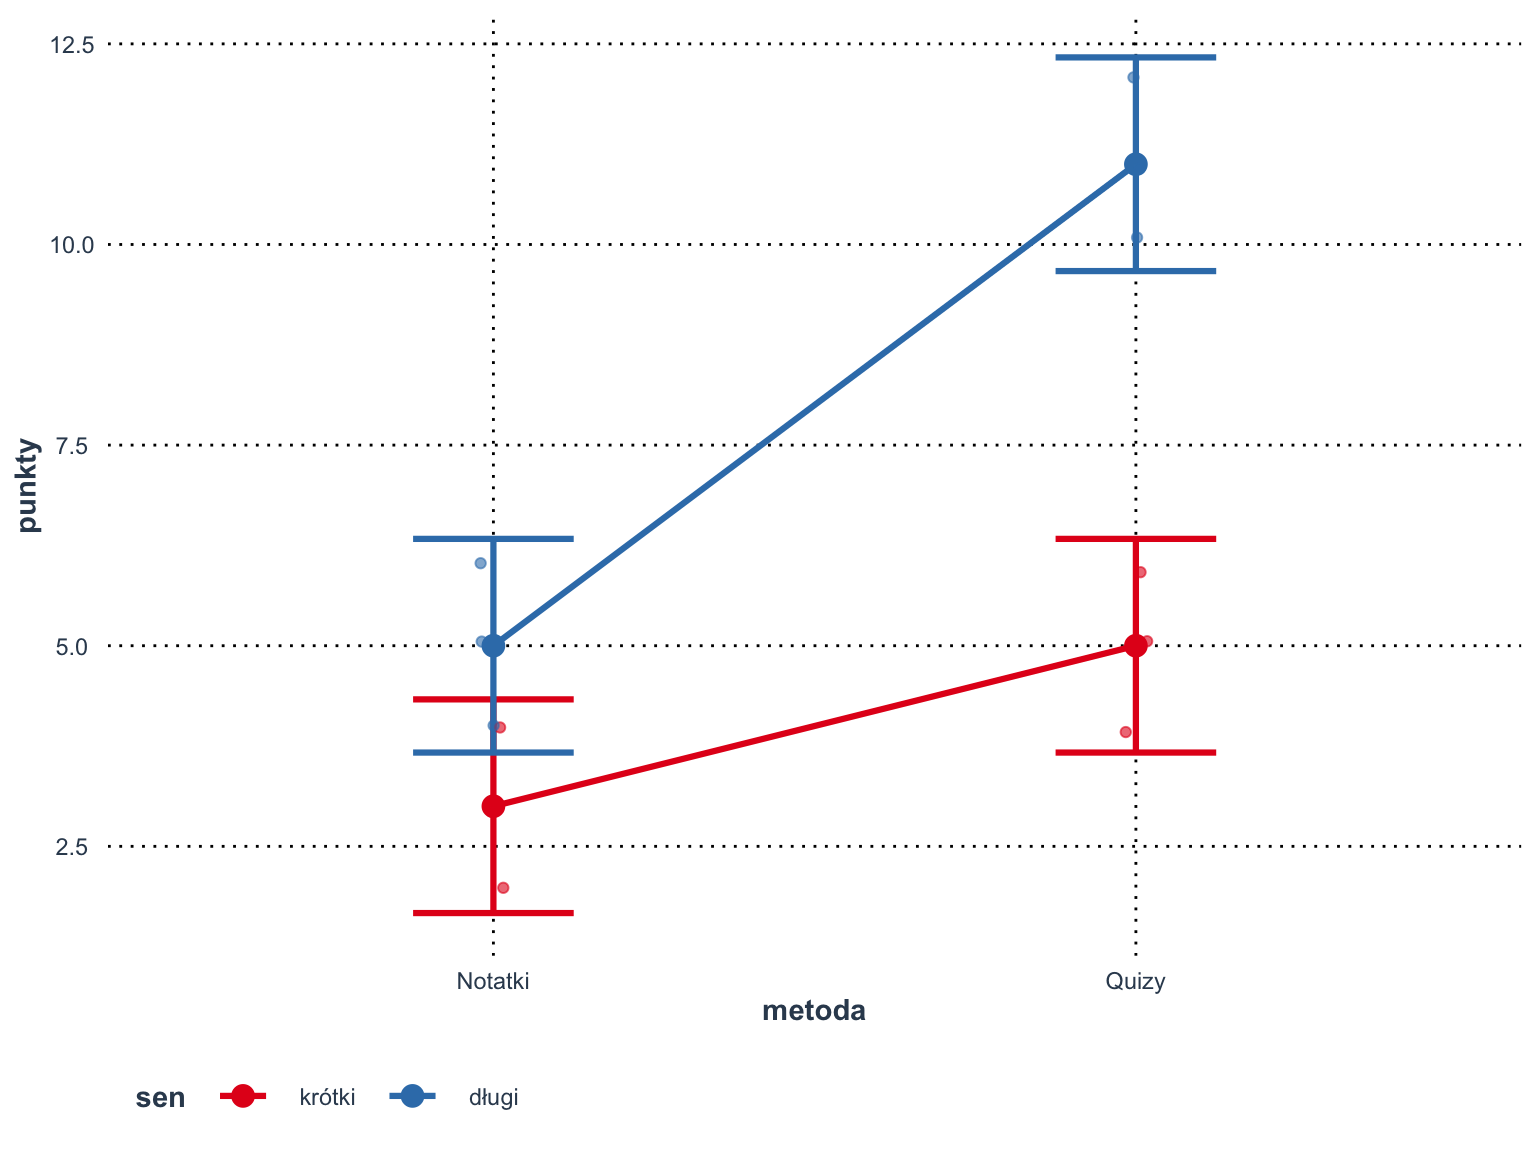
| Notatki | krótki | 2, 3, 4 | 3 | 3 − 4 − 4 + 6 = 1 | 2 |
| Notatki | długi | 4, 5, 6 | 5 | 5 − 4 − 8 + 6 = −1 | 2 |
| Quizy | krótki | 4, 5, 6 | 5 | 5 − 8 − 4 + 6 = −1 | 2 |
| Quizy | długi | 10, 11, 12 | 11 | 11 − 8 − 8 + 6 = 1 | 2 |
| Razem | Σ = 72 | średnia ogólna 6 | Σ kwadratów = 4 | SSE = 8 | |
- Średnie. Ogólna: 72 / 12 = 6. Metody: Notatki 4, Quizy 8. Sen: krótki 4, długi 8.
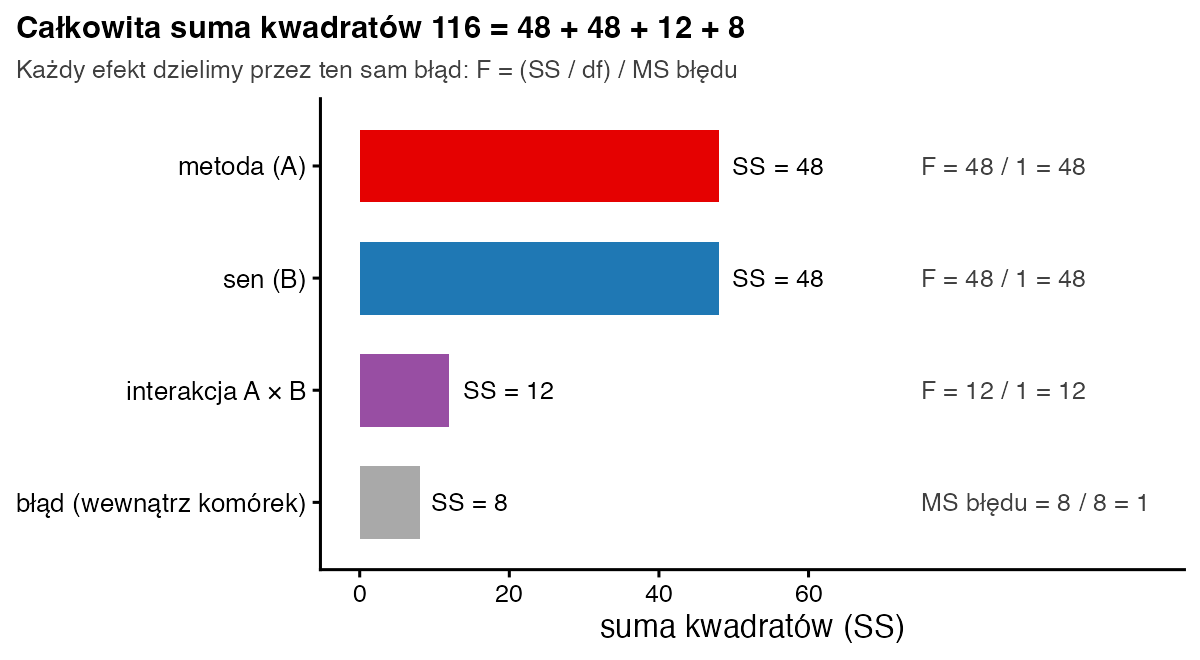
- Efekty główne. Na każdy poziom metody przypada b · n = 6 osób, więc SSA = 6 · [(4 − 6)² + (8 − 6)²] = 48. Tak samo SSB = 48.
- Interakcja. SSAB = 3 · (1 + 1 + 1 + 1) = 12.
- Błąd. SSE = 2 + 2 + 2 + 2 = 8; dfE = 4 · (3 − 1) = 8; MSE = 8 / 8 = 1. Kontrola: Σ(y − 6)² = 116 = 48 + 48 + 12 + 8.
- Statystyki F (df = 1 i 8). FA = 48 / 1 = 48; FB = 48; FAB = 12 / 1 = 12. Wartości p: < 0,001; < 0,001 i 0,009.
- Wielkość efektu. η²p = 48 / (48 + 8) = 0,86 dla metody i snu oraz 12 / (12 + 8) = 0,60 dla interakcji.
- Efekty proste. Po krótkim śnie quizy dają 2 punkty więcej (p = 0,040), a po długim – 6 punktów więcej (p < 0,001).
Jak zinterpretować i opisać wynik?
Wszystkie trzy efekty są istotne. Przy istotnej interakcji efekty główne opisz ostrożnie: quizy dają przewagę przy obu długościach snu, ale po krótkim śnie o 2 punkty, a po długim aż o 6. Duże η²p wynikają z małego rozrzutu w komórkach, a trzy osoby w komórce to tylko ilustracja rachunku.
Zapis w stylu APA: Wystąpił istotny efekt metody nauki, F(1, 8) = 48,00; p < 0,001; η²p = 0,86, istotny efekt długości snu, F(1, 8) = 48,00; p < 0,001; η²p = 0,86, oraz istotna interakcja tych czynników, F(1, 8) = 12,00; p = 0,009; η²p = 0,60. Przewaga quizów była większa po długim śnie (6 punktów; p < 0,001) niż po krótkim (2 punkty; p = 0,040).
Jak policzyć dwuczynnikową ANOVA w R?
punkty <- c(2, 3, 4,  4, 5, 6,  4, 5, 6,  10, 11, 12)
metoda <- factor(rep(c("Notatki", "Quizy"), each = 6))
sen    <- factor(rep(rep(c("krótki", "długi"), each = 3), 2), levels = c("krótki", "długi"))

# 1) „ręcznie”: sumy kwadratów ze średnich
M   <- mean(punkty)
mA  <- tapply(punkty, metoda, mean); mB <- tapply(punkty, sen, mean)
mAB <- tapply(punkty, list(metoda, sen), mean)
SS_A  <- 6 * sum((mA - M)^2)                           # 48
SS_B  <- 6 * sum((mB - M)^2)                           # 48
SS_AB <- 3 * sum((mAB - outer(mA, mB, "+") + M)^2)     # 12
SS_E  <- sum((punkty - ave(punkty, metoda, sen))^2)    # 8
c(F_A = SS_A, F_B = SS_B, F_AB = SS_AB) / (SS_E / 8)

# 2) gotową funkcją + cząstkowe eta kwadrat
model <- aov(punkty ~ metoda * sen)
summary(model)
effectsize::eta_squared(model, partial = TRUE)
Wynik w konsoli R:
 F_A  F_B F_AB
  48   48   12
            Df Sum Sq Mean Sq F value   Pr(>F)
metoda       1     48      48      48 0.000121 ***
sen          1     48      48      48 0.000121 ***
metoda:sen   1     12      12      12 0.008516 **
Residuals    8      8       1
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
# Effect Size for ANOVA (Type I)

Parameter  | Eta2 (partial) |       95% CI
------------------------------------------
metoda     |           0.86 | [0.61, 1.00]
sen        |           0.86 | [0.61, 1.00]
metoda:sen |           0.60 | [0.16, 1.00]

- One-sided CIs: upper bound fixed at [1.00].
Przy równych liczebnościach komórek typy sum kwadratów I, II i III dają ten sam wynik. Przy nierównych liczebnościach aov() liczy typ I, zależny od kolejności czynników. Użyj wtedy car::Anova() z typem II albo z typem III i kontrastami contr.sum.
Co zrobić, gdy interakcja jest istotna?
Istotna interakcja znaczy, że na pytanie „czy quizy pomagają?” odpowiedź brzmi „to zależy od snu”. Zrób wtedy analizę efektów prostych: porównaj metody osobno przy każdym poziomie snu (np. emmeans(model, pairwise ~ metoda | sen)), z korektą na wielokrotne porównania przy wielu parach (test Tukeya). Efekt główny opisuj tylko jako średnią z obu poziomów drugiego czynnika.
Najczęstsze błędy
- Stosowanie dwuczynnikowej ANOVA do czterech grup, które nie tworzą układu dwóch skrzyżowanych czynników.
- Opisywanie samych efektów głównych przy istotnej interakcji.
- Liczenie
aov()przy nierównych komórkach bez świadomości, że wynik zależy od kolejności czynników. - Pisanie, że „rozkładają się wariancje” – rozkładają się sumy kwadratów.
- Brak wykresu interakcji i η²p w opisie wyników.
Bibliografia
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge.
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- Słownik wzorówJednoczynnikowa ANOVA
- Słownik wzorówEta kwadrat (η²)
- Słownik wzorówKontrasty w ANOVA
- PoradnikANOVA – przykład
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportAnaliza wariancji
Przygotowujesz artykuł, doktorat lub grant?
Zaplanujemy i wykonamy analizy, przygotujemy raport z tabelami, wykresami i kodem R oraz pomożemy odpowiedzieć na uwagi recenzentów dotyczące statystyki.