

Badania ankietowe – metoda, dobór próby i typowe błędy
Badania ankietowe to zbieranie danych od wielu osób za pomocą tego samego zestawu pytań, dziś najczęściej przez internet. Typowe pytanie z pracy dyplomowej: jak opisać metodę badań w rozdziale metodologicznym i na ile wyniki ankiety rozesłanej na Facebooku można uogólniać?
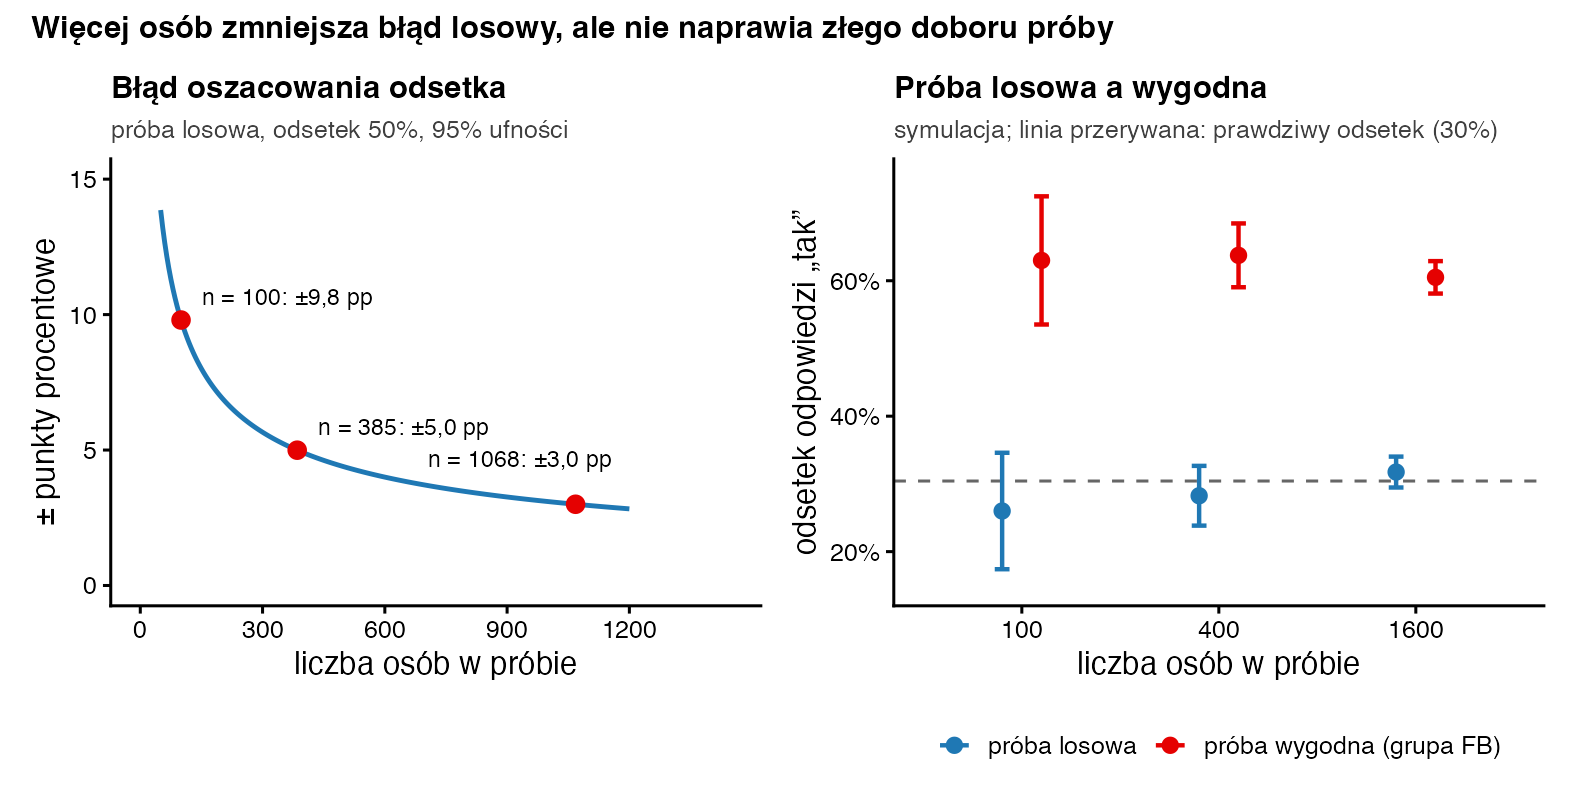
W prostych słowachAnkieta jest tania i szybka, ale mierzy to, co ludzie deklarują, a nie to, co robią. Większa liczba osób zmniejsza błąd losowy, lecz nie naprawia złego doboru: 4000 odpowiedzi z jednej grupy na Facebooku wciąż mówi głównie o tej grupie.
Metoda, technika i narzędzie badawcze
W pracach z pedagogiki, nauk o zdrowiu czy zarządzania promotorzy często oczekują rozróżnienia trzech pojęć:
| Pojęcie | Co to jest | Przykład |
|---|---|---|
| metoda | ogólny sposób zdobywania wiedzy | sondaż diagnostyczny |
| technika | sposób zbierania danych | ankieta internetowa (CAWI), audytoryjna albo papierowa |
| narzędzie | konkretny instrument | kwestionariusz ankiety własnego autorstwa, standaryzowana skala |
Wzór opisu do pracy: W badaniu zastosowano metodę sondażu diagnostycznego z techniką ankiety internetowej. Narzędziem był kwestionariusz własnego autorstwa (12 pytań) oraz skala do pomiaru stresu. Badanie przeprowadzono w marcu na próbie 120 studentów dobranych w sposób wygodny.
Zalety i ograniczenia ankiety
- Zalety: wiele osób niskim kosztem, anonimowość sprzyjająca szczerości, te same pytania dla wszystkich (łatwe porównania), dane od razu w pliku, np. z Formularzy Google.
- Ograniczenia: deklaracje zamiast zachowań, brak możliwości dopytania, niski odsetek odpowiedzi i samoselekcja, zmęczenie długą ankietą, pytania źle zrozumiane przez część osób.
Narzędzia do zbierania odpowiedzi porównujemy we wpisie gdzie zrobić ankietę, a budowę kwestionariusza – we wpisie jak przygotować ankietę.
Dobór próby: losowy czy wygodny?
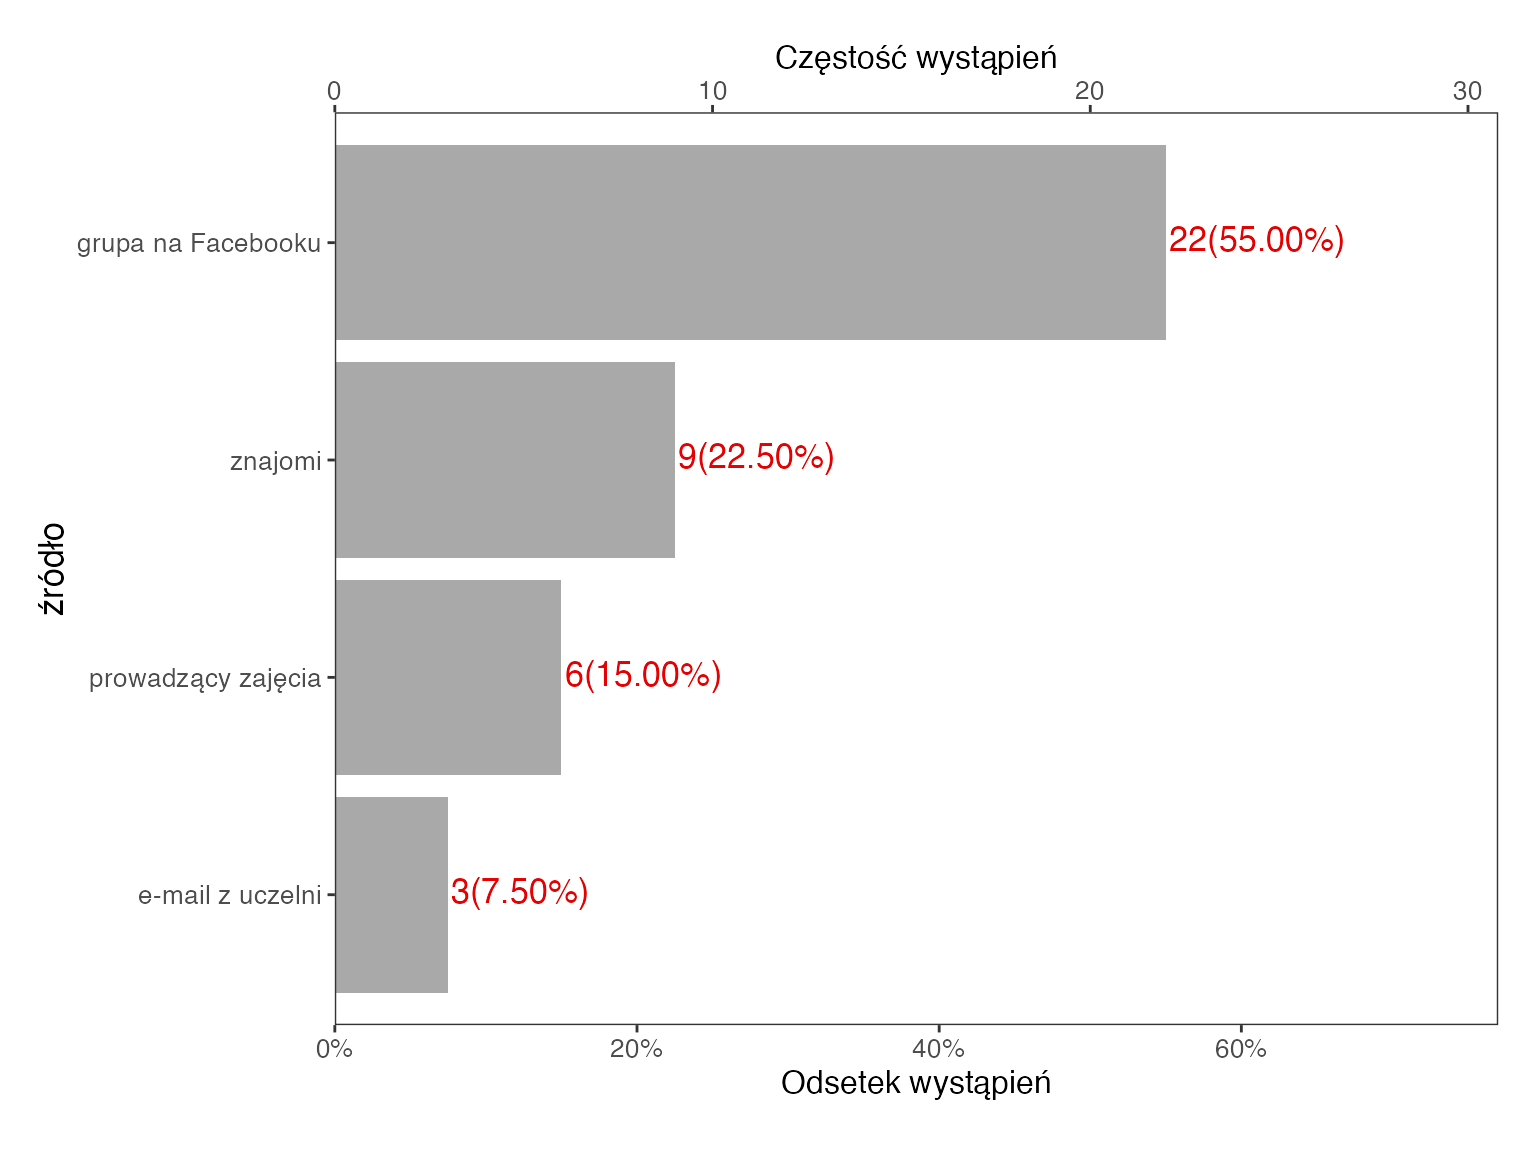
W doborze losowym każda osoba z populacji ma znaną, niezerową szansę trafienia do badania (Babbie, 2008). Tylko wtedy wolno liczyć błąd oszacowania i uogólniać wyniki. W pracach dyplomowych zwykle stosuje się dobór wygodny: ankieta na grupie studenckiej, wśród znajomych, metodą kuli śnieżnej. To nie dyskwalifikuje pracy, ale trzeba to napisać w ograniczeniach i dokładnie opisać próbę. W ankietach internetowych osoby same decydują o udziale, co łatwo zniekształca wyniki (Bethlehem, 2010). Dlatego warto zapytać: „Skąd dowiedziałeś(-aś) się o ankiecie?”.
Błąd oszacowania – ile osób zbadać?
Jeśli 50 ze 100 losowo wybranych osób odpowiada „tak”, 95% przedział ufności dla odsetka w populacji wynosi od 40,2% do 59,8% (±9,8 punktu procentowego). W praktyce „50%” znaczy więc „mniej więcej od 40% do 60%” – i to tylko przy doborze losowym. Żeby przy odsetku bliskim 50% zawęzić błąd do ±5 punktów, potrzeba 385 osób, a do ±3 punktów – 1068. Błąd maleje wolno: aby go zmniejszyć o połowę, potrzebujesz czterech razy więcej osób. Przy skrajnych odsetkach, np. 5%, lepszy jest przedział Wilsona (1927). Samą ideę przedziału ufności (na przykładzie średniej) pokazujemy w haśle przedział ufności dla średniej.
Efekt aprobaty społecznej i inne błędy odpowiedzi
Przy drażliwych pytaniach – o ściąganie, alkohol czy czas nauki – ludzie odpowiadają tak, jak „wypada”. To efekt aprobaty społecznej (Tourangeau i Yan, 2007). Pomagają anonimowość, neutralne sformułowania i pytania o konkretne zachowania zamiast ogólnych ocen. Inne pułapki to pytania sugerujące („Czy zgadzasz się, że zajęcia były zbyt trudne?”), skłonność do zgadzania się z każdym twierdzeniem oraz braki odpowiedzi pod koniec długiej ankiety (Dillman i in., 2014).
Jak analizować wyniki badania ankietowego?
- Przygotowanie danych: kodowanie odpowiedzi, braki, rekodowanie pytań odwróconych – krok po kroku we wpisie jak opracować wyniki ankiety.
- Rzetelność skal: alfa Cronbacha – przykład.
- Opis próby i częstości odpowiedzi, potem testy hipotez, np. test chi-kwadrat.
- Opis w pracy: jak opisać wyniki ankiety.
Jeśli wolisz zlecić analizę, zobacz opracowanie wyników ankiety.
Jak policzyć błąd oszacowania w R?
# 1) błąd oszacowania: 50 ze 100 losowo wybranych osób odpowiada „tak”
x <- 50; n <- 100; p <- x / n
se <- sqrt(p * (1 - p) / n)                       # błąd standardowy odsetka
round(100 * (p + c(-1, 1) * qnorm(0.975) * se), 1) # 95% CI w procentach (przybliżenie normalne)
round(100 * as.numeric(prop.test(x, n, correct = FALSE)$conf.int), 1)   # 95% CI Wilsona

# 2) błąd oszacowania (w punktach procentowych) przy 100, 400 i 1000 osobach
round(100 * qnorm(0.975) * sqrt(0.25 / c(100, 400, 1000)), 1)
# ile osób, żeby błąd oszacowania wynosił ±5 albo ±3 punkty procentowe?
ceiling(qnorm(0.975)^2 * 0.5 * 0.5 / c(0.05, 0.03)^2)

# 3) próba wygodna: większa liczba osób nie usuwa błędu doboru
set.seed(2026)
fb      <- rbinom(5000, 1, 0.60)                  # członkowie grupy na Facebooku: 60% „tak”
inni    <- rbinom(15000, 1, 0.20)                 # pozostali studenci: 20% „tak”
wszyscy <- c(fb, inni)                            # cała populacja: ok. 30% „tak”
round(100 * c(populacja = mean(wszyscy), losowa_400 = mean(sample(wszyscy, 400)),
              wygodna_400 = mean(sample(fb, 400)), wygodna_4000 = mean(sample(fb, 4000))), 1)
Wynik w konsoli R:
[1] 40.2 59.8
[1] 40.4 59.6
[1] 9.8 4.9 3.1
[1]  385 1068
   populacja   losowa_400  wygodna_400 wygodna_4000
        30.4         27.5         61.3         60.4
Czy ankieta z Facebooka wystarczy do pracy magisterskiej?
Zwykle tak, jeśli rzetelnie opiszesz dobór i nie uogólniasz wyników na wszystkich. Pisz „w badanej grupie”, a nie „studenci w Polsce”. Przygotuj tabelę opisu próby (płeć, wiek, kierunek) i, jeśli to możliwe, porównaj ją z danymi o populacji, np. ze statystyk uczelni.
Najczęstsze błędy
- Uogólnianie wyników próby wygodnej na całą populację.
- Podawanie „błędu statystycznego ±5%” dla próby, która nie była losowa.
- Pytania sugerujące i podwójne, np. „Czy zajęcia były ciekawe i przydatne?”.
- Brak pilotażu kwestionariusza na kilku osobach.
- Liczenie średnich z pojedynczych pytań porządkowych bez uzasadnienia.
Bibliografia
- Babbie, E. (2008). Podstawy badań społecznych. Wydawnictwo Naukowe PWN.
- Dillman, D. A., Smyth, J. D., & Christian, L. M. (2014). Internet, phone, mail, and mixed-mode surveys: The tailored design method (4th ed.). Wiley.
- Bethlehem, J. (2010). Selection bias in web surveys. International Statistical Review, 78(2), 161–188. https://doi.org/10.1111/j.1751-5823.2010.00112.x
- Tourangeau, R., & Yan, T. (2007). Sensitive questions in surveys. Psychological Bulletin, 133(5), 859–883. https://doi.org/10.1037/0033-2909.133.5.859
- Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(158), 209–212. https://doi.org/10.1080/01621459.1927.10502953
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikOpracowanie wyników ankiety
- PoradnikJak opracować wyniki ankiety krok po kroku
- PoradnikJak opisać wyniki ankiety w pracy magisterskiej
- Słownik wzorówCzęstości i procenty
- Słownik wzorówAlfa Cronbacha
- Słownik wzorówTest chi-kwadrat
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.