

Rodzaje badań statystycznych – pełne i częściowe
Badania statystyczne dzielimy przede wszystkim według tego, ile jednostek zbiorowości obejmują: wszystkie (badania pełne) albo tylko część (badania częściowe). Typowe pytanie z pracy dyplomowej: jakim rodzajem badania jest moja ankieta i czy mogę uogólnić jej wyniki?
W prostych słowachBadanie pełne to zbadanie wszystkich, jak w spisie powszechnym. Badanie częściowe to zbadanie tylko części osób. Wnioski o całej grupie wyciągasz ze znaną niepewnością tylko wtedy, gdy tę część wylosowano. Gdy odpowiedział, kto chciał, opisujesz przede wszystkim tych, którzy odpowiedzieli.
Rodzaje badań statystycznych w jednej tabeli
| Rodzaj badania | Kogo obejmuje | Przykład | Czy wynik można uogólnić na zbiorowość? |
|---|---|---|---|
| pełne: spis powszechny | wszystkie jednostki w danym momencie | Narodowy Spis Powszechny 2021 | nie trzeba – znasz całą zbiorowość |
| pełne: rejestracja bieżąca | wszystkie zdarzenia zapisywane na bieżąco | urodzenia, zgony, rejestr studentów | nie trzeba |
| pełne: sprawozdawczość | wszystkie jednostki składające sprawozdania | sprawozdania firm dla GUS | nie trzeba |
| częściowe: reprezentacyjne | próba wylosowana ze zbiorowości | Badanie Aktywności Ekonomicznej Ludności | tak, ze znanym błędem (przedział ufności) |
| częściowe: monograficzne | jedna jednostka lub grupa opisana dogłębnie | jedna szkoła, jedna firma | nie – to opis przypadku |
| częściowe: ankietowe | osoby, które oddały ankietę | ankieta internetowa do pracy dyplomowej | tylko ostrożnie, zwykle nie |
| częściowe: szacunek | wartości wyliczone z innych danych | liczba ludności w latach między spisami | zależy od jakości założeń |
Badania dzieli się też według czasu: na ciągłe (prowadzone na bieżąco, jak rejestracja urodzeń), okresowe (powtarzane, jak spis zwykle co 10 lat) i doraźne (jednorazowe, jak większość prac dyplomowych). Pojęcia zbiorowości, jednostki i cechy wyjaśniamy we wpisie badanie statystyczne.
Badania statystyczne częściowe – co to jest i jakie mają rodzaje?
Badanie częściowe obejmuje część jednostek zbiorowości, czyli próbę. Nie chodzi w nim o „wybrane aspekty problemu” ani o wybrane zmienne. Jest tańsze i szybsze niż badanie pełne, ale wynik z próby różni się od prawdziwej wartości w zbiorowości. Część tej różnicy to błąd losowy, który da się oszacować (pomaga w tym centralne twierdzenie graniczne). Druga część to obciążenie, czyli błąd systematyczny wynikający ze złego doboru – tego żaden wzór nie naprawi.
Tylko badanie reprezentacyjne, w którym jednostki do próby się losuje, pozwala uogólnić wynik na zbiorowość ze znanym błędem (Cochran, 1977). Losować można prosto (każdy ma tę samą szansę), warstwowo (osobno w podgrupach, np. trybach studiów), systematycznie (co k-tą osobę z listy) albo zespołowo (całe grupy ćwiczeniowe). Badanie monograficzne opisuje dogłębnie jedną jednostkę. Badanie ankietowe obejmuje tych, którzy oddali ankietę. Szacunek wylicza brakujące wartości z innych danych.
Przykład: losowanie proste, warstwowe i dobór celowy
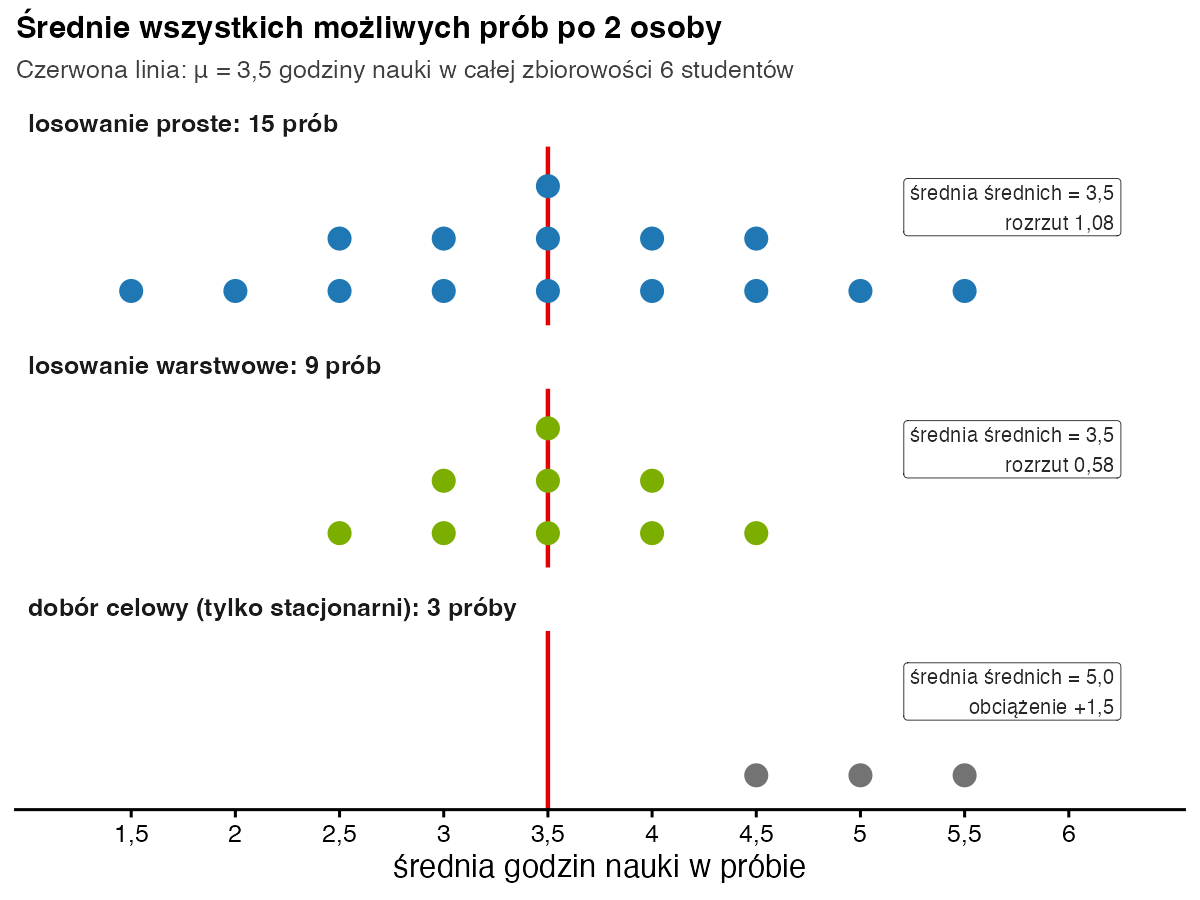
Zbiorowość to sześcioro studentów kierunku. Troje stacjonarnych uczyło się do kolokwium 4, 5 i 6 godzin, troje niestacjonarnych – 1, 2 i 3 godziny. Średnia w zbiorowości wynosi μ = 3,5 godziny. Badamy tylko dwie osoby i sprawdzamy wszystkie możliwe próby przy trzech sposobach doboru.
| Sposób doboru | Możliwe próby | Średnia średnich | Rozrzut średnich (SD) | Obciążenie |
|---|---|---|---|---|
| losowanie proste | 15 | 3,50 | 1,08 | 0 |
| losowanie warstwowe (1 + 1) | 9 | 3,50 | 0,58 | 0 |
| dobór celowy (tylko stacjonarni) | 3 | 5,00 | 0,41 | +1,50 |
Oba losowania są nieobciążone: średnio trafiają w μ. Losowanie warstwowe jest jednak prawie dwa razy dokładniejsze, bo zawsze bierze po jednej osobie z każdego trybu. Dobór celowy, np. ankieta rozdana na porannym wykładzie dla stacjonarnych, ma najmniejszy rozrzut, a mimo to zawsze zawyża wynik – średnio o 1,5 godziny. Mały rozrzut nie chroni przed błędem systematycznym.
# Zbiorowość: 6 studentów kierunku, cecha: godziny nauki do kolokwium, warstwy: tryb studiów
godziny <- c(4, 5, 6, 1, 2, 3)
tryb <- rep(c("stacjonarne", "niestacjonarne"), each = 3)
mean(godziny)                                     # parametr μ = 3,5

# Jak wylosować próbę 2 osób w R?
set.seed(1)
sample(godziny, 2)                                # losowanie proste
sapply(split(godziny, tryb), sample, size = 1)    # losowanie warstwowe: 1 osoba z każdego trybu

# Wszystkie możliwe próby i ich średnie
prosta    <- combn(godziny, 2, mean)
warstwowa <- as.vector(outer(godziny[1:3], godziny[4:6], "+") / 2)
celowa    <- combn(godziny[1:3], 2, mean)         # tylko stacjonarni (np. ankieta na wykładzie)
sapply(list(prosta = prosta, warstwowa = warstwowa, celowa = celowa), function(m)
  round(c(prob = length(m), srednia = mean(m), rozrzut = sqrt(mean((m - mean(m))^2)),
          obciazenie = mean(m) - mean(godziny)), 2))

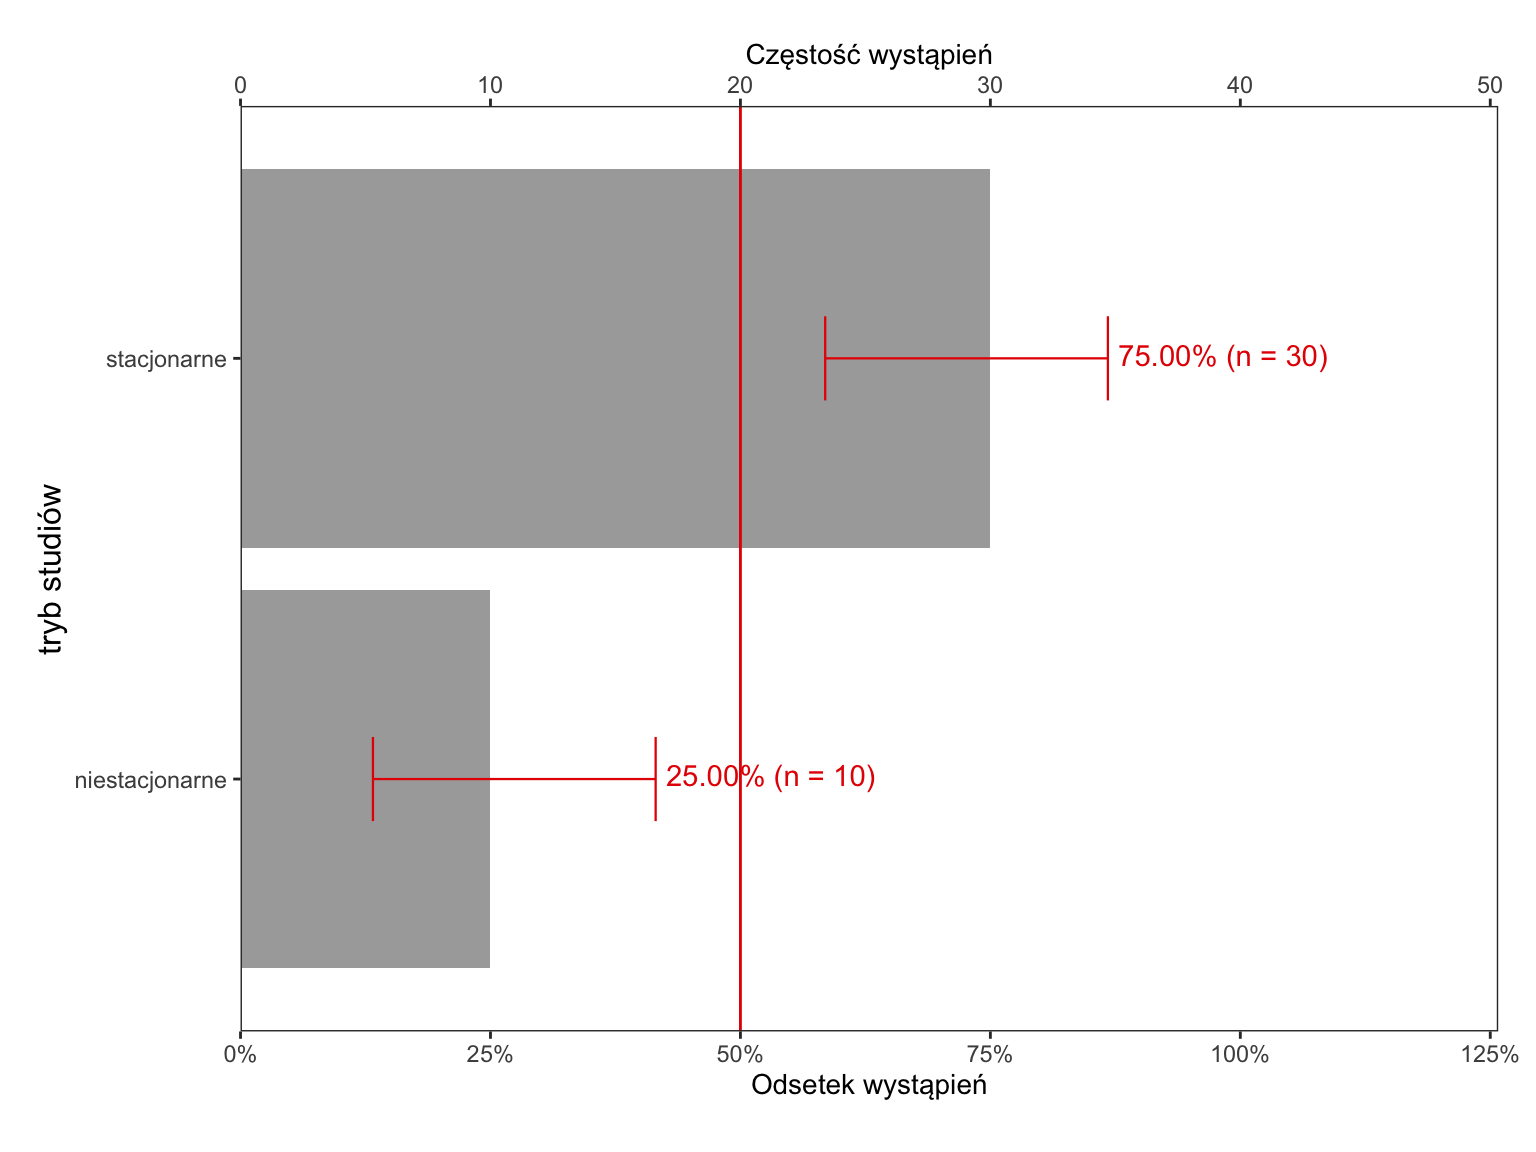
# Ankieta internetowa: 30 stacjonarnych i 10 niestacjonarnych, a na kierunku jest pół na pół
chisq.test(c(30, 10), p = c(0.5, 0.5))
Wynik w konsoli R:
[1] 3.5
[1] 4 1
niestacjonarne    stacjonarne
             3              4
           prosta warstwowa celowa
prob        15.00      9.00   3.00
srednia      3.50      3.50   5.00
rozrzut      1.08      0.58   0.41
obciazenie   0.00      0.00   1.50

	Chi-squared test for given probabilities

data:  c(30, 10)
X-squared = 10, df = 1, p-value = 0.001565
Czy ankieta w internecie to badanie reprezentacyjne?
Zwykle nie. Załóżmy, że na kierunku połowa studentów studiuje stacjonarnie, a ankietę z grupy w mediach społecznościowych wypełniło 30 stacjonarnych i 10 niestacjonarnych. Test zgodności chi-kwadrat pokazuje, że tak nierówna struktura rzadko wychodziłaby przypadkiem, gdyby obie grupy odpowiadały równie chętnie: χ²(1) = 10,00; p = 0,002 (Rys. 2). Stacjonarni są nadreprezentowani, więc średnia godzin nauki z ankiety będzie zawyżona. Z drugiej strony nawet zgodna struktura w jednej cesze nie czyni próby reprezentatywną, bo osoby, które same się zgłosiły, mogą różnić się w innych cechach. Więcej o tej metodzie przeczytasz w poradniku badania ankietowe, a o doborze osób i liczebności próby – we wpisie etapy badania statystycznego.
Plany badań: eksperyment, badanie korelacyjne i porównawcze
Podział na badania eksperymentalne, korelacyjne i porównawcze to podział planów badawczych z metodologii, a nie rodzajów badań statystycznych. Ma jednak znaczenie dla wniosków. Tylko w eksperymencie, w którym badacz losowo przydziela osoby do warunków, różnicę między grupami można przypisać badanemu czynnikowi (Shadish i in., 2002). Porównanie grup, które już istnieją, np. studentów stacjonarnych i niestacjonarnych, pokazuje różnicę, ale nie jej przyczynę: grupy mogą się różnić np. wiekiem albo pracą zawodową. Czym różni się opis wyniku po losowym przydziale do grup od opisu porównania grup, które same się wybrały, pokazujemy we wpisie test t Studenta – przykład (tam studentów przydzielono losowo).
Najczęstsze błędy
- Definiowanie badania częściowego jako badania „wybranych aspektów problemu”. To badanie części jednostek zbiorowości.
- Nazywanie ankiety z mediów społecznościowych badaniem reprezentacyjnym.
- Wniosek o przyczynie z porównania grup, do których osób nie przydzielono losowo.
- Przekonanie, że duża próba usuwa obciążenie doboru. Zwiększa ona precyzję, a błąd systematyczny zostaje.
Bibliografia
- Cochran, W. G. (1977). Sampling techniques (3rd ed.). John Wiley & Sons.
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Jóźwiak, J., & Podgórski, J. (2009). Statystyka od podstaw. Polskie Wydawnictwo Ekonomiczne.
- Główny Urząd Statystyczny. (b.d.). Pojęcia stosowane w statystyce publicznej. https://stat.gov.pl/metainformacje/slownik-pojec/pojecia-stosowane-w-statystyce-publicznej/
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikAnaliza statystyczna – co to jest
- PoradnikStatystyka dla początkujących
- PoradnikMetody statystyczne – przegląd
- PoradnikStatystyka opisowa – podstawy
- PoradnikTest statystyczny – na czym polega
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.