

Statystyka dla początkujących – od czego zacząć?
Statystyka to sposób opisywania danych liczbami i sprawdzania, na ile wnioski z małej grupy osób można odnieść do większej. Typowe pytanie na początku pracy dyplomowej: które pojęcia muszę rozumieć, zanim policzę pierwszy test?
W prostych słowachNajpierw ustalasz, kogo badasz i jakie masz zmienne. Potem opisujesz dane: gdzie jest środek i jak duży jest rozrzut. Na końcu sprawdzasz, czy to, co widać w Twojej grupie, może dotyczyć także innych ludzi. Każde pojęcie poniżej ma kilka zdań i link do hasła ze wzorem.
Populacja i próba
Populacja to wszyscy, o których chcesz coś powiedzieć, np. wszyscy studenci pierwszego roku. Próba to osoby, które naprawdę zbadałeś, np. 120 studentów z Twojej uczelni. Wnioski z próby wolno przenosić na populację tylko wtedy, gdy próba była dobrze dobrana (więcej: badanie statystyczne – podstawowe pojęcia).
Zmienne i skale pomiaru
Zmienna to cecha, która różni się między osobami. Skala, na której ją mierzysz, decyduje, co wolno policzyć (Stevens, 1946).
| Skala | Przykład | Co możesz policzyć |
|---|---|---|
| nominalna | kierunek studiów, płeć | liczebności, procenty, modę |
| porządkowa | ocena zajęć 1–5, miejsce w rankingu | dodatkowo medianę, kwartyle i testy rangowe |
| ilościowa (przedziałowa lub ilorazowa) | godziny snu, punkty z kolokwium | dodatkowo średnią, odchylenie standardowe i testy parametryczne |
Zmienna, którą wyjaśniasz (np. punkty), to zmienna zależna. Zmienna, według której dzielisz osoby albo którą przewidujesz wynik (np. metoda nauki), to zmienna niezależna.
Średnia, mediana i odchylenie standardowe
Pięcioro studentów spało przed kolokwium 6, 2, 7, 4 i 6 godzin.
- Średnia to suma podzielona przez liczbę osób: 25 / 5 = 5 godzin (średnia arytmetyczna).
- Mediana to środkowy wynik po ustawieniu danych od najmniejszego: 2, 4, 6, 6, 7, czyli 6 godzin (mediana).
- Odchylenie standardowe mówi, o ile typowo wyniki odbiegają od średniej. Tu SD = 2 godziny (odchylenie standardowe).
Średnia jest niższa od mediany, bo jedna osoba spała tylko 2 godziny i „ciągnie” średnią w dół. Przy skośnych danych podawaj obie miary.
Test statystyczny i wartość p
Test sprawdza, czy wynik z próby da się rozsądnie wytłumaczyć przypadkiem. Zaczynasz od hipotezy zerowej H0, np. „studenci śpią średnio 7 godzin”. Wartość p to prawdopodobieństwo wyniku co najmniej tak odległego od H0, gdyby H0 była prawdziwa – a nie prawdopodobieństwo, że H0 jest prawdziwa (Wasserstein i Lazar, 2016). Więcej: test statystyczny – na czym polega.
Przedział ufności
Średnia z próby to tylko przybliżenie średniej w populacji. 95% przedział ufności pokazuje zakres wartości, które dobrze pasują do Twoich danych. Im mniej osób, tym jest szerszy (przedział ufności dla średniej).
Przykład: wszystkie pojęcia na jednych danych
Czy studenci przed kolokwium śpią średnio inaczej niż 7 godzin? Test t dla jednej próby daje t(4) = −2,24; p = 0,089. To więcej niż 0,05, więc nie ma podstaw do odrzucenia H0. Nie znaczy to, że studenci śpią 7 godzin: przedział ufności obejmuje zarówno 7 godzin, jak i 3. Pięć osób to po prostu za mało, żeby to rozstrzygnąć.
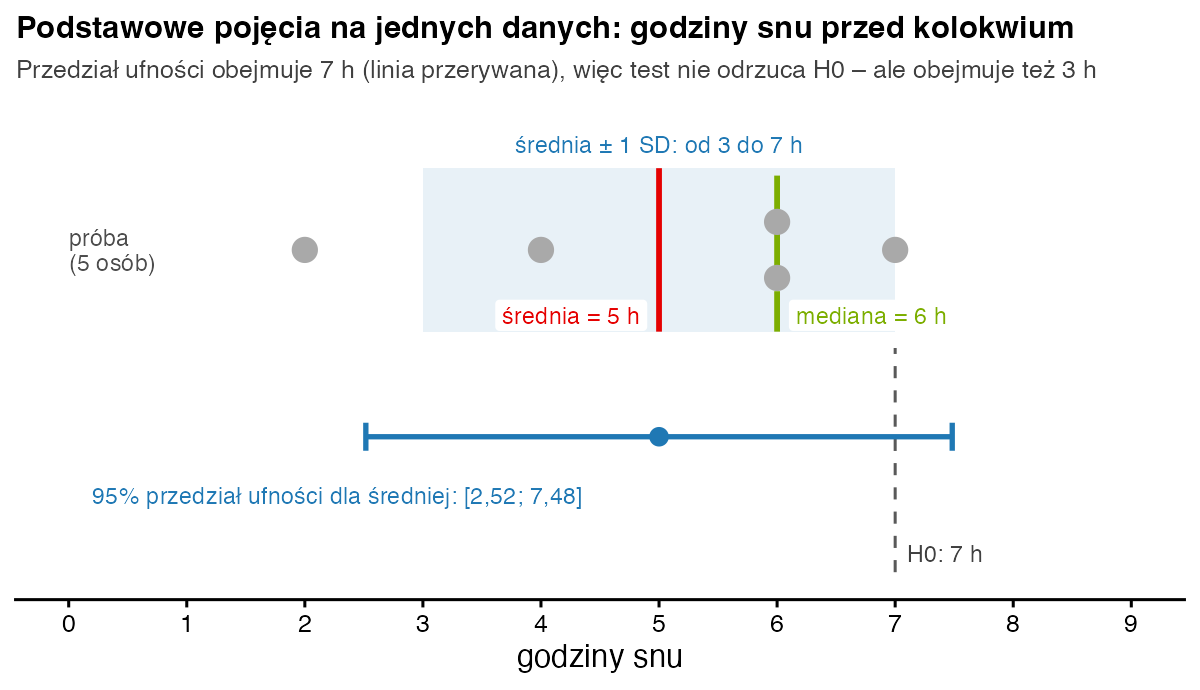
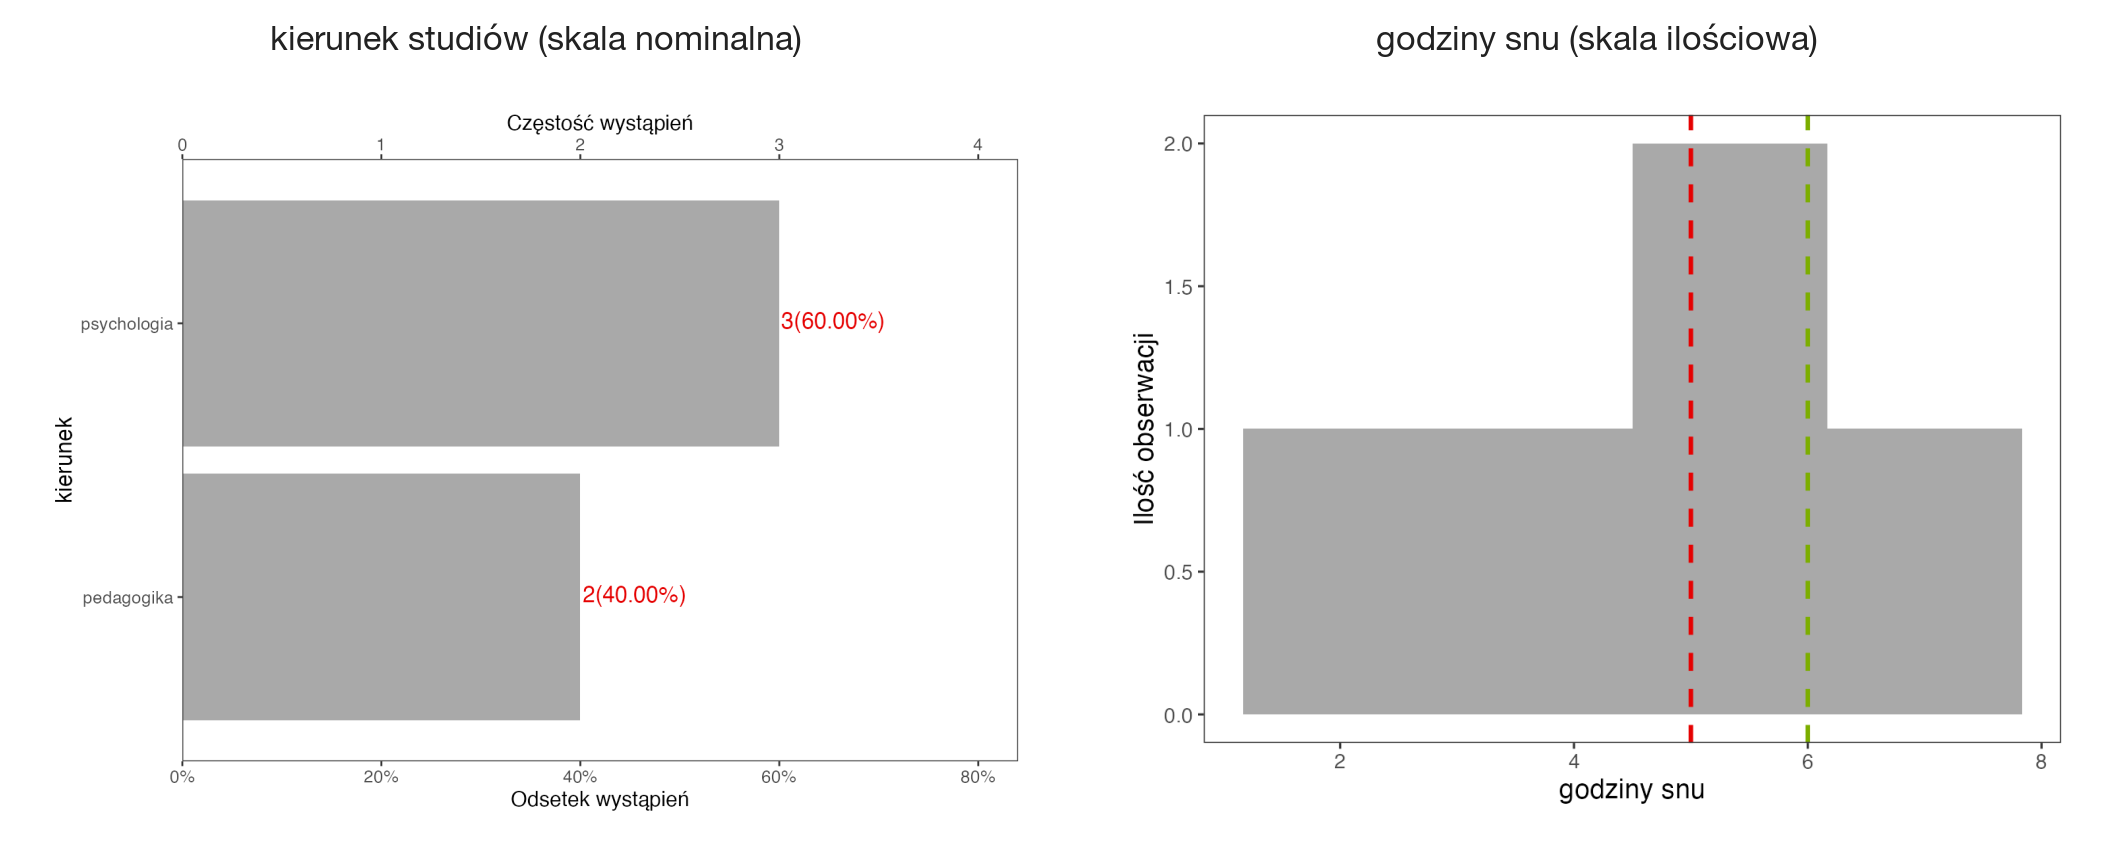
Zapis w stylu APA: Studenci spali przed kolokwium średnio 5,00 godziny (SD = 2,00; Me = 6,00). Średni czas snu nie różnił się istotnie od 7 godzin, t(4) = −2,24; p = 0,089; 95% CI [2,52; 7,48].
Jak policzyć podstawowe statystyki w R?
# godziny snu przed kolokwium – 5 studentów
sen <- c(6, 2, 7, 4, 6)

# 1) zmienna ilościowa: środek i rozrzut
c(srednia = mean(sen), mediana = median(sen), SD = sd(sen))

# 2) zmienna nominalna: liczebności i procenty
kierunek <- c("psychologia", "pedagogika", "psychologia", "psychologia", "pedagogika")
table(kierunek)
100 * prop.table(table(kierunek))

# 3) test i przedział ufności: czy średni sen różni się od 7 godzin?
t.test(sen, mu = 7)
Wynik w konsoli R:
srednia mediana      SD
      5       6       2
kierunek
 pedagogika psychologia
          2           3
kierunek
 pedagogika psychologia
         40          60

	One Sample t-test

data:  sen
t = -2.2361, df = 4, p-value = 0.08901
alternative hypothesis: true mean is not equal to 7
95 percent confidence interval:
 2.516672 7.483328
sample estimates:
mean of x
        5
Od czego zacząć naukę statystyki?
- Opis danych – miary i wykresy: statystyka opisowa.
- Logika testu – hipotezy, p, błędy: istotność statystyczna.
- Porównania grup – test t krok po kroku.
- Związki zmiennych – korelacja Pearsona – przykład.
- Dobór metody – mapa analiz: metody statystyczne.
Czy da się nauczyć statystyki od podstaw bez matematyki?
Tak. Na poziomie pracy dyplomowej wystarczą cztery działania i pierwiastek. Ważniejsze od rachunków jest rozumienie, co znaczy wynik: program policzy każdy test, ale nie powie, czy był właściwy. Zacznij od pięciu liczb, policz wszystko ręcznie, a potem sprawdź w R.
Najczęstsze błędy
- Liczenie średniej dla zmiennej nominalnej, np. „średni kierunek studiów”.
- Podawanie średniej bez odchylenia standardowego.
- Traktowanie p jako prawdopodobieństwa, że H0 jest prawdziwa.
- Pisanie „przyjęto H0” przy p > 0,05 zamiast „brak podstaw do odrzucenia H0”.
- Uogólnianie wyników z grupy znajomych na wszystkich studentów.
Bibliografia
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108
- Field, A., Miles, J., & Field, Z. (2012). Discovering statistics using R. SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikStatystyka opisowa – podstawy
- PoradnikTest statystyczny – na czym polega
- Słownik wzorówIstotność statystyczna i wartość p
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- PoradnikAnaliza statystyczna – co to jest
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.