

Statystyka opisowa – czym jest i które miary wybrać
Statystyka opisowa streszcza dane z próby kilkoma liczbami, tabelami i wykresami: gdzie leży typowy wynik, jak bardzo wyniki się różnią, jaki kształt ma rozkład i jak często występują kategorie. Typowe pytanie z pracy dyplomowej: jakie miary podać dla płci, wieku, pytań ankiety i wyników skali?
W prostych słowachStatystyka opisowa odpowiada na pytanie „jak wyglądają moje dane?”. Nie mówi nic o osobach, których nie zbadałeś. Dobór miar zależy od rodzaju zmiennej i od kształtu rozkładu – i to jest cała sztuka.
Statystyka opisowa a wnioskowanie statystyczne
Opis dotyczy wyłącznie próby: „8 zbadanych studentów dojeżdża średnio 20 minut”. Wnioskowanie uogólnia wynik na populację i wymaga testu albo przedziału ufności. Dlatego w pracy najpierw opisujesz próbę i zmienne, a dopiero potem weryfikujesz hipotezy. Logikę tej drugiej części tłumaczy wpis test statystyczny.
Cztery grupy miar
- Tendencja centralna – gdzie leży typowy wynik: średnia (M), mediana (Me, środkowy wynik) i moda (wartość najczęstsza).
- Rozproszenie – jak bardzo wyniki się różnią: rozstęp (max − min), odchylenie standardowe (SD), wariancja (SD²) i rozstęp międzykwartylowy, czyli odległość między kwartylami Q1 i Q3.
- Kształt rozkładu – skośność (czy jeden ogon jest dłuższy) i kurtoza (czy często zdarzają się wyniki skrajne).
- Zmienne jakościowe – liczebności i procenty oraz moda.
Błąd standardowy nie jest miarą rozproszenia wyników. Mówi, jak dokładnie znamy średnią, więc należy już do wnioskowania. Wszystkie wzory z jednym przykładem liczbowym zebraliśmy w haśle statystyka opisowa – wzory w pigułce.
Gdy chcesz porównać rozproszenie zmiennych mierzonych w różnych jednostkach, użyj współczynnika zmienności: SD podzielonego przez średnią i wyrażonego w procentach. Ma on sens tylko dla zmiennych z naturalnym zerem, np. czasu czy wagi.
Którą miarę wybrać? Tabela decyzyjna
| Zmienna | Przykład | Typowy wynik | Rozproszenie | Wykres |
|---|---|---|---|---|
| nominalna | płeć, kierunek, środek transportu | moda | n i % w kategoriach | słupkowy |
| porządkowa | pojedyncze pytanie 1–5, wykształcenie | mediana i % w kategoriach | Q1–Q3, min–max | słupkowy |
| ilościowa, rozkład zbliżony do symetrycznego | wynik skali, punkty z testu | średnia | SD, min–max | histogram |
| ilościowa, rozkład skośny lub wyniki odstające | czas dojazdu, dochód, nieobecności | mediana | IQR, min–max | pudełkowy, histogram |
| Kształt rozkładu sprawdzisz skośnością i wykresem. Przy n < 50 podziel skośność przez jej błąd standardowy i porównaj z ±1,96 (Kim, 2013). | ||||
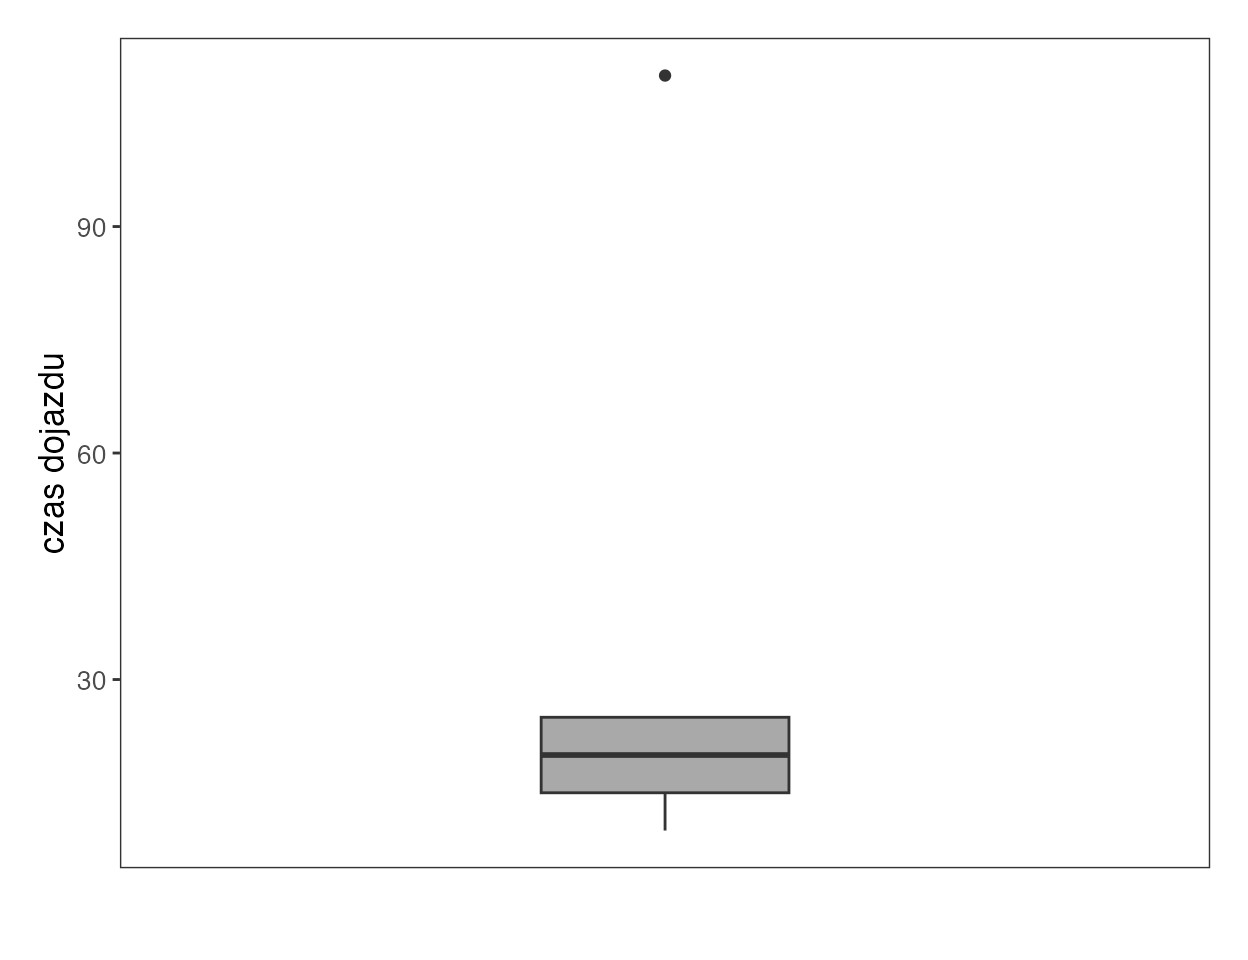
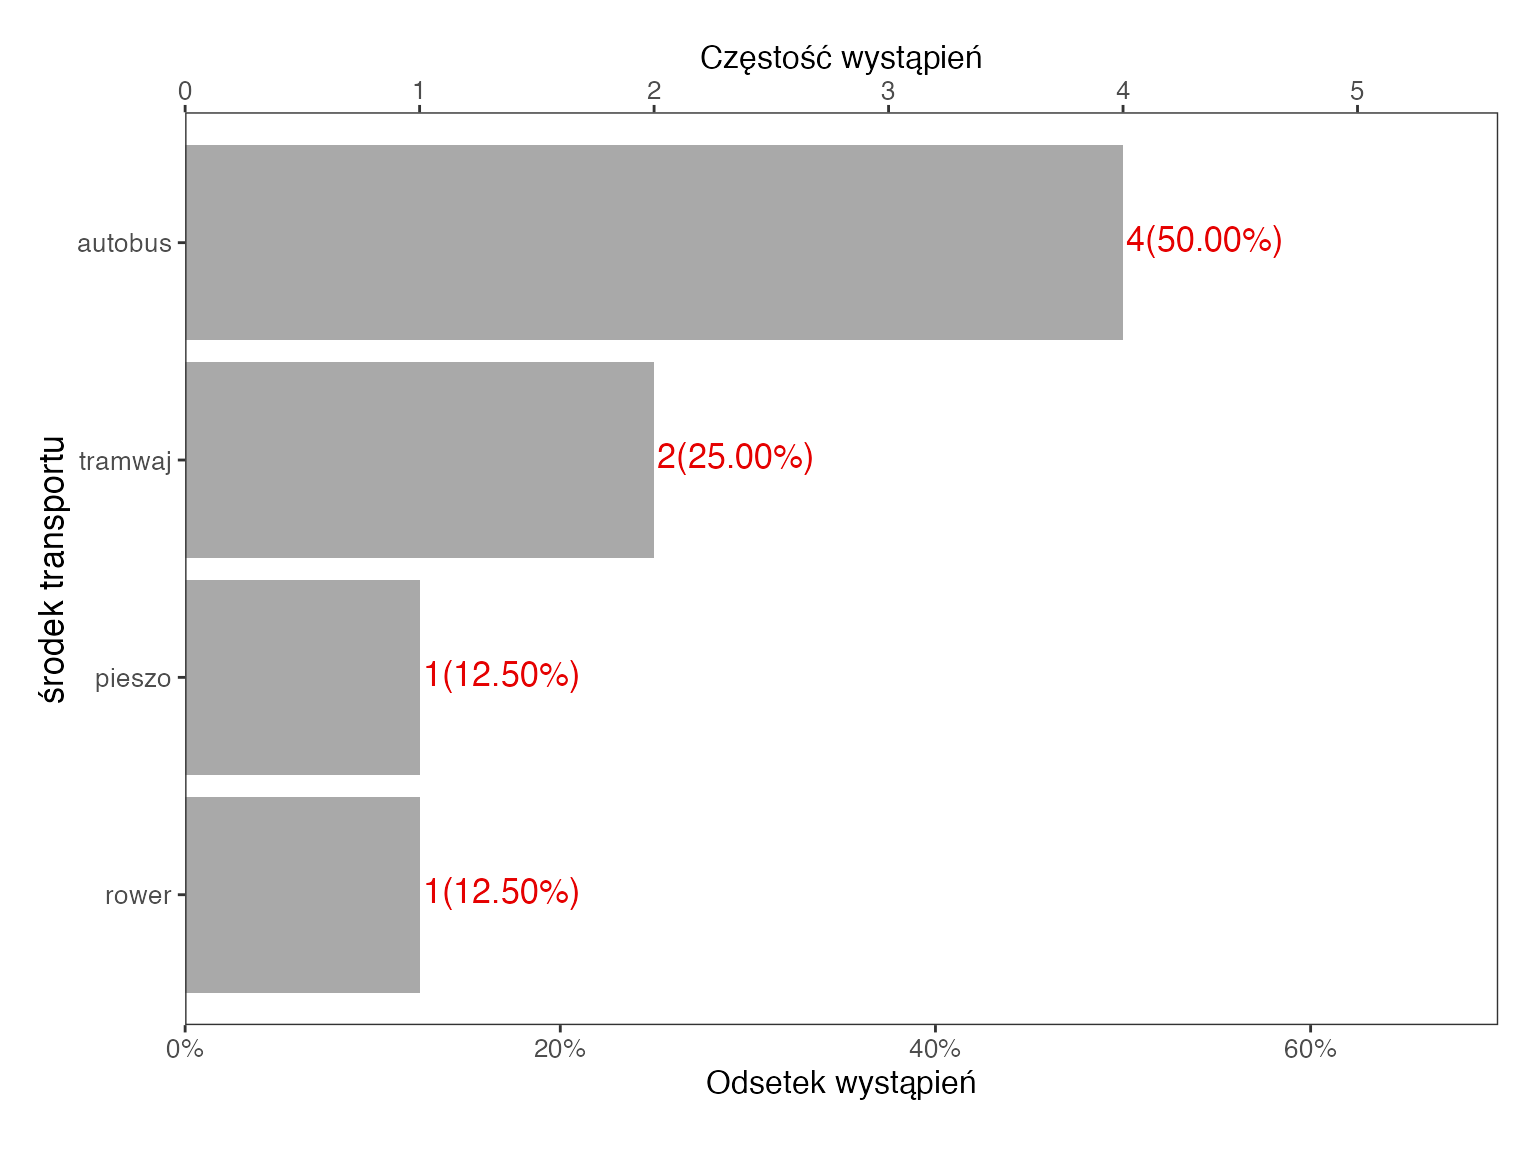
Wykres dobierz do zmiennej tak samo jak miarę. Histogram i wykres pudełkowy pokażą kształt rozkładu i wyniki odstające, a wykres słupkowy – kategorie. Liczby i wykres powinny opowiadać tę samą historię.
Średnia czy mediana? Dwa podejścia na tych samych danych
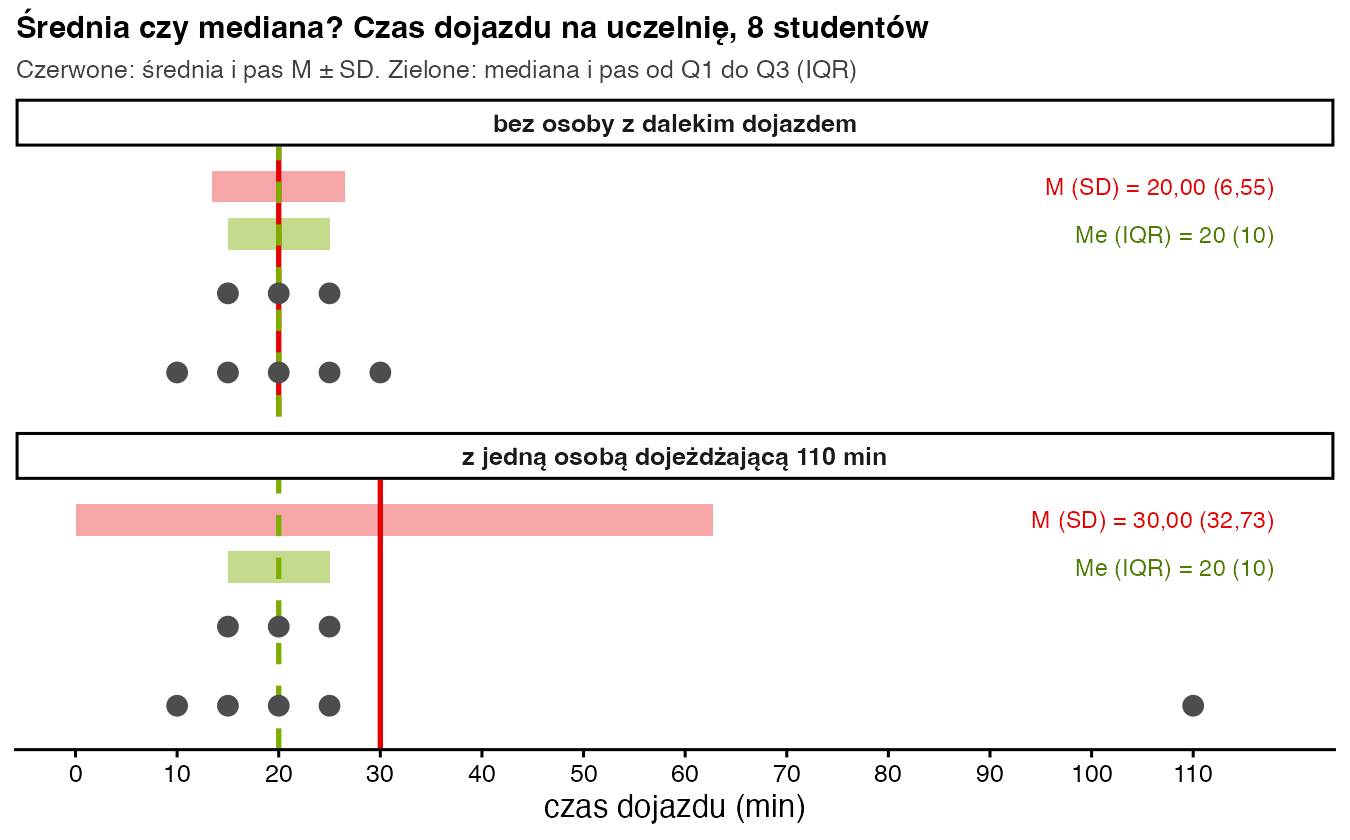
Ośmioro studentów podało czas dojazdu na uczelnię: 10, 15, 15, 20, 20, 25, 25 i 30 minut. Średnia i mediana wynoszą po 20 minut. Teraz zamieńmy ostatnią osobę na kogoś, kto dojeżdża 110 minut z innego miasta.
| Zbiór | M (SD) | Me (IQR) | Skośność |
|---|---|---|---|
| bez osoby z dalekim dojazdem | 20,00 (6,55) | 20 (10) | 0,00 |
| z osobą dojeżdżającą 110 min | 30,00 (32,73) | 20 (10) | 2,69 |
Jedna osoba podniosła średnią o 10 minut, a odchylenie standardowe – pięciokrotnie. Mediana i IQR się nie zmieniły. Średnia 30 minut nie opisuje nikogo: siedem z ośmiu osób dojeżdża krócej. Przy takim rozkładzie raportuj medianę i IQR, a skrajną osobę zostaw w danych, jeśli jej wynik jest prawdziwy. Cały opis kilku zmiennych z tabelą do pracy pokazujemy we wpisie statystyka opisowa – przykład z interpretacją wyników.
Jak opisać statystyki opisowe w pracy?
Zacznij od opisu próby (liczebności i procenty), potem podaj tabelę zmiennych ilościowych: n, M, SD, Me, min–max, a przy wątpliwym kształcie także skośność. W tekście omów tylko to, co ważne dla hipotez, i zaznacz, gdy rozkład wymusza medianę.
Zapis w stylu APA: Połowa badanych (n = 4; 50%) dojeżdżała na uczelnię autobusem. Rozkład czasu dojazdu był prawostronnie skośny (skośność = 2,69) z powodu jednej osoby dojeżdżającej 110 minut, dlatego podano medianę: Me = 20 min (IQR = 10; zakres: 10–110).
Jak policzyć statystyki opisowe w R?
# Czas dojazdu na uczelnię (min) 8 studentów oraz ten sam zbiór, w którym ostatnia osoba dojeżdża 110 min
bez_dalekiego <- c(10, 15, 15, 20, 20, 25, 25, 30)
z_dalekim     <- c(10, 15, 15, 20, 20, 25, 25, 110)

# 1) zmienna ilościowa: dwa podejścia – M (SD) oraz Me (IQR) – i skośność G1
opis <- function(x) c(M = mean(x), SD = sd(x), Me = median(x), IQR = IQR(x),
                      min = min(x), max = max(x), skosnosc = e1071::skewness(x, type = 2))
round(rbind(bez_dalekiego = opis(bez_dalekiego), z_dalekim = opis(z_dalekim)), 2)

# 2) zmienna jakościowa: środek transportu – liczebności, procenty i moda
transport <- c("autobus", "autobus", "tramwaj", "rower", "autobus", "pieszo", "tramwaj", "autobus")
tab <- table(transport)
cbind(n = tab, proc = round(100 * prop.table(tab), 1))
names(which.max(tab))                                   # moda (dominanta)
Wynik w konsoli R:
               M    SD Me IQR min max skosnosc
bez_dalekiego 20  6.55 20  10  10  30     0.00
z_dalekim     30 32.73 20  10  10 110     2.69
        n proc
autobus 4 50.0
pieszo  1 12.5
rower   1 12.5
tramwaj 2 25.0
[1] "autobus"
Funkcja IQR() liczy kwartyle tą samą metodą co funkcja KWARTYL (QUARTILE) w Excelu. SPSS stosuje inną metodę (Hyndman i Fan, 1996), więc w pracy podaj, której użyłeś. Tak wygląda pełny opis próby w raporcie: przykładowy raport SZTOS – opis próby.
Czy w pracy magisterskiej wystarczy statystyka opisowa?
Tylko wtedy, gdy pytania badawcze są czysto opisowe, np. „jak często studenci korzystają z korepetycji?”. Jeśli hipotezy mówią o różnicach między grupami albo o związkach zmiennych, opis jest dopiero pierwszym krokiem, a po nim przychodzi test statystyczny. Jak to zaplanować, opisujemy we wpisie weryfikacja hipotez w pracy magisterskiej.
Najczęstsze błędy
- Średnia dla zmiennej nominalnej, np. „średnia płeć” zakodowana jako 1 i 2.
- Sama średnia przy rozkładzie skośnym, bez mediany i informacji o kształcie rozkładu.
- Błąd standardowy w tabeli zamiast odchylenia standardowego.
- Procenty bez liczebności – „50%” może oznaczać 4 z 8 albo 400 z 800 osób.
- Wnioski o populacji wyciągane z samych statystyk opisowych, bez testu i przedziału ufności.
Bibliografia
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Kim, H.-Y. (2013). Statistical notes for clinical researchers: Assessing normal distribution (2) using skewness and kurtosis. Restorative Dentistry & Endodontics, 38(1), 52–54. https://doi.org/10.5395/rde.2013.38.1.52
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
- Altman, D. G., & Bland, J. M. (2005). Standard deviations and standard errors. BMJ, 331(7521), 903. https://doi.org/10.1136/bmj.331.7521.903
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikStatystyka opisowa – przykład
- Słownik wzorówStatystyka opisowa – wzory w pigułce
- Słownik wzorówOdchylenie standardowe
- Słownik wzorówMediana
- PoradnikAnaliza statystyczna – co to jest
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.