

Prezentacja danych statystycznych – tabele i wykresy
Prezentacja danych statystycznych to pokazanie wyników w tekście, w tabeli albo na wykresie tak, żeby czytelnik zobaczył w nich to samo co Ty – bez przesady i bez ukrywania niewygodnych szczegółów. Typowe pytanie z pracy dyplomowej: jaki wykres wybrać i jak powinna wyglądać tabela w stylu APA?
W prostych słowachTabela służy do dokładnych liczb, wykres – do pokazania kształtu rozkładu, różnicy albo trendu. Rodzaj wykresu wynika z typu zmiennej. Dobry wykres pokazuje dane, a nie tylko średnie, ma podpisane osie i obywa się bez efektów 3D.
Formy prezentacji danych
Dane możesz pokazać na trzy sposoby. Opisowo, w zdaniu: „70% studentów oceniło zajęcia na 4 lub 5” – dobrze przy jednej, dwóch liczbach. Tabelarycznie, gdy czytelnik ma odczytać dokładne wartości, np. średnie i odchylenia w kilku grupach. Graficznie, gdy liczy się wzór: kształt rozkładu, różnica między grupami, związek dwóch zmiennych. W pracy dyplomowej zwykle łączysz wszystkie trzy formy: tabela z liczbami, wykres dla najważniejszego wyniku i zdanie, które go opisuje. Nie powtarzaj jednak tych samych liczb w tabeli i na wykresie.
Jaki wykres wybrać? Dobór do typu zmiennej
| Dane | Wykres | Unikaj | Przykład |
|---|---|---|---|
| jedna zmienna nominalna (kierunek studiów) | słupkowy z procentami, posortowany od największej kategorii | kołowego przy więcej niż 3–4 kategoriach | częstości i procenty |
| jedna zmienna porządkowa (ocena 1–5) | słupkowy w naturalnej kolejności odpowiedzi | sortowania według liczebności i pomijania odpowiedzi bez wskazań | opis wyników ankiety |
| jedna zmienna ilościowa (godziny snu) | histogram, wykres pudełkowy | samej średniej bez rozkładu | statystyka opisowa, kwartyle |
| zmienna ilościowa w 2–3 grupach | pojedyncze wyniki + pudełko lub „skrzypce”, średnia z przedziałem ufności | samego słupka średniej z wąsem | test t, ANOVA |
| dwie zmienne ilościowe | wykres rozrzutu z linią trendu | samego współczynnika bez wykresu | korelacja Pearsona |
| dwie zmienne jakościowe | słupki skumulowane do 100% | kilku wykresów kołowych obok siebie | chi-kwadrat |
Tabela w stylu APA
Tabela w pracy ma numer, tytuł nad tabelą, tylko poziome linie i notę pod spodem (American Psychological Association, 2020). Podawaj tę samą liczbę miejsc po przecinku w kolumnie i wyjaśniaj skróty w nocie. Przykład dla oceny zajęć od 10 studentów:
| Ocena | n | % | % skumulowany |
|---|---|---|---|
| 1 – bardzo źle | 0 | 0 | 0 |
| 2 | 1 | 10 | 10 |
| 3 | 2 | 20 | 30 |
| 4 | 3 | 30 | 60 |
| 5 – bardzo dobrze | 4 | 40 | 100 |
| Razem | 10 | 100 | – |
| Uwaga. M = 4,00; Me = 4; najczęstsza ocena: 5. | |||
W tekście wystarczy jedno zdanie, które przywołuje tabelę i mówi, co z niej wynika:
Zapis w stylu APA: Większość studentów (70%) oceniła zajęcia na 4 lub 5, a najczęstszą oceną było 5 (Tabela 2). Mediana ocen wyniosła 4.
Tak wygląda gotowa tabela opisu próby w raporcie do artykułu: przykładowa tabela SZTOS.
Najczęstsze błędy na wykresach
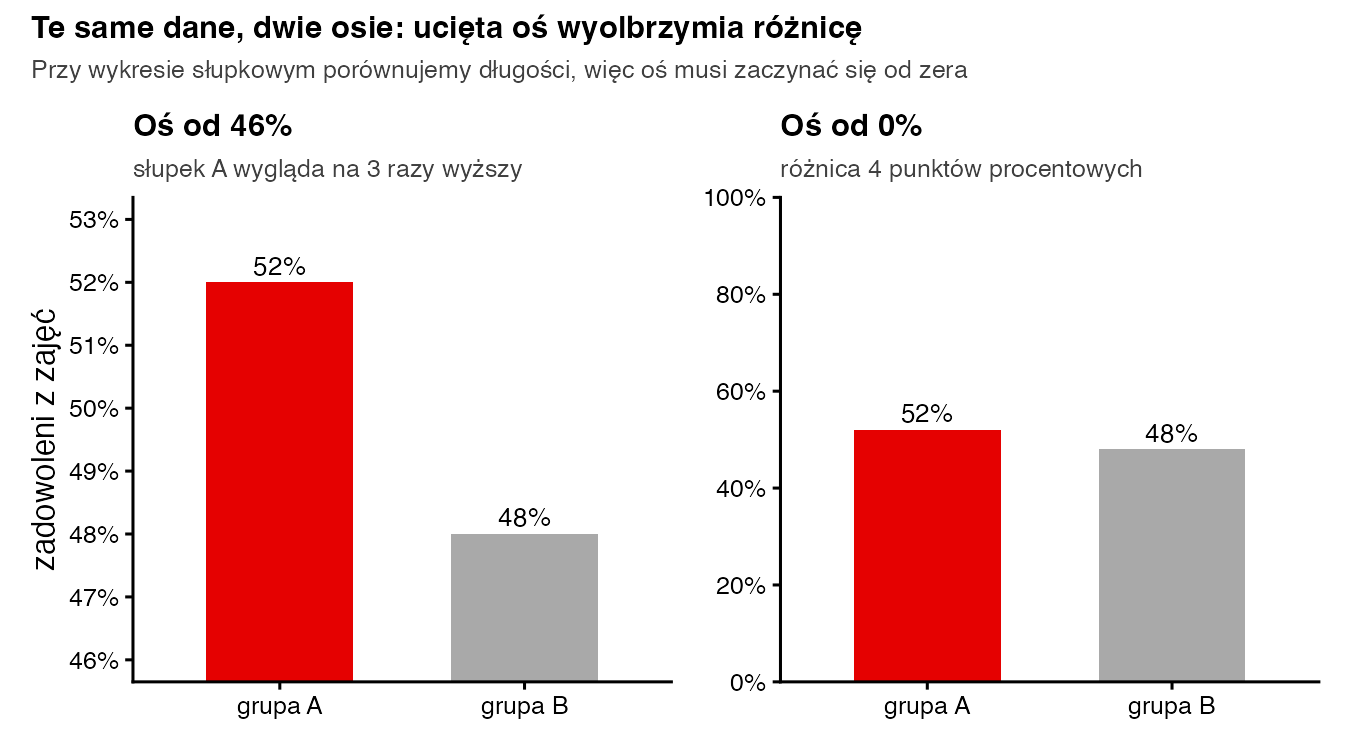
- Ucięta oś. Oś słupków zaczynająca się od 46% zamiast od zera zamienia różnicę 4 punktów procentowych w przepaść (rys. 1).
- Efekt 3D. Perspektywa zniekształca długości i kąty, a trzeci wymiar nie niesie żadnej informacji (Tufte, 2001).
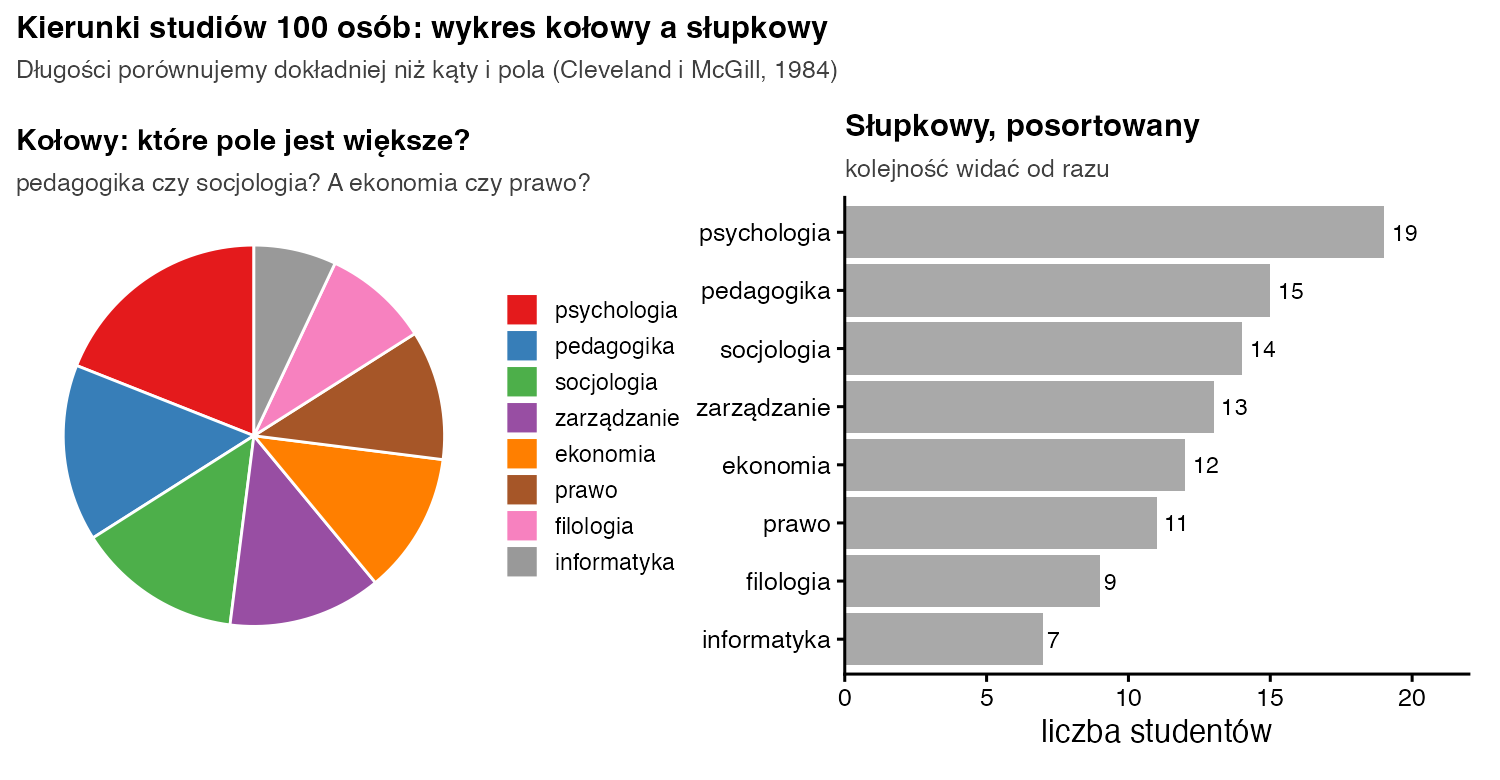
- Wykres kołowy z wieloma kategoriami. Kąty i pola porównujemy dużo gorzej niż długości (Cleveland i McGill, 1984). Powyżej 3–4 kategorii wybierz posortowany wykres słupkowy (rys. 2).
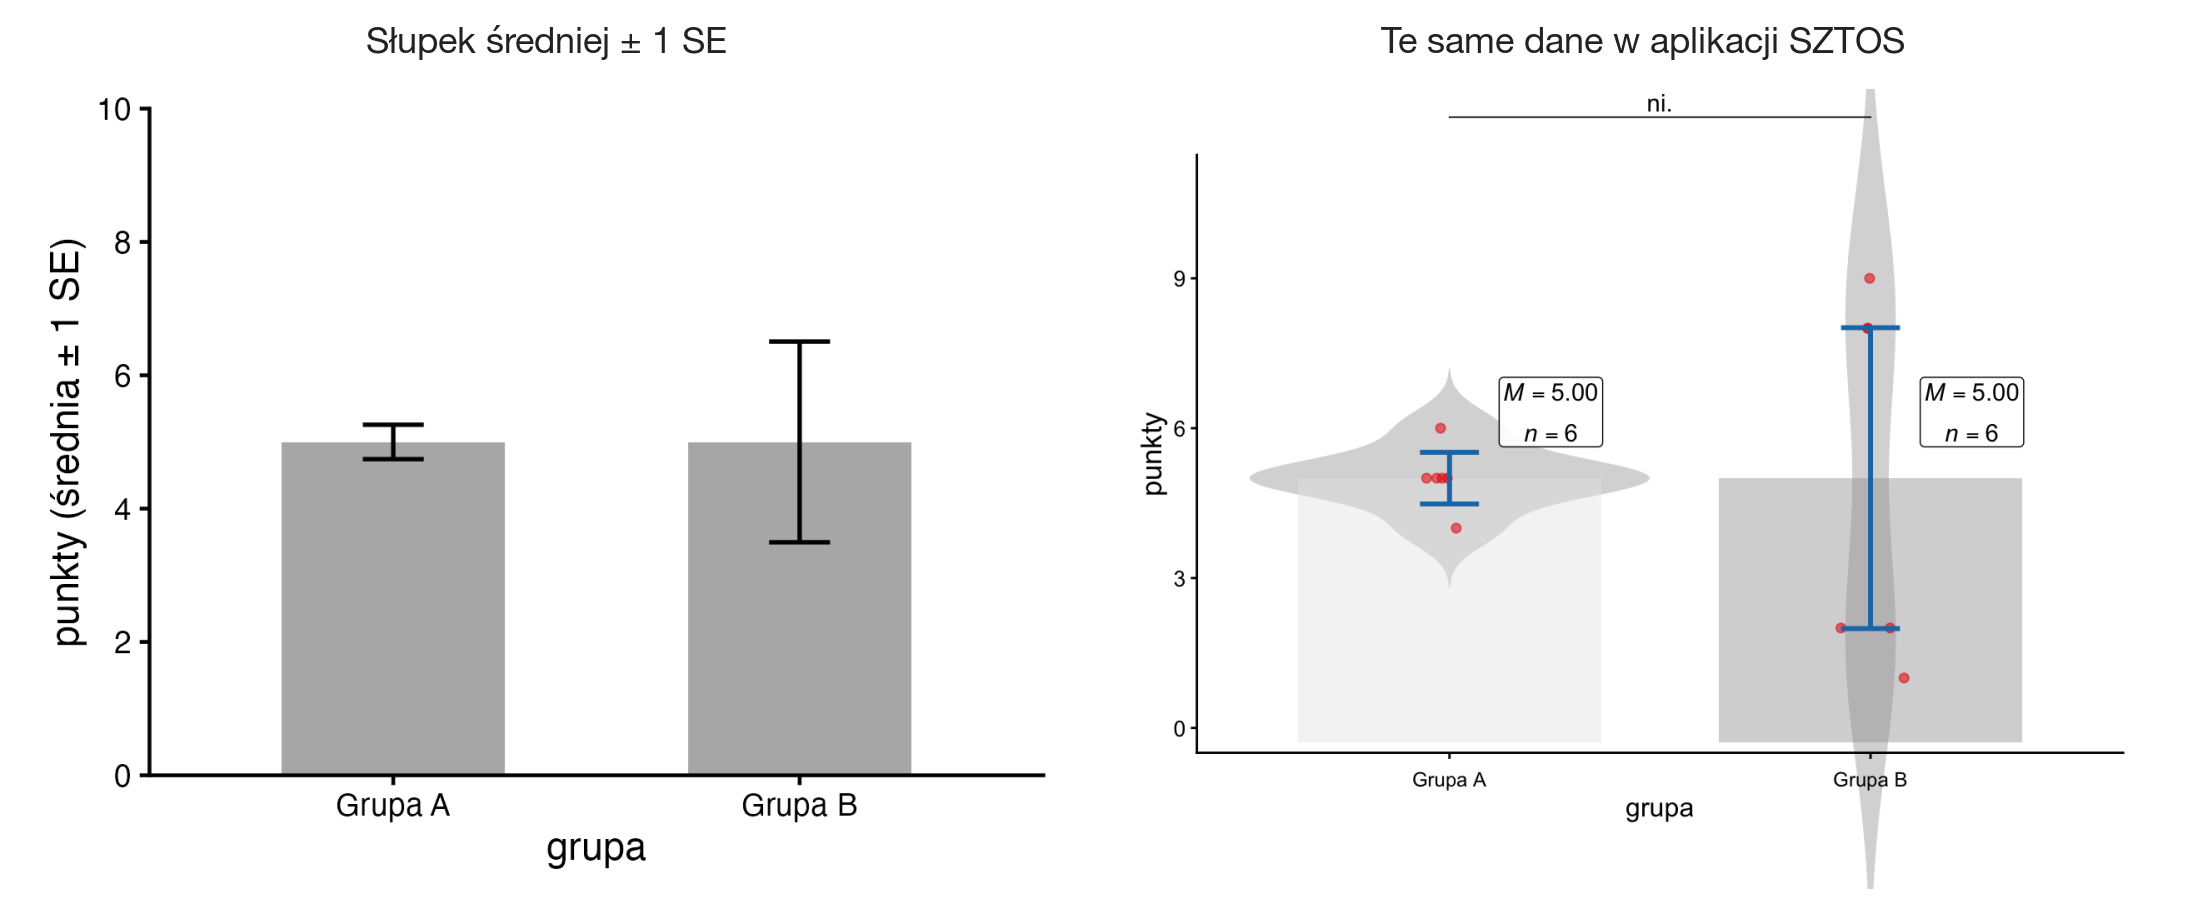
- Słupek średniej z wąsem. Ukrywa rozkład: grupy o tej samej średniej wyglądają podobnie, choć mogą być zupełnie inne (Weissgerber i in., 2015; rys. 3).
- Brak podpisów i jednostek osi, kropka zamiast przecinka dziesiętnego, legenda zasłaniająca dane.
Lista kontrolna przed oddaniem pracy
- Każdy wykres ma podpisane osie z jednostkami, a w podpisie lub legendzie – liczebność (n).
- Kolejność kategorii odpowiada skali (1–5), a przy zmiennych nominalnych – liczebności.
- Kolory są czytelne także w druku czarno-białym, a ten sam kolor oznacza tę samą grupę na wszystkich rysunkach.
- Liczby w tabelach i na wykresach mają przecinek dziesiętny i tyle samo miejsc po przecinku.
- Rysunek z programu (SPSS, R, SZTOS) ma polskie etykiety zamiast nazw zmiennych z pliku.
Jak przygotować tabelę i wykres w R?
library(ggplot2)
ocena <- c(2, 3, 3, 4, 4, 4, 5, 5, 5, 5)          # ocena zajęć (1–5) od 10 studentów

# 1) tabela do pracy: n, %, % skumulowany – wszystkie odpowiedzi, także te bez wskazań
n <- table(factor(ocena, levels = 1:5))
data.frame(n = c(n), proc = c(100 * prop.table(n)), proc_skum = cumsum(100 * prop.table(n)))
c(M = mean(ocena), Me = median(ocena))

# 2) wykres słupkowy: oś od zera, naturalna kolejność odpowiedzi, podpisane osie
wykres <- ggplot(data.frame(ocena = factor(ocena, levels = 1:5)), aes(ocena)) +
  geom_bar(fill = "grey60") +
  scale_x_discrete(drop = FALSE) +
  labs(x = "Ocena zajęć (1 = bardzo źle, 5 = bardzo dobrze)", y = "Liczba studentów") +
  theme_classic()
ggsave("ocena-zajec.png", wykres, width = 5, height = 3.5, dpi = 150)

# 3) grupy: ta sama średnia, zupełnie inne dane – dlatego pokazuj pojedyncze wyniki
d <- data.frame(grupa = rep(c("A", "B"), each = 6), punkty = c(4, 5, 5, 5, 5, 6, 1, 2, 2, 8, 8, 9))
aggregate(punkty ~ grupa, d, function(x) round(c(M = mean(x), SD = sd(x), min = min(x), max = max(x)), 2))
Wynik w konsoli R:
  n proc proc_skum
1 0    0         0
2 1   10        10
3 2   20        30
4 3   30        60
5 4   40       100
 M Me
 4  4
  grupa punkty.M punkty.SD punkty.min punkty.max
1     A     5.00      0.63       4.00       6.00
2     B     5.00      3.69       1.00       9.00
Wykres rysuje pakiet ggplot2 (Wickham, 2016) i zapisuje go do pliku PNG, który wklejasz do pracy. Odchylenie standardowe w grupie B jest prawie sześć razy większe niż w grupie A – tej informacji słupek średniej nie pokazuje.
Jak podpisać tabelę i rysunek w pracy?
Tabele i rysunki numeruj osobno: Tabela 1, Tabela 2, Rysunek 1. Tytuł tabeli umieszczasz nad nią, a podpis rysunku – zgodnie z wymaganiami uczelni, w stylu APA także nad rysunkiem. Każdą tabelę i każdy rysunek przywołaj w tekście („jak pokazuje Tabela 2”) i krótko omów, co z nich wynika. Źródło podajesz wtedy, gdy dane lub rysunek nie pochodzą z Twojego badania.
Bibliografia
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531–554. https://doi.org/10.1080/01621459.1984.10478080
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLoS Biology, 13(4), Article e1002128. https://doi.org/10.1371/journal.pbio.1002128
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer.
- Hryniewicz, K., & Milewska, A. (2023). SZTOS: System Zautomatyzowanego Tworzenia Opisu Statystycznego [Oprogramowanie]. SZTOS IT. https://sztos-it.com/
Zobacz też
- PoradnikAnaliza statystyczna – co to jest
- PoradnikStatystyka dla początkujących
- PoradnikMetody statystyczne – przegląd
- PoradnikStatystyka opisowa – podstawy
- PoradnikTest statystyczny – na czym polega
- Słownik wzorówSłownik wzorów statystycznych – wszystkie hasła
- Przykładowy raportOpis próby
Potrzebujesz pomocy z analizą do pracy dyplomowej?
Policzymy Twoje wyniki, przygotujemy tabele, wykresy i opis w standardzie APA, który wykorzystasz w swojej pracy. Pomagamy jak statystyk i redaktor – autorem pracy zostajesz Ty. Konsultacja i wycena są bezpłatne.